递归自我改进有多远:AI 写了九成代码,选题仍由人定
AI 已经写掉九成代码,却没人把选题交给它。这份综述把"RSI 还有多远"拆成三个必须依次成立的步骤和 18 个可下注的问题。
截至 2026 年 11 月初,AI 是一个很强的研究助理,但研究判断仍然由人提供:在 Anthropic,AI 写了代码库九成以上的贡献,可是决定"做哪个方向"的还是人。公开指标上,过去两年 ECI 前沿每年涨约 14 点,看不出明显的加速;而按 Anthropic、OpenAI 自己的内部指标做朴素外推,AI 大约会在 2027—2028 年接手大部分 AI 研发任务——这和 OpenAI 那句"2028 年 3 月做到自动化 AI 研究者"的目标对得上。
这是 Forecasting Research Institute(FRI)2026 年 11 月 10 日的工作论文的结论。它没有停在"RSI 可能/不可能"的立场上,而是做了三件更硬的事:把实验室的定义、公开基准、内部指标全部摊开;把分歧改写成 18 个有判定标准的预测问题;再拿四个前沿模型的集成打了一组初值。数据截止 2026 年 11 月 3 日。
下面按原文顺序完整编译,表里的数字一个没删。
一、这份报告想回答什么
到 2030 年以前,AI 会有多快变强?方向上有三种:变慢、维持现状、加速。其中最要紧的是加速——因为 AI 在帮着造下一代 AI。国际 AI 安全报告 2026(IASR)写道,"正反馈回路,比如 AI 系统对 AI 研究的贡献,可能加速进展","几十年的进展可能在几年内发生"。这条正反馈回路通常就叫递归自我改进(recursive self-improvement,RSI):AI 系统自动化 AI 研发,进而造出更好的后继系统。
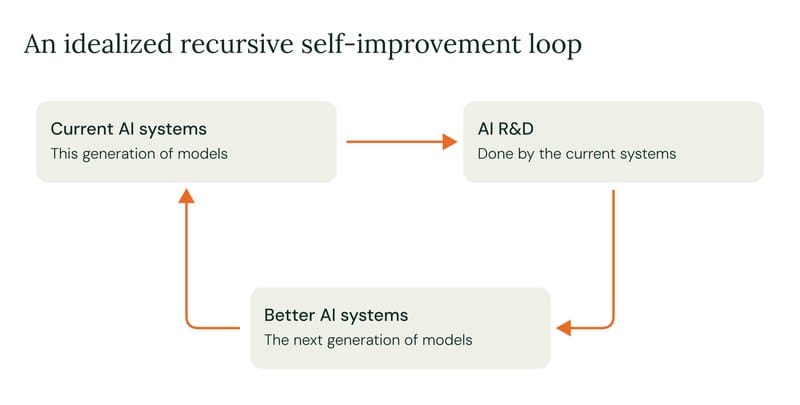
RSI 既可能带来巨大收益,也可能带来巨大风险。2026 年 9 月,Geoffrey Hinton、Yoshua Bengio、OpenAI 首席科学家 Jakub Pachocki、Anthropic 联合创始人 Jack Clark 等人的一份报告认为,RSI 可能把 AI 的收益提前好几年。但人类也可能跟不上能力增长的速度,或对先进 AI 系统失去监督(Chan 等,2026)。
已有的报告大多聚焦 RSI 的风险与政策应对(Chan 等,2026;Sarma 等,2026)。这一份是补充性的、朝前的:汇总当前证据与关键分歧,把分歧变成预测问题,再给出一组来自前沿 LLM 集成的初值。同时,作者正在请一组顶级人类预测者和 AI 专家基于这份文档做预测,后续版本会补上。
全文结构:第 2 节梳理实验室与文献的定义,并给出本文的操作化;第 3 节看证据——实验室自报的内部数据、公开基准与开放式评估、研究者访谈;第 4 节收集已有预测(实验室目标、趋势外推、预测平台、专家与知名个人);第 5 节列关键分歧;第 6 节给预测问题与 LLM 初值;第 7 节总结。
二、先把"RSI"这个词定义清楚
定义 RSI 和"自动化的 AI 研发"本身就很难。尤其 RSI,"有好几种用法,而且常常前后不一致"(Cunningham 等,2026)。
2.1 实验室怎么定义
OpenAI 和 Anthropic 各自从两条路定义:替代(AI 能顶替他们的研究人员)或加速(AI 明显加快 AI 进展的速度)。截至 2026 年 11 月初,两家都没有宣布跨过自己的门槛。
| 测法 | OpenAI(Preparedness Framework v2) | Anthropic(Responsible Scaling Policy v3.4) |
|---|---|---|
| 替代 | Critical:"一个超人的研究科学家 agent";High:"相对于 2024 年的基线,一个表现极佳的中期研究工程师助理" | 模型可以"以有竞争力的成本,完全替代我们全部的研究科学家与研究工程师" |
| 加速 | Critical:"一代模型的提升(例如从 o1 到 o3)只用 2024 年同等进展所需实际时间的 1/5,并持续数月" | 能力进展急剧加速,定义为"(a) AI 总体能力的进步速度翻倍;(b) 这个翻倍在很大程度上可归因于研究与/或工程的自动化" |
| 状态 | GPT-6 Astra"未达到 High 门槛"(系统卡);GPT-6.1 Terra 同样"未达到 High 门槛"(附录 p.33) | 风险"低";研发"加速了,但还没到 2 倍"(2026 年 8 月风险报告) |
两点要注意:
- 两家的定义相似但不相同。加速这一项,OpenAI 的 Critical 是 5 倍,Anthropic 用的是更低的 2 倍阈值。
- 这些阈值是写在安全政策里的,跨过就有直接后果。OpenAI 的 High 要求"满足 High 标准的安全控制",Critical 则要求"在拿出满足 Critical 标准的防护与安全控制之前,停止进一步开发"。Anthropic 的 2025 版政策要求,对可能急剧加速 AI 进展的模型施加 ASL-4 防护;2026 版政策不再要求 ASL-4,但它对全行业的建议是"安全水平大致相当于 RAND SL4",也就是"大概能挡掉领先的网络能力机构的大部分标准操作"。
2.2 文献里的四个词
递归自我改进的念头至少可以追到 I. J. Good(1965)。他描述了一场智能爆炸:机器设计更好的机器,并留下那句名言——"第一台超智能机器,将是人类需要做出的最后一项发明"。
| 术语 | 定义 |
|---|---|
| 自动化 AI 研发 | AI 能"以同等成本,自主做出至少等价于人类研究者的技术改进"(Cunningham 等,2026)。实验室的"替代"测法就是这个定义的变体 |
| 递归自我改进(RSI) | "一个能够完全自主设计与开发自己后继系统的 AI 系统"(Favaro 与 Clark,2026) |
| 自持加速 | "当 AI 系统足以推动 AI 能力进步加速,而无需任何外生投入(人力、训练算力等)增长时"(Cunningham 等,2026)。软件智能爆炸(SIE)很接近:单靠 AI 驱动的软件改进就足以让 AI 进展快速且加速 |
| 智能爆炸 | "一台超智能机器可以设计更好的机器,于是毫无疑问会有一场智能爆炸"(Good,1965);"AI 能力在有限时间内趋于无穷"(Cunningham 等,2026) |
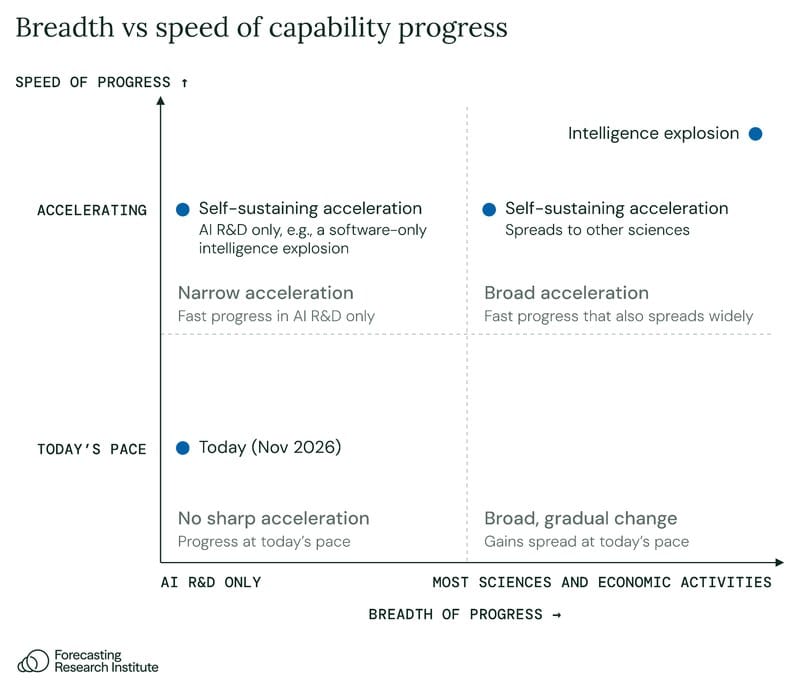
加速可以是窄的(只发生在 AI 研发或容易验证的任务上),也可以是广的(扩散到大多数其他科学和多数经济活动)。Davidson、Hadshar 与 MacAskill(2025)另外定义了"全栈智能爆炸":AI 推动"全部软件、芯片技术与芯片生产"的改进。
三点观察:
- 自动化 AI 研发与 RSI 常被混用——OpenAI 在自己的框架里就把两者等同。但作者认为自动化 AI 研发弱于 RSI:它可以是部分的,AI 做了大部分但不是全部的研发工作。
- 弱反馈回路不一定意味着强反馈回路。自动化 AI 研发可能到来了但能力没加速(被算力等稀缺投入卡住);反过来,也不一定需要完全自动化才能出现加速——在一些标准增长模型里,不完成全自动化也能出现奇点(Aghion、Jones 与 Jones,2019;Jones,2026)。
- 快不等于广。原则上,快可以一直很窄,而广可以发生在慢速进展里。能力加速是留在窄范围还是变广,是关键的预测分歧之一。
2.3 怎么度量"能力进展"
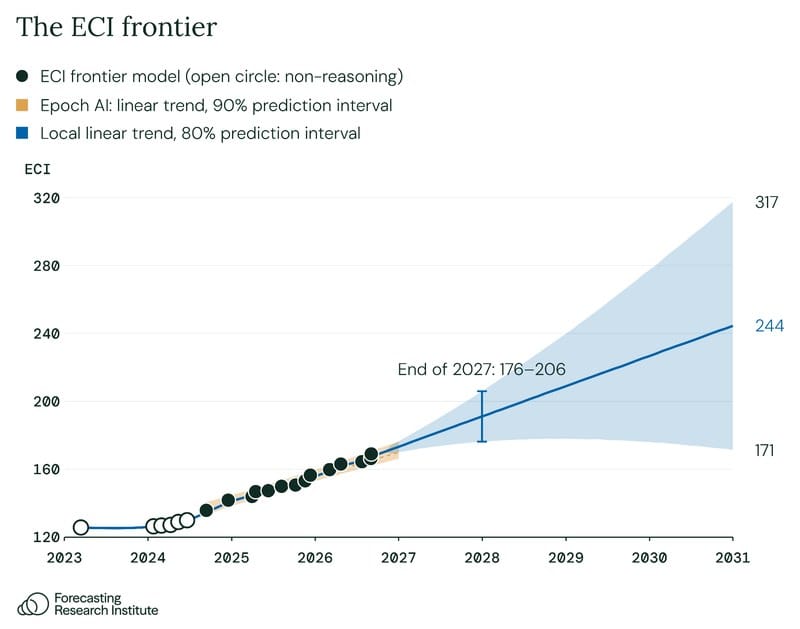
真正关心的是:自动化 AI 研发有没有提高能力进展的速度。度量用 Epoch Capabilities Index(ECI)。作者把"能力加速"操作化成快年(fast year):任何一个 12 个月的窗口里,ECI 前沿上升 30 点以上(大约是 2024 年 9 月以来速度的两倍)。ECI 前沿指某一日期之前、任何已公开模型里的最高 ECI 分数。快年不需要真的等满 12 个月:只要在 12 个月或更短的时间里涨到阈值,问题就判为"是"。
内部预测试里,快年这个问法表现很好:简单易懂;而且内部对"会不会有快年"分歧很大,而这个分歧看起来就是来自对自动化 AI 研发的不同预期。
但快年不等于 RSI,所以问卷也直接问自动化 AI 研发:AI 在没有人介入的情况下能做多少研发工作(AL5,Anthropic 自主性量表的最高级);人类审稿人会怎么给 AI agent 独立写的论文打分(CRUX 2,开放式评估);以及把自动化研发和加速连起来的问题。
ECI 数据。 ECI 前沿在推理模型出现前大约每年涨 6 点,2024 年 9 月推理模型出现后大约每年涨 14 点。对 2027 年 1 月 1 日的新前沿模型,Epoch 的 90% 预测区间是 166—176。为了外推到 2027 年以后,作者拟合了一个局部线性趋势模型(允许进步速度随时间变化,样本里已包含推理模型带来的加速):新前沿模型的 80% 区间,2027 年底是 176—206,2030 年底是 171—317。用这个模型做 20,000 次模拟,出现快年的概率是 2027 年底 17%、2030 年底 44%。
模型里,进步速度每月受一次随机冲击,12 个月内这些冲击会让年速度变化约 10 点(一个标准差)。但数据本身说不准这个值,2 到 20 点/年都能拟合得差不多——在这个范围里,快年概率是 2027 年底 2%—31%、2030 年底 7%—58%。
快年这个定义有五点利弊,原文都列了出来:
- 和实验室的加速测法大致对应。 推理模型出现后 ECI 前沿约每年 +14 点,所以 12 个月涨 30 点大约是今天速度的两倍,接近 Anthropic 的 2 倍测法。参照:过去 12 个月涨了约 18 点(从 151 GPT-5 Pro,2025-10,到 169 GPT-6 Astra,2026-09);至今最大的 12 个月涨幅是 21 点(2024-12 到 2025-12,o1-mini 到 GPT-5.2 Pro)。
- 快年可能没有 RSI。 一项人类发现的创新(比如 2024 年的推理模型)就能造成快年,尽管从今天的速度翻倍意味着更大的绝对跳幅。反过来,RSI 也可能没有快年——如果算力之类瓶颈卡住了。
- 从弹性看,今天还看不到自持加速。 Cunningham 等(2026)用 AI 能力、研究投入、算法进步之间的弹性给出了自持加速的条件,初步校准认为反馈回路还不够强。一个更简单的检验是 ECI 趋势的斜率有没有变大:在他们的设定里,自持加速会让 ECI 趋势向上弯,即使投入固定;而现实中投入还在快速增长,弯折本应更明显——所以 2024 年 9 月以来大致线性的 ECI 趋势,说明今天还没有自持加速。
- ECI 原则上无上限,但对固定基准集实际上是封顶的。 GPT-6 Astra 的 169 分由 24 个基准算出;一个在这些基准上全拿 90% 的模型,ECI 大约是 189,也就是比今天的 ECI 前沿高 20 点,按每年 14 点算是 1.4 年。预测问题里假设 Epoch 会像过去一样继续补充未饱和的基准。
- 只统计公开模型。 实验室可以在内部先跑,之后再发布,甚至不发布。作者对"内部领先公开前沿"的最佳估计是按今天速度约 3—4 个月。两个换算案例:Mythos Preview 在 2026-02-24 内部启用,AECI 161.9 减去 0.9 的偏移约等于 161.0,而当天 ECI 前沿是 GPT-5.2 Pro 的 156.5,领先 4.5 点,约四个月;未发布的"Model 2"在 163.6—169.5 之间,对 2026-07-15 的 ECI 前沿 163.1 领先 0.5—6.4 点,取中值约 3.5 点,约三个月。
三、实验室自己报了什么
实验室报的数据(下表)显示:AI 在 AI 研发里承担的份额已经很大,而且涨得很快。Anthropic 用 Denain、Kwon 与 Ho(2026)的 AL0—AL5 量表给自己的内部研发任务分级:AL0 是没有 AI 参与,AL3 是"协作",AL4 是"主导",AL5 是"AI 完全自主运行、无人在回路"。OpenAI 目前没有对应数据。
| 指标 | OpenAI | Anthropic |
|---|---|---|
| AI 承担的研发工作量 | 2026 年 8 月,每个"人类工作日"对应 3.1 个 agent 工作日,5 月还只有约 0.5 | 2026 年 8 月,Claude 主导(AL4+)26% 的模型研发任务(2 月还不足 1%);至少协作(AL3+)超过 90%。2026 年 8 月内部民调:构建一个 2026 年初的前沿模型,AI 承担的工作量中位数估计 51% |
| AI 写的代码 | 全公司"每个活跃贡献者改动行数":2026 年 7 月是 2025 年前均值的 7.02 倍 | 2026 年 9 月,代码库贡献 90% 以上由 Claude 写;2026 年 7—9 月每位工程师日均代码量是 2024 年的 45 倍以上 |
| 生产力提升 | 2026 年 8 月每个实验者的实验数是历史最高,约为 2025 年的 1.6 倍,但 OpenAI 注明"我们的可用算力自 2025 年以来也显著增长" | 内部调查(n=130)中位数受访者估计,用 Mythos Preview 的产出约为没有任何 AI 模型时的 4 倍;另一项调查里,18 人中有 1 人认为它等价于一个可直接上岗的初级研究员 |
| 实测加速 | 说 agent 工具"正在实质性地加速研究进展",但"度量工作仍然是初步的";GPT-6 Astra 未达"High"门槛 | 内部 AECI 上,Claude Opus 5.5 比历史趋势(约每年 15 点)高约 6.5 点;不清楚这是 Mythos Preview(2026-04)的一次性跳变,还是趋势断裂到 2025 年 9 月以来约每年 22 点。内部度量"没有显示出持续的、可归因于 AI 的 2 倍加速";METR 的初步外部评估估计"由于 AI 带来的总体能力加速约 1.5 倍","有机会到 2 倍的概率约 30%" |
| 内部调试基准 | 内部 Research Debugging Evaluation(41 个真实 bug,加上 6 个对齐审计任务):GPT-6 Astra 78.05%,"低于我们对 High 的指示性阈值" | CoBench v2(449 个真实内部归因问题,筛到 Mythos Preview 至少失败过一次的):Opus 4.6 15.6%、Mythos Preview 54.8%、内部 Model 2 62.8%;而"真正能完全替代 Anthropic 研究人员"的模型至少要 85% |
| 内部 AI 研发基准 | GPT-6 Astra 在四项内部 AI 研发评测上都胜过 GPT-5.6 Sol;相对人类基线,在 PostTrainBench Lite 上填掉了从基座模型到人类差距的约 77%,但在 NanoGPT 上只有人类最高分的约三分之一(约 24% vs 72%) | 在 Anthropic 基于任务的 AI 研发套件里,前沿模型"在大多数任务上超过人类基线" |
| 研究判断力 | 没有直接度量。2026 年 8 月,"高层规划仍然只占 agent 输出 token 的极小部分" | Anthropic 说"Claude 在工程与研究中选择目标时的判断力仍存在很大差距";内部用户反馈 Opus 5.5"主要在测增量想法,偏好不那么宏大的假设";METR 说"我们手上的证据不支持 Opus 5.5 在这些'判断力'技能上比 Fable 5.1 有大改进"。内部调查把弱点列为"品味、验证、指令遵循与认识论"。定量上,TASTE 基准(在两个 AI 安全研究提案里选更好的)最好的模型 Claude Fable 5 与资深研究者一致率 60%(±10 个百分点),而研究者之间估计是 77%,随机是 50% |
| 长任务自主性 | 无人干预的成功率,2026 年 1 月 → 7 月:2—4 小时任务 28%→57%,4—8 小时 18%→53%,8—16 小时 10%→35% | Claude"在 AI 研发工作的任何被测子集上都不是完全自主运行";Claude Code 在开放式问题上的会话成功率一年内从约 26%(2025-08)涨到 91%(2026-09),四个难度档现在都在 88%—92% |
| 每位研究者的推理支出 | 到 2026 年 8 月中,按 API 价格中位数 每天 600 美元以上(2026 年 2 月还接近零);90 分位 每天 7,000 美元以上 | 未披露 |
原文从这堆数字里提炼出五点:
- 在 Anthropic,代码基本是 AI 写的;OpenAI 没报占比,但每个贡献者的代码量是 2025 年前均值的约 7 倍,暗示情况类似。
- 两家的研究者都更能出活了,但自报的生产力容易失真:METR 对 349 名技术工作者的外部调查给出的中位提升是 1.4—2 倍(也是自报),明显低于 Anthropic 员工自报的 4 倍。
- 有内部加速的证据。 除了上面那 6.5 点和"实质性加速",实验室负责人也在说类似的话:Sam Altman 称 AI 对研发的帮助是"递归自我改进的幼体版本"(2025 年 6 月),Dario Amodei 说 RSI"正在全行业开始发生"(2026 年 9 月),Jack Clark 说"今年我们获得了令人信服的证据,说明它已经开始"(2026 年 10 月);Anthropic 的招股书写"每一个新版本的 Claude 都直接加速了下个版本的开发"。但投入增长解释了一部分超趋势结果:Anthropic 员工数从 2024 年底约 940 人涨到 2026 年 9 月 30 日的约 5,300 人,2026 年二季度算力与基础设施开支同比增长 300%。
- Google DeepMind 看到类似现象但给出另一种解释。 在他们自己的 GCI 上,Gemini 4 Argon 也高于趋势,但他们怀疑这是"组织投入增加、训练算力相对历史趋势增长"所致,"而不是 AI 驱动的加速";另外 DeepMind 的生产代码已经"超过 75% 由 AI 写",但完全委托出去的 PR 在 2026 年 9 月只占 11.9%。
- 判断力的证据有限,但指向重要缺口。 基准考的是定义清楚、可验证的任务,不是判断力;而且任务越长成功率越低(OpenAI 2—4 小时 57%,8—16 小时 35%)。RAND 对公开证据的综述得到类似结论:"没有任何已披露的系统会自己定研究议程、把开放式研究持续数周,或设计自己的后继者"(Sarma 等,2026)。
- 顺带算一笔账:OpenAI 中位研究者的每天 600 美元,按 250 个工作日算是约 15 万美元/年;90 分位的每天 7,000 美元以上,对应约 175 万美元/年(API 价格很可能高估了 OpenAI 自己的成本)。
四、公开证据
这一节看四个公开基准和一项开放式评估。
其中两个测端到端的机器学习工作:PostTrainBench 和 WeirdML——Epoch 的基准审查都给到"Verified"("可以大致按其描述来理解")。另两个试图直接隔离研究品味:TasteVal 测模型设计与解读实验的能力,Epoch 的 InnovationEval 问 agent 能不能重新发明一项它没见过的 ML 创新。Epoch 给 TasteVal 的评级是"信息不足",很可能因为它不公开任务;Epoch 不审查自家的 InnovationEval 以避免利益冲突。
最后 CRUX 2(2026 年 7 月)不是基准而是开放式评估:agent 在一个开放问题上做完整的研究项目,没有固定任务也没有自动打分,由人类专家给产出的论文评分。
| 基准 | 测什么、人类基线 | 当前前沿 |
|---|---|---|
| PostTrainBench v1.1 | agent 能否干完实验室后训练团队的活:把一个原始预训练模型变成一个有用的助手。给定四个小基座模型、一张 H100、10 小时;分数是产物在基准上的加权平均。人类基线:各实验室官方 instruct 模型(自家团队后训练)得 51.1 | v1.1 上,Locus(Opus 5 上的外部脚手架,2026-09 提交)45.6,Claude Fable 5(2026-06)41.8,而 Claude Sonnet 4.5(2025-09)是 9.9 |
| WeirdML v3 | agent 能否为没见过的小而怪的问题搭出可用的 ML 模型。11 个手作任务;分数是归一化表现(0—100);没有人类基线 | GPT-6 Astra 42.2(2026-09),GPT-5.6 Sol 是 15.0(2026-07),Claude Opus 4.5 是 6.5(2025-11) |
| TasteVal | 模型能否像人类专家一样选择和解读实验。8 个未公开的 AI 研发任务(数据整理、预训练、微调等);被测模型只设计实验并解读结果,执行交给固定的编码 agent。分数 = 达到同样测试分数所需实验算力比人类基线少多少倍。人类基线 = 每个任务至少两位专家里最好的(来自 OpenAI、Google DeepMind 等 24 位专家) | Claude Opus 5.5(2026-09)用少 2.3 倍的算力(95% CI 1.15—4.37)达到专家分数,最终分还略高(1.14 vs 1.00);Claude Opus 4.8(2026-05)是 0.84 倍 |
| InnovationEval | agent 能否发明一项它没见过的已知 ML 创新。给 Qwen3-8B、数据集和 GRPO(后训练用的强化学习方法)代码库,要求它想出更好的后训练方法。分数 = 在 SDPO 相对 GRPO 的已发表增益里拿到多少(0% = GRPO,100% = 原论文结果) | GPT-5.6 Sol(2026-07)15%,Claude Fable 5(2026-06)2%;GPT-6 Astra(2026-09)拿到 63%,但很可能记住了原论文 |
| CRUX 2(开放式评估) | agent 能否做完一个真实的开放研究项目。给一个未发表 AI 论文的研究问题(不给论文)、约一周时间、API 预算与 GPU 额度,要写出一篇投顶会的论文。原作者按 NeurIPS 1—6 分打分(4 分是"边缘接收",6 分是"强接收") | 原始研究(2026-07):OpenClaw 脚手架里的 Claude Opus 4.8,得分 2(拒稿)与 1(强拒);后续(2026-10):Codex 里的 GPT-6 Astra、Claude Code 里的 Claude Fable 5.1,各配最高推理强度,得分仍是 2 与 1 |
公开证据的四点小结:
- 在两个端到端 ML 基准上,模型表现不错——因为这两个基准按构造就是定义清楚、可验证的任务。PostTrainBench 上最好的 agent 用一张 GPU 跑 10 小时,把小模型带到实验室官方 instruct 模型的约 89%(51.1 分基线下 45.6 分);但 Epoch 的审查提醒,agent 可以"靠窄化地过拟合那一个评测"拿高分。这和 Anthropic 说的自家任务型 AI 研发评测"已经饱和"一致。
- 两个研究品味基准指向不同方向。 TasteVal 的小型可验证任务上,Opus 5.5 用少 2.3 倍算力追平专家,而这个倍数自 2025 年 12 月起大约每三个月翻一倍;但 InnovationEval 上,agent 只回收了未见创新的 2%—15%。TasteVal 不测"选什么问题",InnovationEval 只基于一项创新。
- CRUX 2 的两篇论文都被拒。 该研究结论是"今天的 agent 能做 AI 研究的工程部分,但在研究生命周期的关键环节上吃力",后续用更新的模型、更多时间与更大预算重做,仍然是两篇拒稿;作者看到"实验设计与资源管理有明显改进,但创造性解题、判断、校准与沟通上仍有持续局限"。
- 基准之外,公开的发现记录本身是加速的证据。 METR 2026 年 8 月的笔记发现,2026 年漏洞发现"急剧加速"、数学结果"有所加速";但"整体算法优化的公开记录还没有显示出可察觉的加速"(Cunningham 与 Rush,2026)。此后数学的发现速度看起来又快了一档:OpenAI 声称解决了千禧年问题 Navier–Stokes(2026-09);10 月 6 日发布数百个开放数学问题的结果,计算机科学家 Scott Aaronson 说那是"数学史上最大的日子之一";10 月 26 日声称拿下第二个千禧年问题 Yang–Mills 的一半(存在性,不含质量间隙),以及否证指数时间假设(ETH)。
五、定性证据:25 位研究者怎么说
Epoch 早前的访谈问了 8 位 AI 研究者关于自动化的问题:规划研究很重要但"花的时间相对少",编码与调试"更耗时";8 人都同意"未来五年工程任务会是研发自动化的主要驱动",他们的描述暗示这"可以自动化掉他们当前一半以上的工作"。
Severin Field、Raymond Douglas 与 David Krueger(2026 年 8 月 13 日)访谈了 OpenAI、Anthropic、Google DeepMind、Meta、普林斯顿、UC Berkeley 与斯坦福的 25 位研究者:
- 20/25 把自动化 AI 研发列为最严重、最紧迫的风险之一;18/25 说它放大了其他风险("它只是让其他威胁模型跑得更快")。
- 明确谈到规模趋势会不会延续的 21 人里,12 人预期会一直延续到 AI 能达到人类 AI 研究者的劳动水平。
- 16/25 在某个时刻对正反馈(也就是 RSI 里"递归"那一半)表示怀疑。怀疑者说 RSI 需要"一次渐进改进本身不会带来的能力突变",比如记忆、创造力、或分辨真假假设上的突破;相信的人则引用 METR 的时间跨度、缩放定律,以及他们在实验室内部的体感。
- 谈到部署的 20 人里,一半预期最强的模型会留在内部。
六、已有的预测
6.1 实验室自己的目标
| 实验室 | 目标 | 状态 |
|---|---|---|
| OpenAI | 2026 年 9 月实现"自动化研究实习生",2028 年 3 月实现"自动化 AI 研究者" | 称实习生目标"按我们的度量已经达到"(2026-09-06) |
| Anthropic | "最早 2027 年初就有可能"让 AI"完全自动化、或以其他方式急剧加速大型顶级人类研究团队的工作",领域包括"AI 本身" | 按 Dario Amodei 的说法,RSI"正在全行业开始发生" |
Anthropic 在 2026 年 11 月 2 日的修订招股书里写,公司"可能即将满足其 RSP 对'可归因于 AI 的急剧加速进展'的定义"。2026 年 8 月的内部民调中,员工对"AI 在建一个 2026 年初前沿模型的工作中占多少"的中位预期是:2027 年底 80%、2030 年底 95%,而当时的中位数是 51%。
6.2 趋势外推
如果被测序列就按当前趋势走,大多数"自动化研发"里程碑落在 2027—2028 年。作者的依据是 Peter Wildeford 做的一个自动化仪表盘:
| 序列 | 里程碑 | 中位与 80% 区间 |
|---|---|---|
| Anthropic R&D Automation Index | 90% 任务完全自主(AL5) | 2028 年 5 月(2027-08 至 2029-10) |
| Anthropic CoBench | 85%(Anthropic 内部替代参考线) | 2027 年 6 月(2027-01 至 2029-03) |
| METR 50% 时间跨度 | 174 小时(一个工作月) | 2027 年 6 月(2027-01 至 2028-08) |
| OpenAI 实验速度 | 2025 年水平的 10 倍 | 2028 年 2 月(2027-05 至 2029-08) |
注:AL5 在 Anthropic 目前是 0%。为外推这个指标,仪表盘假设 AL5 落后 AL4+ 一段滞后期(由更低层级之间的实测间隔推断),不确定性很大。
6.3 各种预测
"完全自动化 AI 研发"的中心估计散布极广,从 2027 年到 2052 年。最早的来自实验室内部人士与 AI Futures 的预测者,最晚的来自 AI Impacts 调查的 ML 研究者。
预测平台(截至 2026-11-03):
| 问题 | 平台 | 预测 | 参与量 |
|---|---|---|---|
| 弱通用 AI / 通用 AI 宣布 | Metaculus | 中位 2027 年 8 月 / 2030 年 9 月 | 1,800 / 1,900 |
| 2028 年前出现 AI 撰写的 NeurIPS/ICML/ICLR 论文 | Metaculus | 85% | 135 |
| Anthropic 达到 ASL-4 | Metaculus | 中位 2028 年 5 月 | 13 |
| OpenAI 在 2027 / 2028 / 2030 前宣布 AGI | Kalshi | 3.5% / 45% / 71% | 合计 110 万美元 |
| OpenAI 或 Anthropic 在 2026-12-31 前宣布 RSI | Polymarket | 9% | 该合约 5,000 美元 |
| OpenAI 或 Anthropic 在 2026 / 2027 / 2028 前宣布 RSI | Kalshi | 11% / 57% / 77% | 合计 2,100 美元 |
预测者对 AI 研发是看多的,但既开放又有流动性的相关问题很少。两个 RSI 市场对"2026 年底前宣布"只给 9%(Polymarket)和 11%(Kalshi),而且两个盘子都极薄。
LLM 预测:FutureSearch。 其 RSI 预测集含 57 条 LLM 预测(2026-10-16 更新)。三个与本报告最接近的:实验室宣布某模型已跨过或在下一代跨过自动化研发门槛,中位 2027 年 12 月(80% 区间 2027-02 至 2031-01);对 2029 自然年 ECI 最高分涨幅的中位预测是 16 点(80% 区间 9.5—28.5),接近今天每年约 14 点;对 Anthropic 今天的 AI 研发提升给 1.5 倍(80% 区间 1.25—2),和 METR 的初步估计一致。
专家与超级预测者调查。 在一项与 METR 合作的试点研究里,作者于 2024 年 11 月至 2025 年 2 月调查了 8 位 AI 预测专家与 10 位超级预测者。主结果是"3 倍加速":2029 年前出现一个两年期,其有效算力增长相当于 2018—2024 那六年。
| 预测 | 专家(中位) | 超级预测者(中位) |
|---|---|---|
| 3 倍加速(主结果) | 20% | 8% |
| 顶级研究者替代:2027 年 1 月,知情者几乎一致同意"AI 系统可以在 AI 研发上完全替代一位 2024 年的顶级(前 0.01%)AI 研究者" | 5.5% | 20% |
| 月级项目:2027 年初,AI 在 80% 的开放式月级 ML 项目上击败五人团队,且资源少用 20% | 31.5% | 45% |
按作者读法,"月级项目"这条接近判"否"。这个场景需要 2027 年初就有一个多月(174 小时)的 50% 时间跨度;按 Epoch 的经验法则,"ECI 涨 5 点大致对应 METR 时间跨度翻倍",一个月的跨度比 GPT-5(ECI 150,约 3.6 小时)高出约 5.6 个翻倍,即 ECI 约 178,按趋势要到 2027 年中期才到。"顶级研究者替代"在 2027 年 1 月前看也不像会发生。
另有一项专家调查:AI Impacts 在 2024 年 12 月调查顶级 AI 会议作者(1,580 人,10% 回复率),对"AI 完全自动化 AI 研究者这份工作"的中位日期是 2052 年(n=458)。当被要求评价"智能爆炸论证"(如果 AI 做掉几乎所有研发,技术进展可能"比现在快一个数量级以上"),回答分裂:28% 认为可能或很可能,23% 认为五五开,49% 认为不太可能或很不可能。
知名个人的预测。(原作者注:数据截止于 11 月 3 日之后 METR 才发布那份加速报告,此后几位预测者缩短了时间线;例如 AI Futures Project 最新更新的所有作者现在都预测 2027 年出现超人 AI 研究者(假设没有刻意减速),因此下表中部分数字已过时——AI Futures 的三位与 Ryan Greenblatt 大概率已不适用。作者计划在下一版更新。)
| 人物 | 完全自动化 AI 研发(中心估计,作者读法) | 原话/预测 |
|---|---|---|
| AI 2027(Daniel Kokotajlo、Eli Lifland、Thomas Larsen、Romeo Dean,AI Futures Project) | 2027(情景) | 超人编码者 2027 年 3 月,超人 AI 研究者 2027 年 8 月 |
| Leopold Aschenbrenner(Situational Awareness) | 2027 | "到 2027 年,模型能做 AI 研究者/工程师的工作,这惊人地可信" |
| Jack Clark(Anthropic 联合创始人、Anthropic Institute 负责人) | 2027 | "我现在认为 2027 年出现完整 RSI 更可能";2026 年 5 月时给的是 2027 年 30%、"2028 年底前出现无人类参与的 AI 研发"60%+ |
| Dario Amodei(Anthropic CEO) | 2027—2028 | AI 反馈回路"可能只差 1—2 年就到这一代 AI 自主构建下一代的程度";RSI"正在全行业开始发生" |
| Daniel Kokotajlo | 2028 年底 | AI 做"整个研究流程":"2028 年底前约 50%";自动化编码者中位 2027 年 11 月(80% 区间 2027-01 至 2030-04) |
| Ryan Greenblatt(METR) | 2030—2031 | 2028 年底前完全自动化"略低于 30%"(此前约 15%);AI 研发打平人类的中位在 2031 年初;后来改口"完全自动化大概在 2031、2030 年左右" |
| Eli Lifland(AI Futures Project) | 2030 之后 | 自动化编码者中位 2030 年 1 月(80% 区间 2027-06 至 2070-10);超智能中位 2033 年 7 月 |
| Andrej Karpathy | 约 2035(能当员工/实习生用的 agent) | AI agent 应该"几乎像一个你雇来的员工或实习生"那样工作,但"它们的认知能力还不够,就是跑不起来。把这些问题都解决大约要十年" |
| Ilya Sutskever | 2030—2045 | 被问到"能像人一样学习的 AI"何时"超越人类":"我想大概 5 到 20 年" |
| Toby Ord | 约 2038(变革性 AI) | 变革性 AI("让科学与技术进展速度翻倍"):"中位 2038 年,80% 区间从 3 年到 100 年";未来五年内"大约五分之一" |
| Arvind Narayanan 与 Sayash Kapoor(《AI as Normal Technology》) | 不给日期;渐进,不是近期 | "更可能出现的是自动化在 AI 开发中的角色逐步上升,而不是某个单一、不连续的 RSI 时刻" |
七、三个关键分歧
通过自动化 AI 研发实现广泛加速,需要三个有争议的步骤依次成立:1)AI 研发被自动化;2)自动化带来能力急剧加速;3)加速是广的。作者把这个结构画成一张图,并给出四类可能结局(从"只是更强的研究助理"到"广泛加速")。
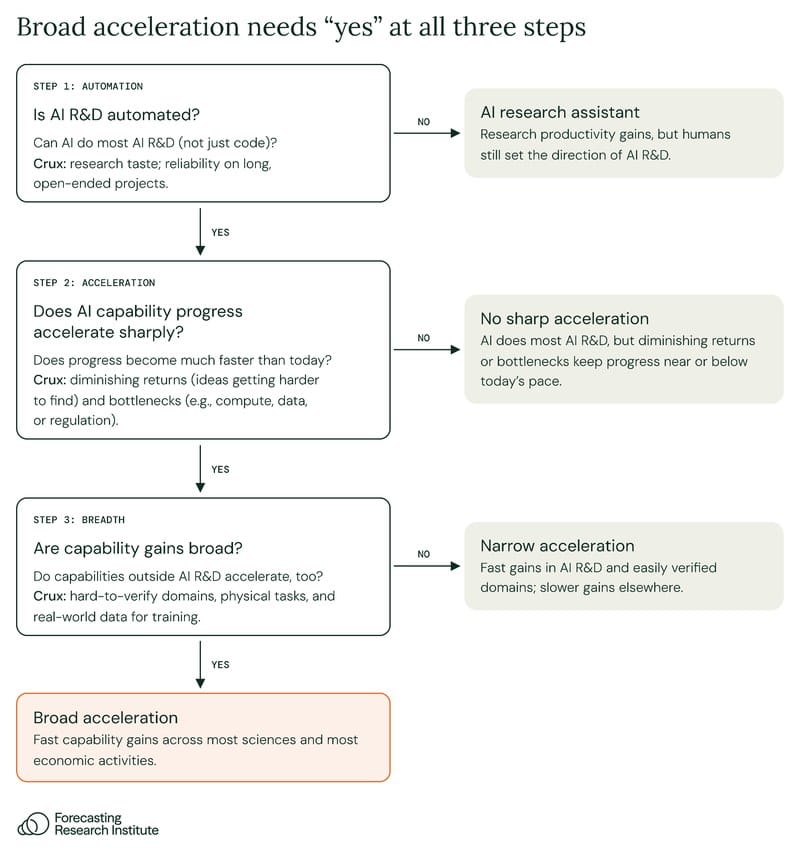
| 步骤 | 主要分歧 | "会"的一方 | "不会"的一方 |
|---|---|---|---|
| 1. AI 研发被自动化了吗 | AI 能提供研究品味与判断(选题、判断结果),还是只能做实现?能不能在长、开放的项目上保持可靠? | "我不太认同 AI 会缺某种深刻洞察这个说法";ML"比数学浅"(Ryan Greenblatt);如果 AI 能"创造性地解决问题从而在科学上成功",那就是它能"泛化到许多领域、当然也包括 AI 研究本身"的标志(Jack Clark) | "就算你能让 AI 做任何实验,你还是得决定做什么实验。现在 AI 相比写实验代码,这方面很差"(Beren Millidge);定义目标是"人类最后的工作"(John Schulman);"创造力,以及智力的其他维度,是不可验证任务的极致"(Arvind Narayanan) |
| 2. 如果研发被自动化,能力会急剧加速吗 | 会带来软件智能爆炸,还是边际收益递减("想法越来越难找")以及算力、数据、监管瓶颈会封顶? | 即使"硬件保持不变",软件智能爆炸也"至少相当可能"(Daniel Eth 与 Tom Davidson);"一年里走完四五年的 AI 进展"(Ryan Greenblatt);关于数据瓶颈,"如果它让智能爆炸多花 2 倍以上时间,我会意外"(Tom Davidson) | 反馈回路"目前还不够强,无法产生自持加速,虽然看起来在增强"(Cunningham 等);回路"大约要强 5—10 倍才能自我维持"(Ramez Naam,假设 ECI 每点带来 2—3% 研发生产力提升,而 Cunningham 等是 9%);"政治与社会障碍可能让它半路停住" |
第三步(加速是否变广)的分歧同样尖锐:一边是 Amodei 说的"把人类生物学家未来 50—100 年的进展压缩到 5—10 年",另一边是"自动化 AI 研发不会迅速产出领域通用的超级智能"、"奇点会被信号瓶颈卡住"、"构建与部署强大 AI 的外部瓶颈无法靠改进技术设计来克服"。
八、18 个预测问题,和 LLM 给出的初值
作者把分歧拆成 18 个问题,分五组,分别对应上面三个步骤:第 1 组问 AI 自己做多少研发、agent 做开放式研究有多好;第 2 组问 ECI 前沿涨多快;第 3 组问会不会有快年、有的话是不是 AI 自动化研发造成的;第 4 组问实验室内部最强模型领先公开前沿多少;第 5 组问快年会不会改变 2050 年前"专家级 AGI"与"AI 灾难"的概率。
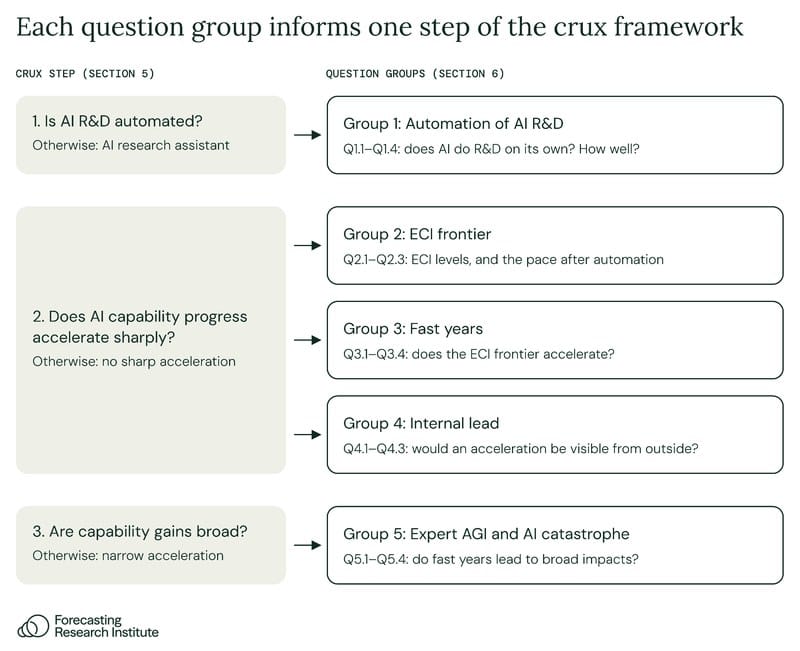
这些问题在内部测试里表现不错:它们抓住了真实分歧,而分歧的理由正好沿着第 5 节的三步走。2026 年 10 月的内部调查(n=11)里,成员对"2030 年底前出现快年"给出的概率从 8% 到 75%;另一项调查(n=4)里,所有人都认为如果 2030 年前出现快年,2050 年前专家级 AGI 与 AI 灾难的概率都更高。
| ID | 问题(简写) | LLM 集成初值 |
|---|---|---|
| Q1.1 | 领先 AI 公司由 AI 完全自主(AL5)完成的研发工作占比,2027-12-31 | 8.3%(80% 区间 0.9—34.5%) |
| Q1.2 | 同上,2030-12-31 | 41.2%(5.6—87.2%) |
| Q1.3 | 2027-12-31 启动的 CRUX 2 复跑,最优 agent 论文的平均 NeurIPS 分(1—6) | 2.8(1.6—4.1) |
| Q1.4 | 2030 年底前两个里程碑同时达成:AL5 占比 >50%,且 CRUX 2 复跑均分 ≥4 | 32.7% |
| Q2.1 | ECI 前沿,2027-12-31 | 187.9(179.5—201.4) |
| Q2.2 | ECI 前沿,2030-12-31 | 240.3(208.1—303.9) |
| Q2.3 | 若 Q1.4 达成,之后 12 个月的 ECI 前沿涨幅 | 33.1(13.1—89.0) |
| Q3.1 | 2027 年底前出现快年(12 个月 +30 点) | 10% |
| Q3.2 | 2030 年底前出现快年 | 39.6% |
| Q3.3 | 若出现快年,快年之后 12 个月的 ECI 前沿涨幅 | 29.8(11.2—76.3) |
| Q3.4 | 若出现快年,它由 AI 自动化 AI 研发造成的概率 | 69.6% |
| Q4.1 | 内部领先公开 ECI 前沿多少(2027-12-31) | 6.4(1.6—16.6) |
| Q4.2 | 同上,2030-12-31 | 10.1(2.2—40.3) |
| Q4.3 | 若 Q1.4 达成,之后 12 个月的内部领先 | 16.5(3.8—61.2) |
| Q5.1 | 若有快年,2050 年前专家级 AGI | 84.3% |
| Q5.2 | 若无快年,2050 年前专家级 AGI | 55.7% |
| Q5.3 | 若有快年,2050 年前出现 AI 灾难 | 8.4% |
| Q5.4 | 若无快年,2050 年前出现 AI 灾难 | 2.9% |
方法。 四个前沿模型的集成(Claude Opus 5.5、Claude Sonnet 5.5、Claude Fable 5.1、GPT-6 Astra)在 2026 年 10 月 29 日对各题做了预测,每题各自做网络检索、用五种不同提示各答一遍;每个模型的五次要平均,集成值是四个模型均值的中位数。用来生成这些预测的是他们做"自动化 AI 风险展望(AIRO)"的预测流水线。模型只拿到问题,没拿到这份文档。
结果。 集成认为 AI 很快会做掉更多研发,但不是全部:AL5 占比中位在 2027 年底是 8.3%(今天 Anthropic 没有任何一段研发工作是 AL5),2030 年底 41.2%;CRUX 2 复跑中位 2.8 分,低于"边缘接收"的 4 分,但高于实际拿到的 1—2 分;两个里程碑同时达成的概率 32.7%。
ECI 前沿的中位预测接近趋势线:2027 年底 187.9、2030 年底 240.3,都落在趋势模型的 80% 区间内。快年概率是 2027 年底 10%、2030 年底 39.6%,比趋势模型(17%、44%)略低。四个模型在这道题上分歧很大:2030 年底出现快年的概率从 35%(Claude Sonnet 5.5)到接近 56%(GPT-6 Astra)。
集成还认为内部与外部的差距会扩大:内部领先从今天约 3.5—4.5 点涨到 2027 年底 6.4 点、2030 年底 10.1 点,80% 区间宽到 40 点——因为公司可能把最好的模型留在内部。
最有意思的是跨题联动:如果 2030 年前出现快年,集成就把 2050 年前专家级 AGI 给到 84.3%、AI 灾难 8.4%;如果没有快年,分别是 55.7% 与 2.9%——也就是说,条件是"有快年"时,AI 灾难的概率几乎高出 3 倍。作为对比,他们"纵向专家 AI 小组(LEAP)"的中位专家给 2050 年前 AI 灾难 2%,给 2100 年前 AGI 80%(时间跨度长得多)。
作者自己强调这组数字"主要是示意性的",人类预测者的结果还在收;但他们在 ForecastBench 上的经验是,现在有几个 LLM 已经与超级预测者统计上难以区分,且能力更强的模型在罕见事件上更准——所以这组初值可以当作一个信息量不错的基准线。
九、原文的七条结论
- 截至 2026 年 11 月初,AI 是高度能干的研究助理,但仍缺研究判断力。 Anthropic 代码库九成以上的贡献由 AI 写(2026-09),但做哪个研究方向仍由人决定。关于 AI 判断力的证据有限且多为定性,但指向重要缺口。
- 公开指标上,能力进展还没有明确加速。 ECI 前沿过去两年每年涨约 14 点,至今最大的 12 个月涨幅是 21 点。但 2026 年的发现速度看起来在加快:漏洞发现"急剧"(METR),数学越来越明显。
- 前沿公司内部有加速的迹象。 METR 的初步外部评估估计 Anthropic 内部"由 AI 带来的总体能力加速约 1.5 倍",Altman 与 Amodei 都在描述早期 RSI 的迹象。
- 原文特别加的一条事后说明:数据截止(11 月 3 日)之后,METR 发布报告估计 Anthropic 的能力进展约为此前速度的 2 倍(区间 1.3—3 倍),其中约 80% 归因于 AI;这个估计只针对 Anthropic,且包含未发布模型。如果这个速度保持并传导到公开模型,就大致相当于一个"快年"。 本文的 LLM 预测是在 10 月 29 日做的,早于 METR 那份报告。
- 按趋势外推,AI 可能在 2027—2028 年接手大部分 AI 研发任务,与 OpenAI"2028 年 3 月"的目标一致;但其他预测的中心估计从 2027 年(实验室内部与 AI Futures)到 2052 年(AI Impacts 的 ML 研究者调查)都有。
- 广泛加速需要三步依次成立:自动化、加速、广度。 分歧点分别是:AI 会不会长出研究判断力;边际收益递减与算力/数据/监管瓶颈会不会封顶;收益会不会扩散到 AI 研发与易验证任务之外。
- 前沿 LLM 集成给"2030 年底前出现快年"约 40%;一旦出现,约 70% 归因于 AI 自动化研发;出现快年还会把集成对专家级 AGI 的预测从 56% 抬到 84%,把 AI 灾难的预测从 2.9% 抬到 8.4%(约 3 倍)。
十、我们的整理:这份综述怎么用
第一,把它当成三段式证据链,而不是一个日期。 报告最实用的地方是把"RSI 什么时候来"拆成三个必须依次成立的步骤。你会看到不同人的分歧其实落在不同的步骤上:Greenblatt 主要在争第一步(判断力能不能长出来),Cunningham 等争第二步(弹性够不够),Narayanan 与 Kapoor 争第三步(会不会变广)。引用"某某说 2027 年"时,先问他说的是哪一步。
第二,把"快年"这个定义抄走。 12 个月里 ECI 前沿涨 30 点(约当前速度的两倍),这是个可以被证伪、也可以被跟踪的判据,比"RSI 到没到"清楚得多。它还有一个隐性的好处:逼你注意基准饱和——一个今天 24 个基准全拿 90% 的模型,ECI 也只到约 189,也就是 1.4 年的进度;换句话说,没有持续补充未饱和基准的话,"一年涨 30 点"很快就会变成不可达。
第三,跟本博客此前那篇 METR 报告 对着读。 时间线是这样的:这篇综述的数据截止 11 月 3 日;METR 11 月 5 日发布对 Anthropic 的评估,给出 1.9 倍(95% CI 1.5—2.8 倍)与"加速过半可归因于 AI 做研发";综述在第七节加了一条事后说明,承认"如果这个速度传导到公开模型,就大致相当于一个快年"。这也是为什么 11 月之后一批预测者把时间线往前挪了。两篇的差别不在事实,而在口径:METR 量的是实验室内部(含未发布模型),综述量的是公开前沿与可下注的问题。
第四,对工程团队的三条实际含义:
- "AI 写了 90% 代码"不是 RSI 的证据。 同一份文档里,DeepMind 生产代码 75% 以上由 AI 写,但完全委托的 PR 只有 11.9%;Anthropic 的 AL4+(AI 主导)占 26%,AL5(完全自主)是 0%。判断力、把长任务跑完、以及在开放式问题上不跑偏,是三道没过去的坎。
- 要测的东西得往"判断"挪。 四个公开基准里,凡是定义清楚可验证的(PostTrainBench、WeirdML)分数都好看,真正隔离研究品味的(InnovationEval 2%—15%、CRUX 2 两篇全拒)就难看。你内部的 agent 评测集如果只考"能不能修好这个 bug",会系统性高估它。
- 成本的尺度会跟着变。 OpenAI 中位研究者的推理支出已经到每天 600 美元(按 API 价约每年 15 万美元),90 分位是每天 7,000 美元以上;而真正会失控的不是单次推理,是"自我改进"这个动作本身的开销——那是另一篇要拆的账。
来源
- Simas Kučinskas 与 Josh Rosenberg,How Close is Recursive Self-Improvement? A Review of the Evidence,Forecasting Research Institute,2026-11-10(数据截止 2026-11-03)
- 文内引用的一手材料:METR《Independent Assessment of AI R&D Acceleration at Anthropic in October 2026》(2026-11-05)、Anthropic 与 OpenAI 的系统卡/风险报告/招股书、Epoch AI 的 ECI 数据、Chan 等(2026)、Cunningham 等(2026)、Sarma 等(2026)
本文由汇智网编译整理,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南