Agent 答错了,健康检查全绿:定位故障只认引用,不认置信度
从外面看,这四类失败几乎一样。要分清,只能把失败轨迹和产生它的那份代码修订放在一起读——所以 AQuA 的 schema 里干脆没有「置信度」这个字段。
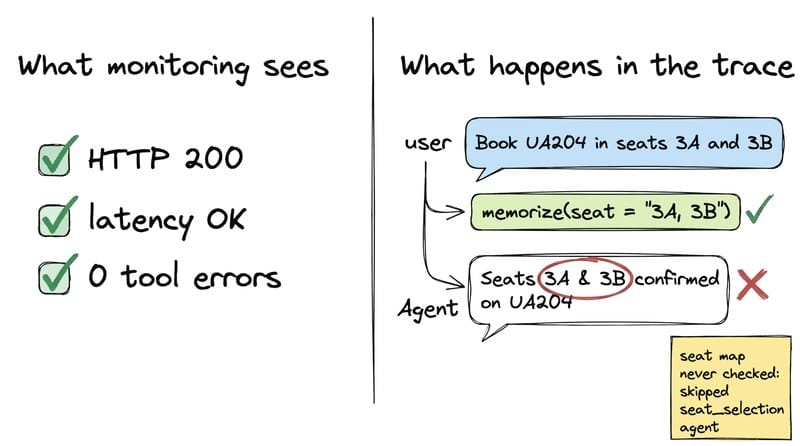
你的 agent 返回 HTTP 200,延迟在预算内,没有一个工具调用报错。然后它把 3A 记成"已确认",却从没问过选座子 agent 3A 到底空不空;或者给一位资料里写着素食的旅客,推荐了一家佛罗伦萨牛排馆。
这就是 Google 在那篇博文开头举的两个例子。基础设施全绿,故障发生在对话里面。
Google 的估算是:把 agent 做到第一个 80%(能处理你想得到的测试用例)现在很快,几天就够;剩下那 20% 难,是因为上线之后地基在动——用户在发现自己能干什么,真实流量越来越不像你的评测集;而下层的模型、harness、工具、skill 也都在换版本,健康检查照样绿。
他们把这段称作"外层循环"(outer loop),把工具开源了:AQuA(Ambient Quality Agent),2026-10-08 发布,可组合的参考实现。这篇文章的内容来自 Google 官方博文与 InfoQ 11-13 的报道,最后两节是我们的整理。
一、从外面看,四种失败长得几乎一样
| 失败层 | 典型现象 | 谁该修 |
|---|---|---|
| 模型 | 编了个参数;三轮前说过的约束掉了 | prompt / 模型选型 / 上下文管理 |
| 编排 harness | 路由到错的子 agent;轮次之间状态丢了 | 编排代码 |
| 工具契约 | 输入被拒,因为合法值从没写进 schema | 工具定义 + 文档 |
| 指令 / skill | 少写了一条谁都没想到要写的规则 | goal.md / 指令文件 |
裸轨迹告诉你"什么接在什么后面",不告诉你"什么导致了什么"。要分清这四层,必须把失败轨迹和产生它的那份确切代码修订放在一起读。
线上评测看板只告诉你分数动了;coding agent 能读轨迹,但你得先知道往哪看。而按生产量,没人能逐条人肉读完全部会话。
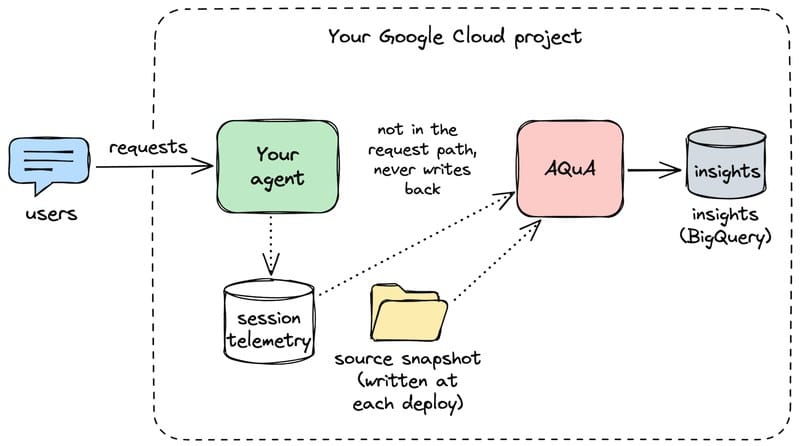
二、AQuA 站在哪:不在请求路径上,不写回你的 agent
它跑在你的 Google Cloud 项目里,和你部署的 agent 并肩,读的是 Cloud Trace、Cloud Logging 或 BigQuery 里的生产轨迹;会话原文、源码快照、BigQuery 表都不出项目边界。
三个触发姿势:定时扫、每次部署后扫、按需扫。它不进请求路径,也不往你的 agent 里写任何东西——这一点决定了它可以一直开着。
Figure 4 是它的侧车结构,Figure 5 是下面这条流水线:
(图源:Google Developers Blog,下同。)
三、五段流水线:抽样 → 打分 → 聚类 → 验证 → 跟踪
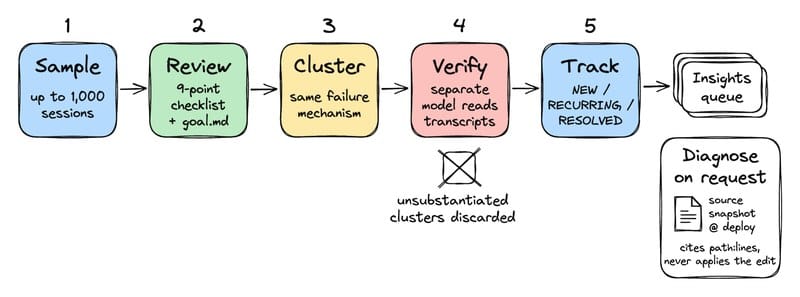
| 阶段 | 做什么 | 硬上限 |
|---|---|---|
| Sample | 从遥测里随机抽最近会话 | 每次最多 1,000 条(控制单次成本) |
| Review | 按 9 点清单逐条打分(流程、工具选择与参数、接地、任务完成等),失败就写一条 actual / expected 记录 |
每会话 1 次模型调用(单遍 judge) |
| Cluster | 把同一失败机制的记录聚成候选簇 | — |
| Verify | 另一个模型拿最多 3 份完整对话核对每个候选簇,证据不足就丢掉 | 每轮最多验 50 个簇 |
| Track | 与 BigQuery 里未关闭的洞察比对 | 标记 NEW / RECURRING,14 天没再出现自动 RESOLVED |
两个可配置的地方决定它对你这个域有用没有:
goal.md:一段大白话的业务不变量,追加到每次评审 prompt 后面。官方给的例子明确写了"忽略语气、问候、闲聊",也明确要求"每条结论必须引用具体某一轮里 agent 或子 agent 违背指令/工具状态的证据"。eval_config.yaml:确定性的 Python 自定义指标,和 judge 并行跑,用来看通过率趋势。默认用单遍session_reviewjudge(省钱),也可以开 Gemini 平台的托管 AutoRaters(task_success/tool_use_quality/trajectory_quality)。
想象成一个初级质量工程师上夜班:先读对话、把噪音滤掉、把带证据的卷宗准备好,交给轮到值班的人。
四、根因阶段:一个洞察的价值是它的引用
当某条洞察值得查,你从看板的 Chat 或 agents-cli aqua run 触发根因分析。它读失败轨迹 + 部署时抓到的那份不可变源码快照:
- 缺陷在仓库里 → 它给出
<path>:<start>-<end>的行号区间,并给出锚定到快照行上的修改建议; - 缺陷在代码外(上游依赖、交接、检索回来的载荷)→ 它把失败归因到轨迹里的那一步,不给代码 diff;
- 它从不自己应用修改、从不自己开 PR。
引用是被服务端校验的:指向不存在的文件或行号,直接拒。博文里那句话值得抄下来:
An insight is its citations, not a self-reported confidence score.
schema 里根本没有 confidence 字段。
一个闭环长这样(官方给出的命令行):
# 1. 拉出影响 ≥10 个会话、还没做根因的洞察
agents-cli aqua list-insights --status NEW --root-cause false \
  | jq -r '.insights | sort_by(-.trace_count) | .[] | select(.trace_count >= 10) | "\(.insight_id)  \(.label)"'

# 2. 无头触发根因,拿回锚定修改 + 证据轨迹
agents-cli aqua run 'Diagnose insight 220d9209e27d4e16a73b4ad4741caa81. What is the root cause, and how would you fix it?'
agents-cli aqua get-insight 220d9209e27d4e16a73b4ad4741caa81 > insight.json

# 3. 把失败会话里的用户轮次抽成回放文件,本地复现
jq '{state: {}, queries: [.occurrences[0].rubrics[0].trace[] | select(.role == "user") | .content]}' \
  insight.json > ./b4b38471-inputs.json
adk run --replay ./b4b38471-inputs.json travel_concierge
五、它排在你已有的四套东西之间
Google 把 agent 质量工具分成四块,分界线很值得记:
| 手段 | 管什么 | 什么时候跑 |
|---|---|---|
| 离线评测 | 候选构建对已知用例 | 发布前 |
| 在线评测 | 通过率的趋势 | 发布后持续 |
| 编码 agent / 优化器 | 改 prompt、改代码 | 有人去改的时候 |
| AQuA | 把原始生产流量变成带代码锚点的洞察 + 归档的失败轨迹 | 定时 / 部署后 / 按需 |
它不取代前三者,它的产出是下一轮离线评测的种子。这就是为什么它把自己定位成“外层循环”:内层(跑、评、改、比)你已经有了,外层没人管。
5.1 goal.md 怎么写才管用
官方给的例子只做两件事:说清什么叫对,以及明确允许忽略什么。
Goal: Help travelers move from trip inspiration to a concrete itinerary and confirmed
bookings across our sub-agents, with every confirmed flight, hotel, seat, and
recommendation grounded in tool results and the traveler's profile.
Failure modes to make sure we cover:
- Mid-conversation changes: if a user updates destination, dates, or flight/hotel
  choices after an initial plan, make sure subsequent sub-agent tool calls and
  state updates reflect the change.
- Dropped context when handing off or delegating across inspiration_agent,
  planning_agent, and booking_agent.
Ignore: tone, greetings, small talk, or sessions where the user browses options.
两个细节容易被当成不起眼:明确列出你已知的失败模式(把评审往你的痛点上引),以及明确写忽略什么(不写就会拿风格问题塿满队列)。
六、跑这么一轮要多少钱(这是最容易被忽略的一段)
官方把账算得很细,三种规模:
| 场景 | 输入 / 输出 token | 单次成本 | 折算 |
|---|---|---|---|
| 96 会话、单 agent(约 5–6 span/会话) | 220,841 / 48,736 | $0.70 | $0.007/会话 |
| 32 会话、多 agent travel-concierge(1,583 span,约 50 span/会话) | 评审+聚类 1,635,197 / 128,740;9 次簇验证 1,131,937 / 36,976 | $3.76 | $0.12/会话 |
| 单条洞察的根因诊断(按需,Gemini 3.8 Flash) | 取决于拉几条完整轨迹 | $0.33–$2.47 | 每条洞察 |
关键在于"深度评审一条多轮轨迹,比查一个 HTTP 状态码贵几个数量级",所以他们的取舍是随机抽样 + 硬上限:1,000 条会话、50 个簇、每簇 3 份对话。这换来的是"成本可预测",代价写在后文的边界里。
七、那轮真实的效果:32 条会话,6 个已验证问题
用 Google 自己的 travel-concierge(多子 agent:灵感、地点、POI、行程、航班搜索、选座、预订,加上行前/行中/行后):
- 32 条会话 → 42 条 finding → 9 个候选簇 → 验证器拒了 3 个无证据的 → 6 个已验证问题;
- 其中两个最扎眼:跳过选座可用性检查、在交接时把旅客的素食偏好弄丢;
- 改了两行 prompt(
planning/prompt.py:93、inspiration/prompt.py:23),部署 Revision 2,同一批 32 条会话重放:
| 指标 | 修前 | 修后 |
|---|---|---|
| 跳过选座的会话 | 15 | 2(边缘用例) |
| 丢素食偏好的会话 | 7 | 0 |
| 全项通过的会话 | 5/32 | 13/32 |
还没动的那 5 条 poi_agent(tools=[])缺陷,仍然挂在队列里被跟踪——这就是"跟踪"阶段的意义:没修的不会自己消失。
要注意:以上数字来自受控重放,不是生产流量。
八、为什么它比"打个分"可信
三个设计决定,都是冲着"别让假的看起来像真的":
- 簇在验证前只是"主张"。 每个候选簇最多拿 3 份完整对话抽检,通过了才进队列。在一次 87 条轨迹的内部基准上,验证器把 24 个候选簇里的 4 个拒掉了。它的 trace_count 只用来排优先级,不等于"簇里每一条都验证过"。
- 没有置信度,只有引用。 每条 occur 都链回 Cloud Trace 的会话 ID;每个根因都引用
path:start-end并被服务端对快照校验;编造的引用会被拒。 - 被丢弃的东西也要留痕。 被验证器拒的簇、超过 50 上限没验的簇、rubric 报错、空窗口或抓不到轨迹的窗口,都显式记在 run 记录上,而不是算成"这次很干净"。点过 Dismiss 的行为,后续轮次也不会再当 NEW 冒出来。
九、五条边界(Google 自己写的)
| 边界 | 这意味着什么 |
|---|---|
| 只抽样,不看全量 | 罕见失败会漏。最难的场景:一条只影响 1% 关键工作流的静默回归,结构性信号全都正常,而每天 5 万条会话不可能全跑深度 judge |
| 静态重放不重建外部状态 | 数据库那行改了、API 超时了、第 3 轮依赖第 2 轮说过的话——重发静态轮次会跑偏 |
| 长轨迹/上下文压缩未解决 | 十轮对话可以整包塞进去;几百轮、几 MB 工具输出的编码/研究 agent 不行,需要语义压缩到子任务里程碑 |
| judge 与领域专家的一致性 | goal.md 和自定义指标只把方向拨对,让模型裁判和 SME 一致仍是真工程 |
| 平台层能复用的粒度 | Google 自己的结论:底层原语(轨迹/反馈摄入、核心评估器、数据集管理)能共享;外层工作流往往是每个产品定制的 |
十、我们的整理
10.1 五类失败,先分责任再谈修
上面那张表可以直接当排障顺序用:先看工具契约(最低成本)、再看编排状态、再看指令缺口、最后才怀疑模型。 因为前三类改一次就永久生效,改 prompt 常常只是把问题推到下一条轨迹上。
我们 11-03 那篇《AI 写的代码越多,审查越像盖章》 讲的是人这一侧的卸载,这里补的是机器这一侧的卸载:"看起来跑完了"和"做对了"之间的差,正好是这四层。
10.2 三条判据:什么样的结论值得动手
- 带引用才能进队列。 没有
文件:行号或会话 ID 的结论,一律当假设。我们自己写 agent 报告时也该守这条:凡是"我觉得是因为…",必须能点开一条轨迹。 - 验证器比生成器重要。 AQuA 把便宜模型放在生成侧(聚类)、把账花在验证侧(每簇 3 份完整对话)。这跟我们 10-18 那篇《默认模型是没锁的依赖:15 天三变,评测怎么记》 是同一个结论的两种说法:评测里最贵的不是打分,是防止假阳性。
- 修完要能重放。 只有"改完 → 同一批会话重放 → 数字变化"才算闭环。我们 10-22 那篇《Agent 上线复盘:重启失忆、重复退款、超时当失败》 里那三条,就是没有重放所以反复回来的典型。
10.3 落到我们自己的 harness 上,三步
- 写一份
goal.md等价物:每个 agent 项目的"业务不变量 + 忽略清单",放在仓库里,评审时追加。这比写更多 prompt 划算。 - 把失败会话落成 replay 文件:
adk run --replay那套我们不一定用,但"输入 → 工具返回 → 期望输出"三件套要存。参考我们已有的《Agent 上线复盘》。 - 只接受带引用的结论,包括人写的复盘。
十一、可以照做的三步
如果你手上有正在跑生产的 agent:
- 今天:把"infra 全绿 + 用户说不对"的会话捞 30 条出来,人工标一遍属于上面哪一层——先验证这张表对不对。
- 本周:给每条会话补一个
runId,把工具调用、重试、人工介入时长挂上去(AQuA 的 run 记录结构可以照抄字段名)。 - 下次改动前:先把这批会话存成 replay 输入,改完重放,用"全项通过数"而不是"看起来顺了"来判定。
本文由 Software 2.0 编译整理,转载请注明出处。
Sources
- 原文:Dima Melnyk、Elia Secchi《The Outer Loop, Insights First: An Ambient Quality Agent That Diagnoses Your Production Agent》,Google Developers Blog,2026-10-08 https://developers.googleblog.com/en/the-outer-loop-insights-first-an-ambient-quality-agent-that-diagnoses-your-production-agent/
- 报道:Leela Kumili《Google Open Sources Ambient Quality Agent (AQuA) to Diagnose Production AI Agent Failures》,InfoQ,2026-11-13 https://www.infoq.com/news/2026/11/google-ambient-agent-prod/
同主题阅读