LIBRARY
Unsloth:大模型微调利器
训练时间一直是微调的最大障碍之一。这就是 Unsloth 的用武之地,声称可以使 LLM 训练速度提高 30 倍。
LIBRARY
训练时间一直是微调的最大障碍之一。这就是 Unsloth 的用武之地,声称可以使 LLM 训练速度提高 30 倍。

TOOL
在这篇博文中,我们将演示如何使用开源的AI编码助手 Tabby 和 推理平台 BentoCloud 部署可用于生产的 私有化的AI 编码助手。

LIBRARY
Crawl4AI 是一个创新的开源 Python 库,旨在简化网络爬虫和数据提取,使其成为开发人员和人工智能爱好者的必备工具。

LIBRARY
要从非结构化的法律合同文本中提取结构化数据,应该使用OpenAI的JSON模式还是结构化输出?

APPLICATION
Ray 是什么?为什么它成为我们最喜欢的构建AI代理应用程序的部署解决方案?

APPLICATION
假设你有一张航拍图像,但不知道拍摄位置,但知道空间分辨率和方向。计算机视觉如何帮助解决这个问题?

TOOL
Open WebUI,以前称为 Ollama WebUI,支持各种大型语言模型 (LLM) 运行器,是本地部署并与语言模型交互的多功能工具。

TOOL
LM Studio 是一款流行的 GUI 应用程序,它允许具有基本计算机知识的用户在其 Linux 机器上轻松下载、安装和运行大型语言模型 (LLM)。
MODEL-ZOO
OuteAI推出的OuteTTS是一种新颖的文本转语音 ( TTS ) 合成方法,它利用纯语言建模,无需外部适配器或复杂架构。
MODEL-ZOO
在过去的一年中,seamless_communication、StyleTTS、VITS、DeepSpeech和Whisper 等项目都在 TTS(文本转语音)技术的进步中发挥了重要作用。但现在,回顾 GitHub,这些项目中的很多都已经沉寂了。 最初,我只对它们的功能有基本的了解,而没有深入研究它们背后的技术概念和机制。这次,受到最近发布的 MaskGCT 和 OutTTS 等开源项目的启发,我决定总结一下 TTS 的基础技术。总体而言,音频生成的质量自去年以来有了显着提高。以前,合成的声音听起来很机械;现在,多亏了 Hertz-dev 等模型,我们可以生成听起来更自然、更像人类的音频。 1、TTS 基础知识 TTS 系统的主要目标是将输入的文本转换为听起来自然的语音。 1.1 传统TTS模型 传统的 TTS 模型(例如 Tacotron
MODEL-ZOO
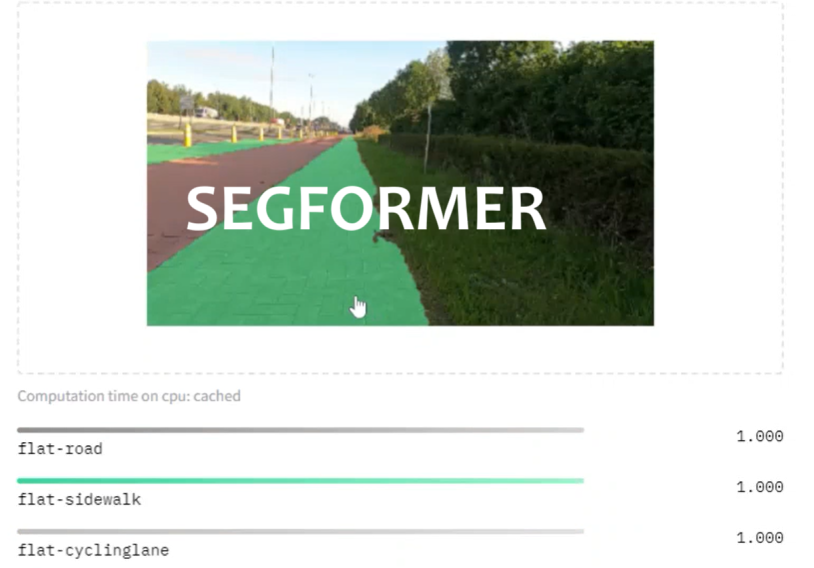
本指南展示了如何微调 Segformer,这是一种最先进的语义分割模型。我们的目标是为披萨送货机器人建立一个模型,这样它就可以看到要行驶的方向并识别障碍物 🍕🤖。 我们将首先在 Segments.ai 上标记一组人行道图像。然后,我们将使用 🤗 transformers 微调预先训练的 SegFormer 模型,transformers 是一个开源库,提供最先进模型的易于使用的实现。在此过程中,我们将学习如何使用 Hugging Face Hub,这是最大的开源模型和数据集目录。 语义分割是对图像中的每个像素进行分类的任务。你可以将其视为对图像进行更精确分类的方法。它在医学成像和自动驾驶等领域有广泛的用例。例如,对于我们的披萨送货机器人来说,重要的是要确切地知道人行道在图像中的位置,而不仅仅是是否有人行道。 因为语义分割是一种分类,所以用于图像分类和语义分割的网络架构非常相似。 2014 年,Long 等人发表了一篇开创性的论文,使用卷积神经网络进行语义分割。 最近,Transformers 已用于图像分类(例如 ViT),现在它们也用于语义分割,进一步推动了最先进的技术。

APPLICATION
GenAI 包装器正在悄悄地日进斗金。停止理论化,开始构建——现在还有时间发财。