谱聚类算法详解
在这篇文章里,我们将探索特征值与特征向量如何让谱聚类成为可能,以及这种方法为何能超越传统的 K-Means。
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
特征值与特征向量是线性代数中的关键概念,在数据科学和机器学习中也扮演着重要角色。此前我们讨论过如何利用协方差矩阵的特征值与特征向量进行降维。
今天我们要讨论另一个有趣的应用:如何用特征值和特征向量实现谱聚类——一种在复杂簇结构上表现出色的方法。
在这篇文章里,我们将探索特征值与特征向量如何让谱聚类成为可能,以及这种方法为何能超越传统的 K-Means。
我们会从一个简单的可视化开始,它会让你直观感受到谱聚类的重要性,并激励你继续学习如何用特征值和特征向量完成谱聚类。
1、谱聚类的动机
学习谱聚类的好方法,是把它和 K-means 这类传统聚类算法放在一个 K-means 表现吃力的数据集上做对比。
这里我们使用人工生成的双月亮(two-moon)数据集,它的簇是弯曲的。Scikit-learn 的 make_moons 算法在二维空间中生成两个月亮。然后我们用 Scikit-learn 的 KMeans 和 SpectralClustering 算法分别执行 K-means 和谱聚类,最后对比聚类可视化结果。
1.1 生成月亮数据
# Make moon data
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons

X, y = make_moons(n_samples=400, noise=0.05,
                  random_state=0)

plt.figure(figsize=[4.2, 3])
plt.scatter(X[:,0], X[:,1], s=20)
plt.title("Original Moon Data")
plt.savefig("Moon data.png")
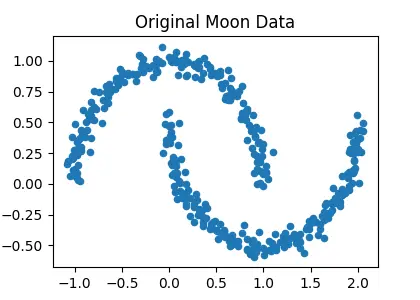
原始数据集包含两个弯曲的簇结构,称为月亮,这就是它叫月亮数据的原因。
1.2 对月亮数据应用 K-means
# Apply K-means
from sklearn.cluster import KMeans

kmeans = KMeans(n_clusters=2, random_state=0)

# Predict cluster index for each data point
labels_kmeans = kmeans.fit_predict(X)

# Visualize Clusters
plt.figure(figsize=[4.2, 3])
plt.scatter(X[:,0], X[:,1], c=labels_kmeans, s=20)
plt.title("K-Means Clustering")
plt.savefig("K-means.png")
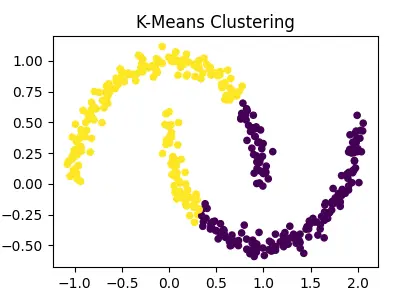
K-means 经常把月亮数据分错(把数据点错误地混在一起)。
1.3 对月亮数据应用谱聚类
# Apply spectral clustering
from sklearn.cluster import SpectralClustering

spectral = SpectralClustering(n_clusters=2,
                              affinity='nearest_neighbors',
                              random_state=0)

# Predict cluster index for each data point
labels_spectral = spectral.fit_predict(X)

# Visualize Clusters
plt.figure(figsize=[4.2, 3])
plt.scatter(X[:,0], X[:,1], c=labels_spectral, s=20)
plt.title("Spectral Clustering")
plt.savefig("Spectral.png")
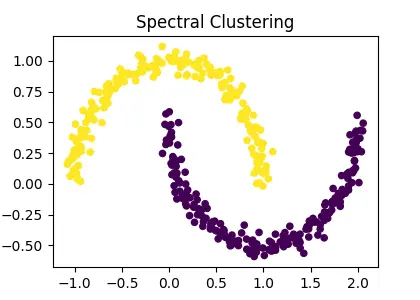
现在数据点被正确分配到两个"月亮"上,看起来和原始数据相似。谱聚类在复杂簇结构上表现良好,这是因为拉普拉斯矩阵的特征向量让它得以检测出复杂的簇结构。
到目前为止,我们用 Scikit-learn 内置的 SpectralClustering 算法实现了谱聚类。接下来你将学习如何从零实现谱聚类,这会帮助你理解特征值和特征向量在算法幕后如何工作。
2、什么是谱聚类?
谱聚类根据数据点之间的相似度而不是距离来分组,因此无需遵循传统 K-means 聚类的假设,就能揭示非线性的复杂簇结构。
执行谱聚类的直觉如下:
谱聚类的步骤
- 获取数据
- 构建相似度矩阵
- 构建度矩阵
- 构建拉普拉斯矩阵(图拉普拉斯)
- 求拉普拉斯矩阵的特征值与特征向量。特征向量揭示簇结构(数据点如何聚在一起),充当新特征;特征值指示簇的分离强度
- 选取最重要的特征向量,把数据嵌入更低的维度(降维)
- 在新特征空间上应用 K-means(聚类)
谱聚类把降维和 K-means 聚类结合在一起:先把数据嵌入低维空间(在那里簇更容易分离),再在新特征空间上执行 K-means。总结一下:K-means 在原始特征空间上工作,而谱聚类在新的(降维后的)特征空间上工作。
3、逐步实现谱聚类
我们已经总结了用拉普拉斯矩阵的特征值与特征向量执行谱聚类的步骤。下面用 Python 实现这些步骤。
3.1 获取数据
我们沿用之前用过的数据。
from sklearn.datasets import make_moons

X, y = make_moons(n_samples=400, noise=0.05,
                  random_state=0)
3.2 构建相似度(亲和)矩阵
谱聚类根据数据点之间的相似度分组,因此我们需要衡量数据点之间的相似度并把这些值放进一个矩阵,这个矩阵称为相似度矩阵(W)。这里我们用高斯核衡量相似度。
如果你有 n 个数据点,W 的形状就是 (n, n)。每个值代表两个数据点之间的相似度,矩阵中的值越大,表示两点越相似。
from sklearn.metrics.pairwise import rbf_kernel

W = rbf_kernel(X, gamma=20)
3.3 构建度矩阵
度矩阵 (D) 包含每个节点的相似度之和。它是一个对角矩阵,每个对角值表示该点与所有其他点的总相似度,所有非对角元素都为零。度矩阵的形状同样是 (n, n)。
import numpy as np

D = np.diag(np.sum(W, axis=1))
np.sum(W, axis=1) 对相似度矩阵的每一行求和。
3.4 构建拉普拉斯矩阵
拉普拉斯矩阵 (L) 表示相似度图的结构——节点代表每个数据点,边把相似的点连接起来。因此这个矩阵也叫图拉普拉斯,定义如下。
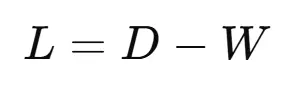
用 Python 表示就是:
L = D - W
从数学上说,用 D − W 得到 L,保证了谱聚类会找出组内强连接、组间弱连接的数据点集合。
拉普拉斯矩阵 (L) 同样是一个 (n, n) 方阵。这一性质对 L 很重要,因为特征分解只对方阵有定义。
3.5 拉普拉斯矩阵的特征分解
拉普拉斯矩阵的特征分解是把该矩阵分解(因子化)为特征值和特征向量的过程 [参考:用 NumPy 对协方差矩阵做特征分解]
如果拉普拉斯矩阵 (L) 有 n 个特征向量,我们可以把它分解为:
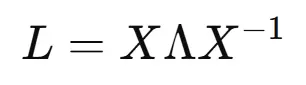
其中:
- X = 特征向量矩阵
- Λ = 特征值对角矩阵
矩阵 X 和 Λ 可以表示为:
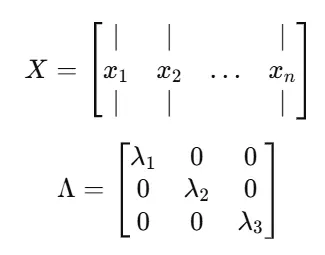
向量 x1、x2 和 x3 是特征向量,λ1、λ2 和 λ3 是它们对应的特征值。
特征值与特征向量成对出现,这样的一对称为特征对。矩阵 L 可以有多个特征对 [参考:用 NumPy 对协方差矩阵做特征分解]
下面的特征值方程展示了 L 与其某个特征对之间的关系。
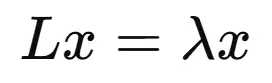
其中:
- L = 拉普拉斯矩阵(必须是方阵)
- x = 特征向量
- λ = 特征值(缩放因子)
来计算拉普拉斯矩阵的所有特征对。
eigenvalues, eigenvectors = np.linalg.eigh(L)
3.6 选取最重要的特征向量
在谱聚类中,算法使用拉普拉斯矩阵最小的那些特征向量。因此我们需要在 eigenvectors 矩阵中选出最小的那些列。
最小的特征值对应最小的特征向量。eigh() 函数按升序返回特征值和特征向量,所以我们只需看 eigenvalues 向量开头的几个值。
print(eigenvalues)
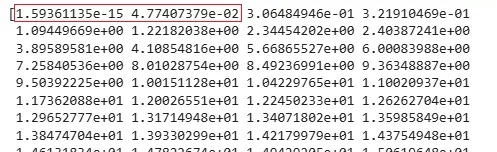
我们关注相邻特征值之间的差,这个差称为特征间隔(eigengap)。我们选取让特征间隔最大的那个特征值位置,它代表簇的个数,这种方法叫作特征间隔启发式(eigengap heuristic)。
按照特征间隔启发式,最优簇数 k 取在相邻特征值跳跃最大的位置。
如果有 k 个非常小的特征值,就会有 k 个簇!在我们的例子中,前两个小特征值提示有两个簇,正是我们所预期的。这就是特征值在谱聚类中的作用:它们对确定簇数以及选出最小特征向量非常有用!
我们选取与这些小特征值对应的前两个特征向量。
k = 2
U = eigenvectors[:, :k]
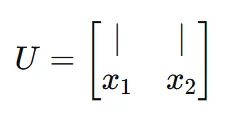
矩阵 U 中的这两个特征向量代表一个新特征空间,称为谱嵌入(spectral embedding),簇在其中线性可分。下面是谱嵌入的可视化。
import matplotlib.pyplot as plt

plt.figure(figsize=[4.2, 3])
plt.scatter(U[:,0], U[:,1], s=20)
plt.title("Spectral Embedding")
plt.xlabel("Eigenvector 1")
plt.ylabel("Eigenvector 2")
plt.savefig("Spectral embedding.png")
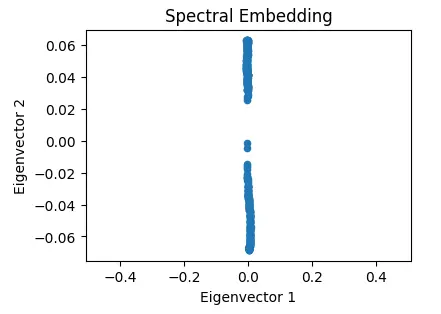
这张图展示了特征向量如何把原始数据变换到一个簇线性可分的新空间。
3.7 在谱嵌入上应用 K-means
现在我们可以直接在谱嵌入(新的特征向量空间)上应用 K-means 得到簇标签,再把这些标签分配回原始数据形成聚类。K-means 在这里表现很好,因为簇在新的特征向量空间中是线性可分的。
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans

kmeans = KMeans(n_clusters=k)
labels_spectral = kmeans.fit_predict(U)
# U represents spectral embedding

plt.figure(figsize=[4.2, 3])
# Assign cluster labels to original data
plt.scatter(X[:,0], X[:,1], c=labels_spectral, s=20)
plt.title("Spectral Clustering")
plt.savefig("Spectral Manual.png")
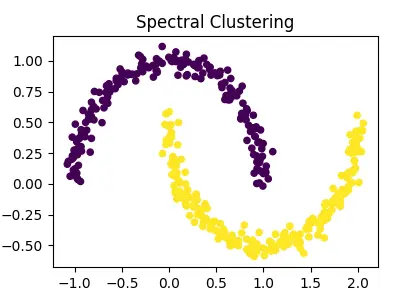
这和 Scikit-learn 版本得到的结果一模一样!
4、选择合适的 Gamma 值
构建相似度矩阵或用高斯核衡量相似度时,需要为 gamma 超参数定义合适的值——它控制相似度随数据点之间距离下降的速度。
from sklearn.metrics.pairwise import rbf_kernel

W = rbf_kernel(X, gamma=?)
gamma 取值小时,相似度下降缓慢,许多点看起来都相似,结果会导致错误的簇结构。
gamma 取值大时,相似度下降非常快,只有非常近的点才相连,簇会被分得过开。
取中间值时,你会得到比较均衡的簇。
最好多试几个值,比如 0.1、0.5、1、5、10、15,并把聚类结果可视化来挑选最好的。
5、结束语
表示成一张图,而不是一堆点的集合。图中每个数据点是一个节点,节点之间的线(边)定义了相似的点如何连接在一起。
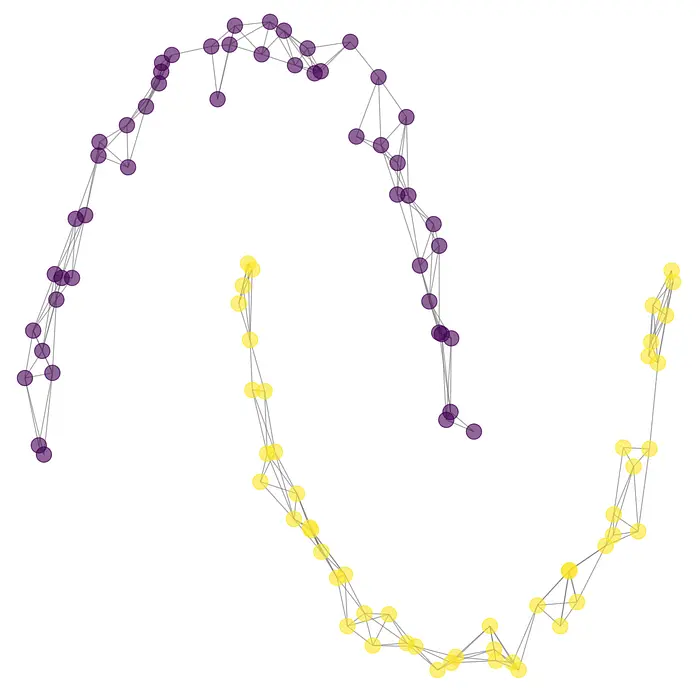
谱聚类算法需要这张图的数学形式,这就是我们构建相似度(亲和)矩阵 (W) 的原因。矩阵中的每个值衡量数据点之间的相似度:值大表示两点非常相似,值小表示两点很不相似。
接下来我们构建了度矩阵 (D)——一个对角矩阵,每个对角值表示该点与所有其他点的总相似度。
利用度矩阵和相似度矩阵,我们构造了图拉普拉斯矩阵,它捕捉图的结构,是谱聚类的核心。
我们计算了拉普拉斯矩阵的特征值和特征向量:特征值帮助选择最佳簇数和最小的那些特征向量,也指示簇的分离强度;特征向量揭示簇结构(簇的边界或数据点如何聚团),并用于获得一个新特征空间——图中强连接的点在这个空间里彼此靠近,簇更容易分开,K-means 在新空间里表现良好。
这就是谱聚类的完整工作流。
数据集 → 相似度图 → 图拉普拉斯 → 特征向量 → 簇
今天的文章就到这里。
有问题或反馈欢迎告诉我。
下篇文章见。祝学习愉快!
原文链接: Spectral Clustering Explained: How Eigenvectors Reveal Complex Cluster Structures
汇智网翻译整理,转载请标明出处