
MODEL-ZOO
DeepSeek现象解密
为什么 DeepSeek 能席卷 AI 世界,而 Qwen2.5-Max 和 Qwen Chat 却难以引起同样的轰动?
MODEL-ZOO
为什么 DeepSeek 能席卷 AI 世界,而 Qwen2.5-Max 和 Qwen Chat 却难以引起同样的轰动?

MODEL-ZOO
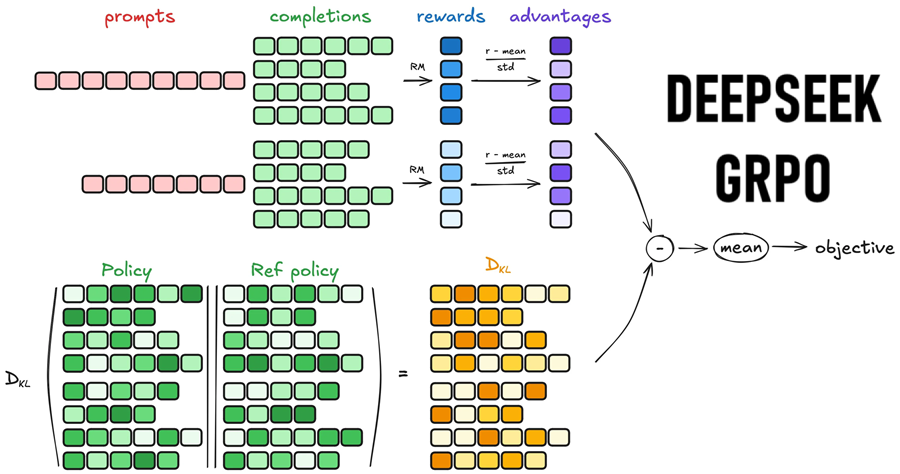
DeepSeek使用简单的强化学习(GRPO)来训练像 DeepSeek-R1 这样的 LLM,本文将尝试了解GRPO与OpenAI使用的RLHF强化学习有何不同。
MODEL-ZOO
GRPO(组相对策略优化)是强化学习 (RL) 中使用的一种方法,通过比较不同的动作并使用一组观察结果进行小的受控更新来帮助模型更好地学习。

APPLICATION
在本综合指南中,我们将探讨如何利用 DeepSeek 的功能构建能够以有意义的方式理解、推理和交互的复杂 AI 代理。
MODEL-ZOO
DeepSeek 的 Janus 系列是一种先进的开源多模态 AI 模型,它将图像理解、文本到图像生成和视觉语言推理统一到一个系统中。
MODEL-ZOO
在本指南中,我们将介绍使用监督微调 (SFT) 和 Hugging Face 数据集对 DeepSeek LLM 进行微调的过程,并提供针对特定领域数据集进行训练的分步代码演示。
MODEL-ZOO
专家混合 (MoE) 已成为一种流行的提高 LLM 效率的架构组件。在这篇博文中,我们将探讨研究人员在实现专家完美混合的道路上所采取的步骤。

LIBRARY
API使大型语言模型 (LLM) 能够无缝集成到不同的软件生态系统中。本文将探讨用于访问不同 LLM 的8个最领先的 API提供平台。