MODEL-ZOO
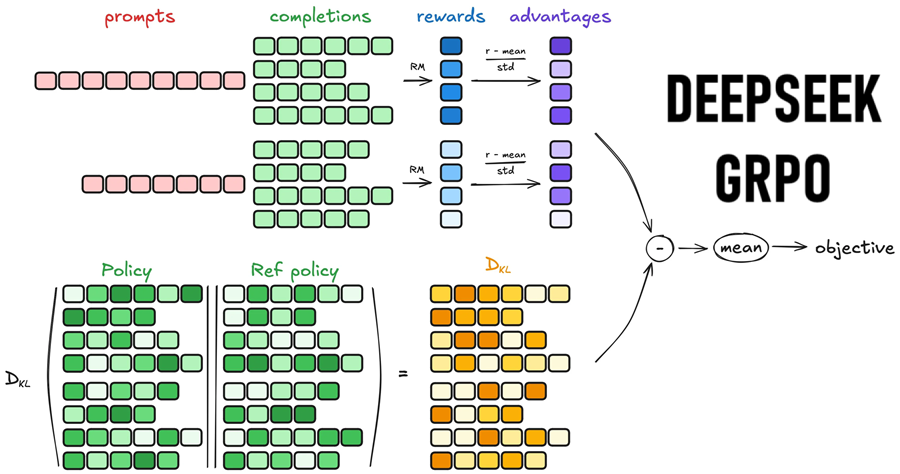
DeepSeek GRPO强化学习算法
GRPO(组相对策略优化)是强化学习 (RL) 中使用的一种方法,通过比较不同的动作并使用一组观察结果进行小的受控更新来帮助模型更好地学习。
MODEL-ZOO
GRPO(组相对策略优化)是强化学习 (RL) 中使用的一种方法,通过比较不同的动作并使用一组观察结果进行小的受控更新来帮助模型更好地学习。
MODEL-ZOO
在这篇博文中,我们想使用群组相对策略优化 (GRPO) 和倒计时游戏重现 DeepSeek-R1 的小“顿悟时刻”。
MODEL-ZOO
如果我告诉你,现在可以完全免费使用一种不仅好而且可能比 ElevenLabs 等行业领先(且昂贵)服务更好的工具来创建专业品质的 AI 配音,你会怎么想?听起来好得令人难以置信?
MODEL-ZOO
借助 DeepSeek 最新发表的研究,我们可以更好地进行推测。关键见解是,LLM 推理系统更高程度的新颖性适应性(和可靠性)是在三个维度上实现的。
MODEL-ZOO
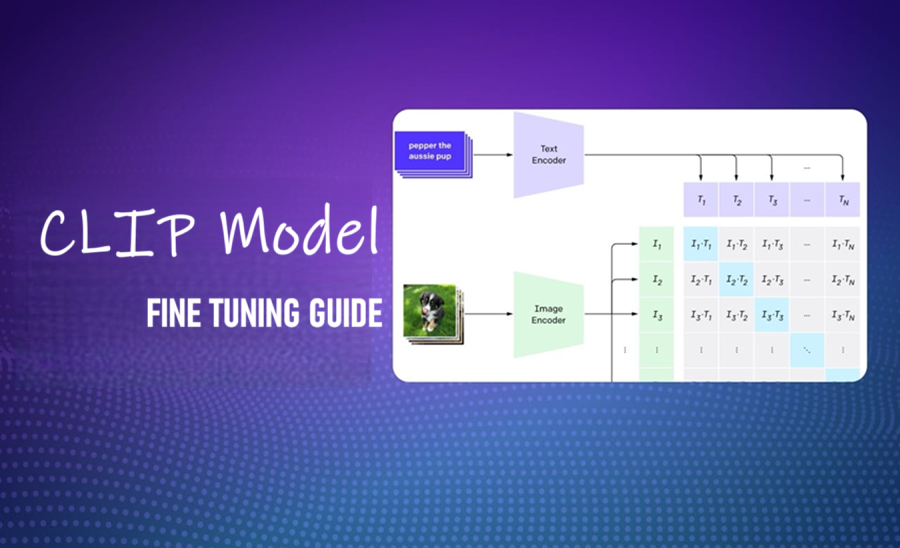
CLIP 是一种流行的多模态嵌入模型,它使用对比学习在大量图像-标题对语料库上进行训练。 CLIP可以解锁零样本能力,例如图像分类、搜索和字幕。
MODEL-ZOO
在这篇博文中,我们将逐步指导你在消费级 GPU 上使用 LoRA(低秩自适应)和 Unsloth 对 DeepSeek-R1 进行微调。
MODEL-ZOO
最近我在测试本地运行DeepSeek R1,但CPU温度太高了。我的朋友说你为什么不使用 Google Colab?因为它为你提供了一个 免费GPU。
MODEL-ZOO
DeepSeek R1 的训练分为 4 个阶段,本文将每个训练阶段分解为其核心组件、见解和未解决的问题。
MODEL-ZOO
如果你想在自己控制的基础设施上托管 DeepSeek 模型,我会告诉你怎么做!
MODEL-ZOO
推理模型模拟人类如何逻辑地解决问题,提供可解释性和结构化决策。但是,推理模型与其他 AI 范式(例如统计或深度学习模型)有何不同?
MODEL-ZOO
DeepSeek 的 Janus 系列是一种先进的开源多模态 AI 模型,它将图像理解、文本到图像生成和视觉语言推理统一到一个系统中。
MODEL-ZOO
在本文中,我们将探讨 Janus-Pro-7B 的架构、功能、训练方法和潜在应用。此外,我们将提供在实际应用中利用此模型的代码片段。