
LIBRARY
MarkItDown深入研究
MarkItDown 是 Microsoft 开发的 Python 包,旨在将各种文件格式转换为 Markdown。
LIBRARY
MarkItDown 是 Microsoft 开发的 Python 包,旨在将各种文件格式转换为 Markdown。

LIBRARY
Stagehand 是 Playwright 的 AI 继任者,提供三个简单的 API(act、extract 和 observer),为自然语言驱动的 Web 自动化提供构建模块。

LIBRARY
文本转语音(TTS),也称为语音合成,可用于各种应用,包括个人助理、导航系统、电子学习平台以及视障人士或阅读困难人士的辅助工具。本文介绍开发者最常用的17个语音合成API。

APPLICATION
随着大型语言模型 (LLM) 越来越受欢迎,一个挑战是确保当用户使用超出其预期目的的查询或请求提示这些模型时,由 LLM 驱动的应用程序不会偏离主题。
MODEL-ZOO
本文对通过公共 API 提供的顶级 LLM 进行了深入分析。我专注于它们在编码任务中的表现,以 HumanEval 等基准为衡量标准,以及它们在各自的 Elo 分数中反映的实际表现。

APPLICATION
我的目标是从科学代码过渡到一份全面的LaTex文档,该文档介绍代码的用途、定义变量、展示科学公式、包含生成的示例图并演示特定示例的计算。

TOOL
ComfyUI的AnyNode可以利用LLM大模型,实时为任何类型的计算或基于功能的任务创建自定义节点。
LIBRARY
MegaParse 是一款功能强大且用途广泛的解析器,可以轻松提取PDF、PPT、Excel、CSV、Word 等各种类型文档的内容。
LIBRARY
PydanticAI是Pydantic作者推出的多代理开发框架,它利用Pydantic 验证静态和流式响应,确保可靠的数据处理,与 OpenAI、Gemini 和 Groq 模型兼容。
APPLICATION
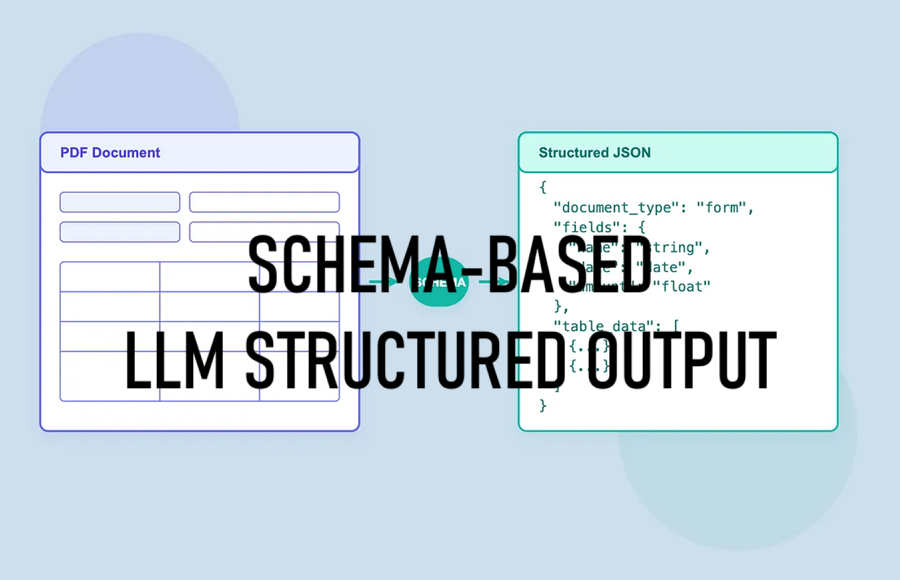
记者们通过文档转储和白皮书获得 PDF 作为对 FOIA 请求的回应。要使用 PDF,这些记者需要从文档中获取数据并将其转换为易于分析的格式,例如电子表格。该过程可能涉及费力的手动转录或将数据从一种格式复制并粘贴到另一种格式。 从理论上讲,大型语言模型可以协助文档处理,但幻觉等风险和 LLM 输出固有的不确定性使这种方法变得棘手。记者需要确保输出确实包含所需的数据、遵循所需的数据类型并采用可用的格式。 结构化输出为这些挑战提供了解决方案。像 Anthropic 和 OpenAI 这样的提供商以及像 Outlines 这样的开源库允许开发人员定义严格的模式,将 LLM 响应限制在特定字段、数据类型和格式。 结构化输出将原始的 LLM 功能转换为可靠的数据处理管道。例如,从多页 PDF 中提取表格时,模式可确保跨页面的列名和数据类型一致。虽然这种方法不能保证完全准确,但它降低了解析和验证 LLM 响应的工程复杂性,使文档处理工作流更加可靠和易于维护。 模式本质上是一个蓝图,它告诉模型要查找哪些信息以及如何组织这些信息。可以将其想象成一个标准化表格:记者不是让模型以任何格式返回数据,
LIBRARY
Apryse 是一款用于文档管理的一体化原生工具包,它提供了用于 Web、移动、客户端和服务器使用的库,涵盖 PDF 查看、注释、编辑、创建、生成,以及与我的需求最相关的:通过其服务器 SDK 提取数据,以 JSON、XML 甚至 XLSX 格式提供数据。
LIBRARY
本文探讨了用于构建和向应用程序添加 AI 代理的前五大平台。我们将探讨这些框架的主要功能和优势,并演示使用其中一些构建代理的代码示例。