
VLM
未知物体自动标注流水线
SAM3 + Grounding DINO + VLM — 并行运行多种策略,为你的物体选择最佳方案。
VLM
SAM3 + Grounding DINO + VLM — 并行运行多种策略,为你的物体选择最佳方案。

APPLICATION
本文介绍如何使用Qwen-2.5-VL、vLLM和AWS Batch构建处理数百万份文档的文档解析管道。
PROMPT ENGINEERING
在这篇博客文章中,我将解释如何提示 VLMs 来完成需要视觉理解的任务,并探讨不同的提示方法。

MODEL-ZOO
olmOCR在250,000页的数据集上微调了Qwen2-VL-7B-Instruct模型,旨在将PDF和文档图像转换为干净且结构化的纯文本。

APPLICATION
在本教程中,我们将构建一个车辆文档系统,从车辆图像中提取重要细节。这些细节将以结构化格式提取,以便进一步供下游使用。

APPLICATION
本文探讨了两种强大的方法来解决这一问题,特别是在处理复杂布局和表格时:利用视觉语言模型(VLMs)以及结合文档分割和OCR进行准确的文本提取。

LIBRARY
DSPy 最近在测试版中增加了对 VLM 的支持。本文介绍使用 DSPy 从图像中提取属性。
APPLICATION
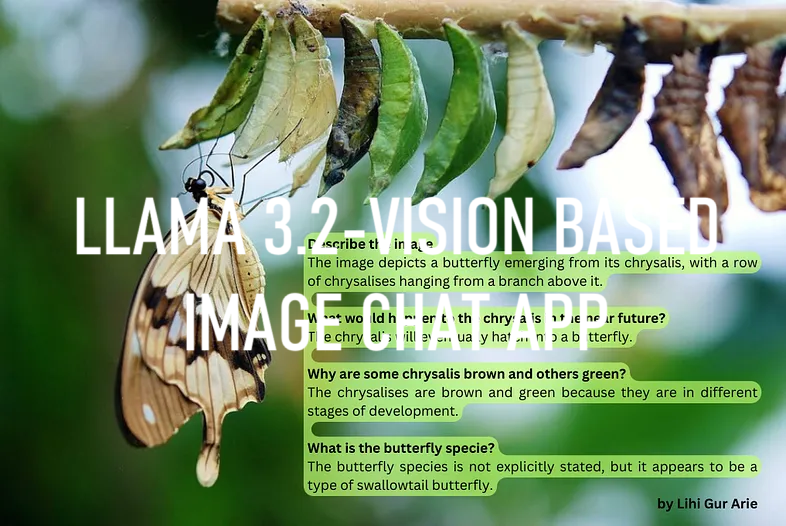
在本教程中,我们将学习如何使用开源 Llama 3.2-Vision 模型与我们的图像聊天,你会惊叹于它的 OCR、图像理解和推理能力。

MODEL-ZOO
Qwen2-VL 是阿里巴巴于 2024 年 10 月发布的视觉语言模型。它提供三种模型大小:2B、7B 和 72B,并允许用户使用文本询问有关图像的问题,类似于 GPT-4 视觉 API。

MODEL-ZOO
本文介绍 SmolVLM,这是一款 2B VLM,内存占用率最低。SmolVLM 体积小、速度快、内存效率高,并且完全开源。
MODEL-ZOO
在本文中,我们将探讨如何使用Unsloth、WandB等强大的工具组合来微调 Meta AI 的 Llama-3.2–11B-Vision 模型,并使用vLLM进行模型服务和推理。

APPLICATION
自2023年以来,人工智能领域将受到来自生成式AI的新成功的冲击,我们将探索是否可以利用这些基础模型来构建数据集、利用新的架构和新的预训练权重,或者从中提取知识。