什么是数据产品?
我们将讨论数据产品是什么,如何实现(基于我的想象),以及它带来的挑战。
在探索数据工程中(新?)概念的旅程中,我们现在将注意力转向数据产品。
我们将讨论它是什么,如何实现(基于我的想象),以及它带来的挑战。
就像data contract文章一样,因为我之前没有数据产品的概念,你在这篇文章中读到的内容完全基于我的研究、观察和一点想象 :d
所以,请随时批评我或给我反馈。
1、它是什么?
如果我在写这篇文章的前一天被问到这个问题,我会告诉提问者:"它是data mesh的一部分;去看看吧"。
顺便说一下,我刚写了一篇data mesh文章 → 链接。
事实证明,产品化的想法在Data Mesh之前就存在了近十年。
第一个(?)有记录的定义来自DJ Patil在2012年的一篇文章《Data Jujitsu: The Art of Turning Data into Product》。
Patil提出在设计过程中将"产品"放在首位,然后是"数据";首先交付MVP以验证解决方案背后的想法,并让一小部分客户先测试。
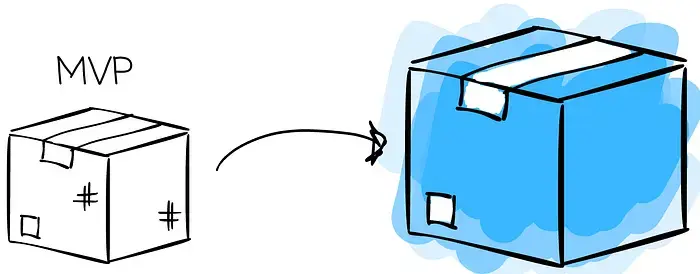
Patil就是2008年在LinkedIn时与Jeff Hammerbacher共同创造"data scientist"一词的人
这与我们通常对服务数据集的做法形成对比,我们可能花费数月时间构建基础设施、数据建模和管道,最终发现结果与客户期望不符。
Patil的提案允许数据从业者以更敏捷的方式管理期望并开发"产品"。
但当时"data product"一词没有得到太多关注,因为人们仍然沉浸在"大数据"时代(MapReduce仍然有一席之地)。
—
然后,在2019年,Zhamak Dehghani发表了她的data mesh工作,将这个术语重新带回对话中。
这次比第一次受到更多关注
在Zhamak的框架中,数据产品是一个可独立部署的、高内聚的组件,它捆绑了数据和元数据、用于摄取、处理、服务和治理它的代码,以及运行所有这些的基础设施。
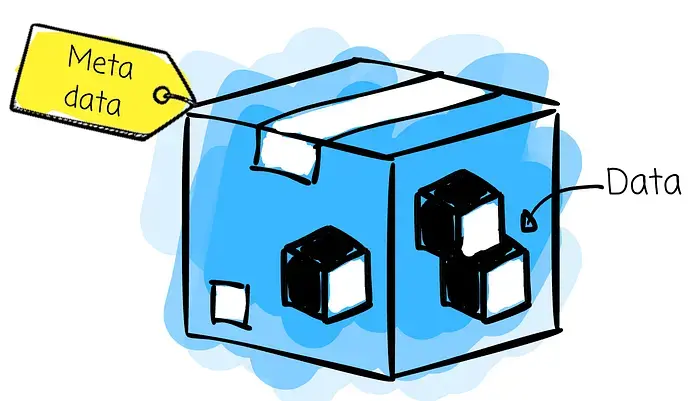
与Patil的提案相比,数据产品更加具体,
它是一个具有所有者、接口和在其他数据产品网格中位置的单元。
大多数人(包括我)从Zhamak的Data Mesh提案中了解到这个术语,并假设它始于那里。
我相信不是。
我不知道Zhamak是否从Patil那里借用了这个,但我很确定两人都受到了构建软件产品过程的启发。
—
然后是Chad Sanderson。
他没有创造这个词,但他可能做了更多工作,让"data product"对那些对采用完整data mesh组织模型没有兴趣的工程师来说意味着具体的东西。
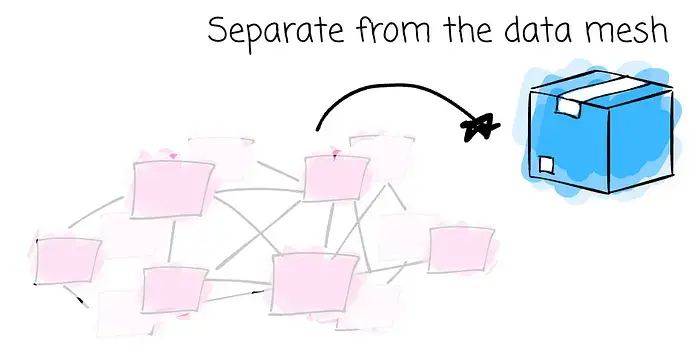
Sanderson不将数据产品与data mesh联系起来。
软件产品是围绕业务需求组织的工程系统的总和,具有接口和后端。
在他的框架中,数据产品是相同的形状。它是为服务业务需求而组织的数据组件的总和。
因此,例如,仪表板是一个数据产品。
像Patil和Zhamak一样,Sanderson的观点也深受软件工程手册的启发。
2、它解决什么问题?
在讨论如何实现之前,让我们放慢脚步,看看它(承诺)解决哪些类型的问题。
我们也从Patil、Zhamak和Chad的角度来看这个问题。
—
早在2012年,Patil观察到数据科学家(包括他自己)面对难题时立即伸手去拿最大的技术锤子(例如最先进的ML技术)。
因为那是提供最多多巴胺的部分(是的,他说得对 :d)
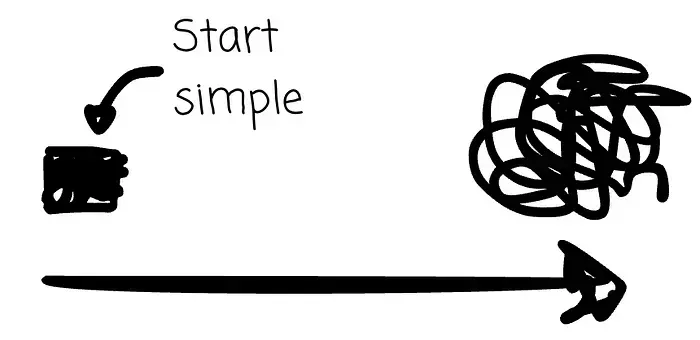
他的论点是,以这种方式解决问题是通往灾难的捷径:问题只会变得更复杂,直到它被缩小范围并以正确的心态处理。
他的解决方法是一种纪律:从简单开始,将产品扎根于现实世界,并将整个事情视为具有用户的产品,而不是具有数据集的研究练习。
—
快进到2019年,Zhamak描绘了几乎每个数据团队构建的设置:一个中央团队,公司其他团队向它抛掷数据并希望得到有用的东西。
一开始效果很好。
但一旦所有权被隔离在"黑盒"数据平台团队内部,它就停止工作了,这个团队理解技术方面但不理解数据来自的业务。当源系统在上游发生变化时,该团队与其他所有人一样发现:一些下游用例中断。
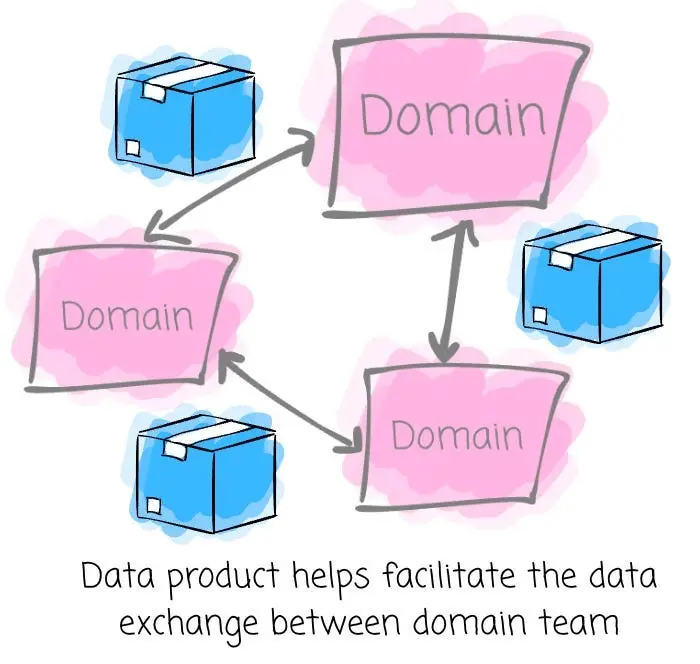
Zhamak的观察借鉴了软件中已经发生的事情:这与单体软件架构相关的瓶颈相同,解决方案与软件找到的相同:将所有权推给最接近领域的人(真正理解数据的人)。
如果领域团队负责一个(数据)产品,一个具有所有者、接口、定义形状的东西,而不是仓库中某个地方的表转储,那么"谁破坏了它以及为什么破坏"就不再是个谜。在这个视角下,数据产品解决的问题是可信赖性和可靠性。
—
从Chad的角度来看,我发现它与Zhamak的非常相似。
Sanderson看到大多数数据团队专注于速度和消除瓶颈,已经忘记了整个数据系统的初衷:提供可扩展的真相来源来支持利益相关者的业务决策。
据我理解,与Zhamak不同,Chad没有花太多时间论证将数据视为产品是否正确;他主要是假设它是正确的。
他认为这是正确的方法,但仅将数据视为产品是不够的。他的立场是明确的:"数据契约应该为这些产品服务,而不是相反。" 契约必须存在以保护数据产品。
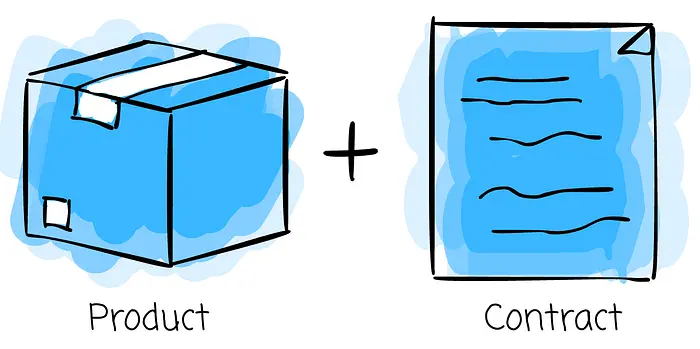
他的实际诊断不是"为什么我们需要数据产品";而是"为什么数据产品不断中断?"
他的答案,基于他运行数据平台的经验:软件团队将数据视为自己应用程序的产品,发布更改时对谁依赖它一无所知。
(对我来说,Chad试图用数据契约而不是数据产品来解决问题)
没有任何东西介于两者之间来捕获更改;目录和监控只在损害发生后才看到。通过这个视角,问题是没有强制接口的数据产品最终会中断。
3、实现
在我的研究过程中,我发现了两个数据产品标准:Open Data Product Specification (ODPS)和Open Data Product Standard (ODPS)。
两者都是ODPS,让我很困惑 :D
然而,在这篇文章中,我只关注Open Data Product Standard。
从现在开始,当我写ODPS时,我想指的是Open Data Product Standard。
3.1 标准
Bitol维护Open Data Contract Standard (ODCS),也维护自己的数据产品标准。
我只关注Open Data Product Standard的原因是我觉得自己能够理解它,因为我已经在上一篇文章中讨论了ODCS。
ODCS和ODPS解决两个不同的问题,通常一起使用。
ODCS描述关于数据的承诺:它的形状、它应该达到的质量标准,或者向消费者保证什么。
# ODPS高级信息。
# 来源:https://bitol-io.github.io/open-data-product-standard/v1.0.0/#table-of-content
apiVersion: v1.0.0
kind: DataProduct
name: Customer Data Product
id: fbe8d147-28db-4f1d-bedf-a3fe9f458427
domain: seller
status: draft
tenant: RetailCorp
description:
  purpose: Enterprise view of a customer.
  limitations: No known limitations.
  usage: Check the various artefacts for their own description.
tags: ['customer']
ODCS描述更高级别的内容。它回答问题"这整体是什么,谁负责它,以及它背后有哪些契约?"
# 产品的端口信息
# 来源:https://bitol-io.github.io/open-data-product-standard/v1.0.0/#table-of-content
inputPorts: # 期望 [可选]
- name: payments
  version: 1.0.0 # [必需]
  contractId: dbb7b1eb-7628-436e-8914-2a00638ba6db # [必需]
- name: payments
  version: 2.0.0 # [必需]
  contractId: dbb7b1eb-7628-436e-8914-2a00638ba6da # [必需]
- name: onlinetransactions
  version: 1.0.0 # [必需]
  contractId: ec2a112d-5cfe-49f3-8760-f9cfb4597544 # [必需]
- name: onlinetransactions
  version: 1.1.0 # [必需]
  contractId: ec2a112d-5cfe-49f3-8760-f9cfb4597547 # [必需]
outputPorts: # 承诺 [必需]
- name: rawtransactions
  description: "Raw Transactions"
  type: tables
  version: v1.0.0 # [必需]
  contractId: c2798941-1b7e-4b03-9e0d-955b1a872b32 # [必需]
- name: rawtransactions
  description: "Raw Transactions"
  type: tables
  version: v2.0.0 # [必需]
  contractId: c2798941-1b7e-4b03-9e0d-955b1a872b33 # [必需]
  sbom: # SBOM可以/应该在版本级别 [可选]
  - type: "external" # 默认
    url: "https://mysbomserver/mysbom"
  inputContracts: # 或依赖 [可选]
  - id: dbb7b1eb-7628-436e-8914-2a00638ba6db # 或contractId
    version: v2.0.0
  - id: ec2a112d-5cfe-49f3-8760-f9cfb4597544
    version: v1.0.0
- name: consolidatedtransactions
  description: "Consolidated transactions"
  type: tables
  version: v1.0.0
  contractId: a44978be-1fe0-4226-b840-1b715bc25c63
- name: fulltransactionswithreturns
  description: "Full transactions with returns"
  type: tables
  version: v0.3.0
  contractId: ef769969-0cbe-4188-876f-bb00abadaee4
在这个模型中,单个产品可以公开多个"端口",每个端口都由自己的单独ODCS契约支持(指向契约ID)。有三种端口类型:
- 输入端口(产品消耗的内容)
- 输出端口(它向下游承诺的内容)
- 管理端口(可观察性、血缘、管理,通常在摘要中省略)。
所以图片看起来像这样:产品标准处理产品的高级信息(例如所有权、端口),而ODCS处理端口级别的实际承诺履行。
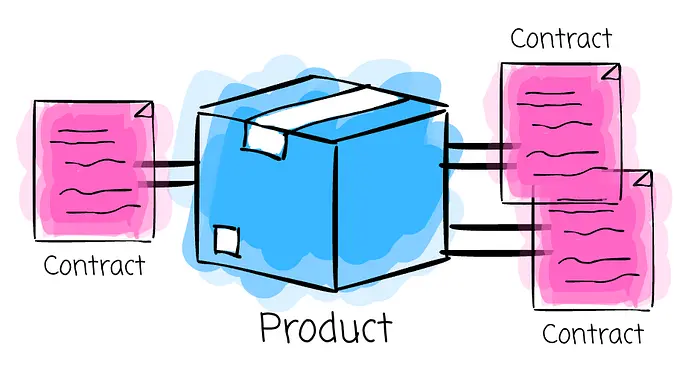
对我来说,这与Chad Sanderson的愿景一致:数据产品必须附带数据契约。
3.2 验证引擎
那么,定义YAML文件后会发生什么?
这里必须有一种验证引擎(就像我为数据契约想象的那样)。因为数据产品YAML文件中最重要的信息是产品的相关契约,我认为验证应该主要关注契约的约束。
—
首先,将有一个步骤来验证YAML内容。
Bitol引入了Data Product CLI和Data Contract CLI来创建、检查和发布ODPS/ODCS文件。它确保字段及其值符合标准。
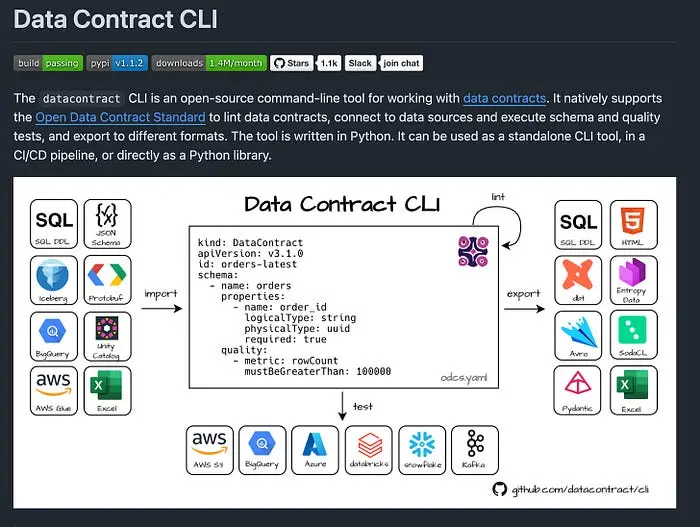
正如我所想象的,一个人使用Data Product CLI验证ODPS标准,然后遍历每个端口以检索契约ID(指向ODCS文件)。datacontract-cli将开始验证每个端口。
—
这些ODPS/ODCS文件将被提交并推送。
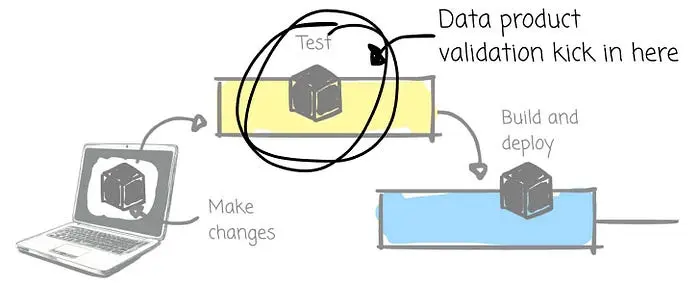
CI流程将开始并在此执行"物理"验证:契约定义的模式和数据质量。
除了CI,我认为验证可以在数据流动的地方发生:通过运行实时数据集来确认模式、质量和SLA承诺是否得到满足。
或者消费者方可以在所有内容之上运行自己的验证,确认他们实际接收的内容是否满足所有端口(契约)。
—
对于YAML文件验证,datacontract/product CLI可以帮助。
对于契约模式验证,我期望它是一个轻量级过程,你需要检查字段名称和类型是否正确;没有在消费者不知情的情况下重命名或删除任何内容。验证在模式信息(存储在中央存储库中)上执行
—
契约数据质量验证是繁重工作发生的地方。
基于我对数据质量验证引擎概念架构的想象。它必须有两个组件:规则引擎和计算引擎。
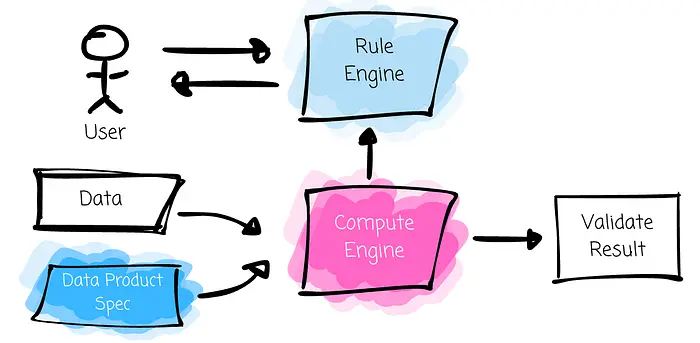
虽然一些规则可以使用元数据检查(例如,更新时间以验证新鲜度),但大多数质量规则需要数据扫描;必须考虑计算引擎资源。
此外,数据质量验证应该足够灵活,允许用户添加或调整规则。这就是规则引擎发挥作用的地方:它存储所有规则并暴露一个方法供用户与之交互。
关于引擎的技术栈,它将取决于你公司的上下文和要求。
理想情况下,这个计算引擎也是你公司用于数据转换的引擎,以避免语法不匹配。
然而,这不排除为不同的验证用例使用不同的计算引擎。例如,近实时验证可以使用Spark Streaming或Flink。
对于规则引擎,它可以是Great Expectations、dbt测试或自开发的解决方案。
—
需要注意的关键点是,没有称为"验证引擎"的单一标准解决方案,其组件取决于组织的需求和用例。
4、思考
像数据契约一样,数据产品(与一堆契约相关)也将面临文化障碍。
强制执行给人们更多的工作,并增加从原始数据到洞察的整体过程时间。
数据契约和产品通常不会给人们像"数据湖仓"、"数据仓库"或"ETL"那样的" tangible感觉"。它很容易变成人们觉得必须做的事情,而不是他们想要做的事情,因为它带来的好处。
因此,实现这些概念需要广泛的教育和协调,并涉及许多人。每当涉及很多人时,总是一项艰巨的任务。
—
如果你的公司已经实施或正在实施数据产品,请随时留言分享你的经验。我很乐意听到!
5、结束语
在这篇文章中,我阐述了我对数据产品的研究,它们解决的问题(通过不同的视角),然后讨论数据产品标准和验证机制。
感谢你读到这里,我们下篇文章再见。
原文链接: What Is a Data Product?
汇智网翻译整理,转载请标明出处