为什么我构建了 Relay
如果你正在构建智能体、内部开发者平台、MCP 基础设施、沙箱运行时,或者试图将 LLM 连接到大量现有服务,我希望你试试它。
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
API 描述了系统能做什么。但智能体仍然需要理解如何使用它。
我从事大规模电商系统的工作,在我们越来越多地试验 LLM 和智能体的过程中,有一个问题不断出现:
如何真正让智能体与公司已有的系统进行交互?
演示很容易。
给 LLM 几个 API,描述工具,然后让它调用。
现实世界更复杂。
在一家大型科技公司,你可能有数百甚至数千个服务。有些暴露 REST API。其他使用 GraphQL 或 gRPC。有些有 OpenAPI 或 Smithy 定义。有些有很好的文档。有些文档技术上正确,但没有告诉你任何人实际上如何使用这个服务。
而有趣的工作流几乎从不局限于一个系统。
在电商中,工作流可能看起来像这样:
一个业务工作流已经可以跨越几个独立设计的系统。
但这其实不是电商问题。
基础设施工作流可能经过服务目录、部署系统、Kubernetes、可观测性平台和事件管理系统。
安全调查可能需要身份数据、资产清单、云 API、审计日志和工单系统。
数据工作流可能跨越元数据目录、数据仓库、编排平台和对象存储,只为回答一个问题。
每个系统可能使用不同的协议、认证机制和数据模型。
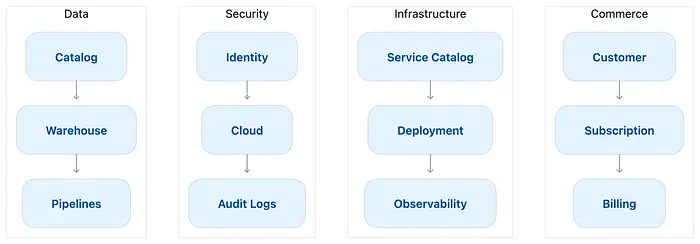
问题的模式在各个领域重复出现。
让 LLM 可靠地编排这些系统出奇地困难。
这就是我构建 Relay 的原因。
1、API 规范是必要的,但还不够
大多数企业服务已经有某种形式的结构化定义:
OpenAPI。Smithy。Protobuf。GraphQL schema。
这些是有用的。Relay 会利用它们。
但我发现,给智能体一个 schema 通常只给了它所需的一部分。
规范可以完美地描述每个参数和响应字段。
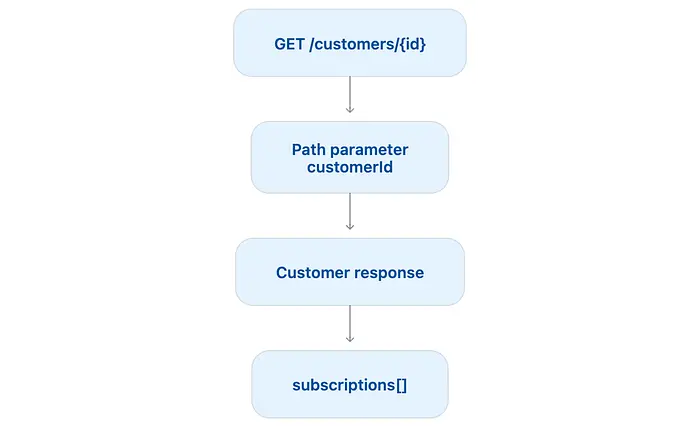
API 契约回答:我能调用什么?
它不一定告诉你:
- 你通常如何发现客户 ID;
- 应该先查询哪个系统;
- 哪些字段真正重要;
- 需要组合哪些 API 才能理解完整状态;
- 或者一个技术上有效的操作在当前工作流中何时没有意义。
同样的问题存在于电商之外。
基础设施 API 可以告诉智能体如何重启部署。它不会告诉智能体是否应该先检查发布状态、最近的配置变更和相关告警。
安全 API 可以暴露身份活动。它不会解释在决定该活动是否真正值得关注之前应该检查哪些其他系统。
这些知识通常存在于其他地方。
在代码中。在运维手册中。在文档中。在旧的讨论中。
而且通常在工程师的头脑中。
你可以让 LLM 检查代码库并弄清楚。
我做过。效果出奇地好。
但是它也很慢、昂贵且不一致。
一个大型代码库包含的信息远远超过智能体仅为回答所需的:
我该如何与这个系统交互?
在数百或数千个服务上重复这个过程感觉不是一种特别好的集成模型。
我想要更小、更有意图的东西。
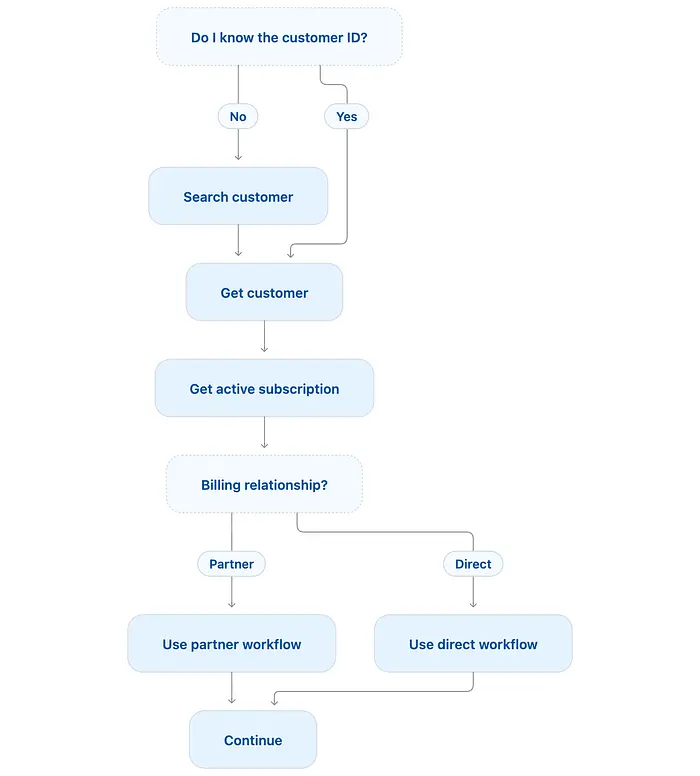
Skill 回答:我应该如何使用它?
2、能力应该知道如何解释自己
Relay 的核心模型很简单。
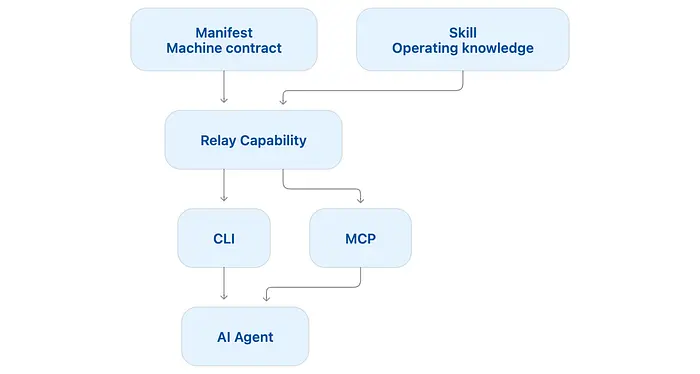
取一个系统能力,把两件事打包在一起:
Manifest = 存在什么
Skill    = 如何使用它
manifest 是机器可读的契约。
它描述了可用的操作、输入、传输、认证要求和权限。
Skill 包含不属于 API schema 的知识。
例如:
如果 ID 未知,先搜索账户。

在评估优惠之前,先获取活跃订阅。

对直接计费的客户使用一种工作流,
对合作伙伴计费的客户使用另一种。

如果返回特定状态,停止而不是
继续工作流。
然后 Relay 将它们打包成一个工具。
智能体可以发现工具的功能:
billing --describe
在相关时加载更深入的说明:
billing --skill
并调用操作:
billing get-subscription --account-id 123
目标不是将服务的整个架构放入模型的上下文。
而是给模型通向真实系统的最小有用接口。
3、为什么选择 CLI?
随着智能体开始看起来不像聊天机器人,而更像在计算机内运行的程序,这一部分对我来说变得更有趣。
如果智能体已经有一个包含文件系统、shell 和代码执行的沙箱,那么命令行是一个出奇好的集成原语。
LLM 已经非常擅长使用它。
它们可以检查帮助输出。
运行命令。
通过其他工具管道传递结果。
围绕多个操作编写小脚本。
将中间结果存储在文件中。
而且它们不一定需要在开始任务之前将每个可用能力加载到上下文中。
它们可以逐步发现。
如果环境包含 500 个能力,而任务只需要三个,我宁愿智能体发现那三个,而不是从加载所有 500 个定义开始。
这种模型感觉更接近我们已经使用计算机的方式。
4、Relay 不是 MCP 的替代品
Relay 支持 MCP。
我只是对边界有不同的思考:
能力是产品。MCP 是适配器。
如果智能体有 shell 访问权限,能力可能看起来像:
github get-repository ...
如果环境使用 MCP,Relay 可以通过 MCP 暴露相同的底层能力。
集成不需要围绕协议重建。
这是我发现 mcpc 这类项目有趣的原因之一。mcpc 接收现有的 MCP 服务器,使它们可以通过命令行访问,包括渐进式工具发现。
Relay 从相反的方向开始。
它从底层系统开始,创建一个可以通过 CLI 或通过 MCP 暴露的能力。
这种区别很重要,因为 MCP 是一个重要的接口,但不是智能体可能需要使用该能力的唯一环境。
5、协议不应该是抽象
企业不使用单一协议。
单个工作流可能涉及:
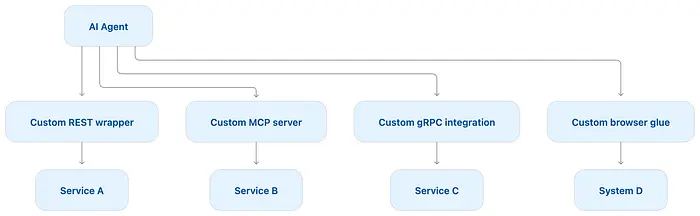
但如果智能体的目标是:
查找客户的当前订阅。
它实际上不应该关心答案来自 REST 还是 gRPC。
同样:
弄清楚这个服务为什么不健康。
不应该以智能体决定部署 API 是否是 REST、遥测系统是否是 GraphQL、内部依赖是否恰好使用 gRPC 开始。
有用的概念更接近:
检查服务
检查部署
查询日志
查找负责人
重启工作负载
Relay 目前将 REST、GraphQL、gRPC 和基于会话的 HTTP 放在同一个能力模型之后。
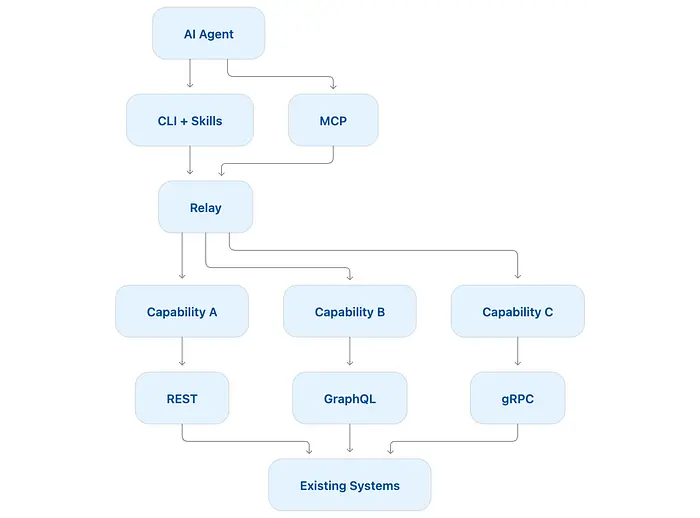
围绕系统做什么来定义能力,而 Relay 处理如何到达它。
底层协议对运行时仍然重要。
它们只是不必成为智能体推理的抽象。
6、分发是问题的一部分
构建一次集成是不够的。
你还需要将正确版本的集成放到智能体运行的机器上。
你需要接口和它的操作说明保持在一起。
这就是为什么 Relay 将 manifest 和 Skill 打包到工具本身。
一个能力可以构建:
relay build github.yaml --skill SKILL.md
并作为可执行文件分发。
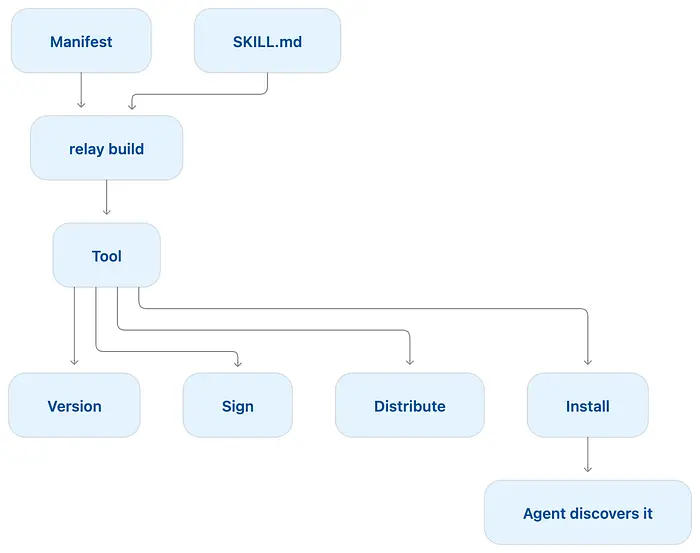
将智能体能力更多地视为软件包,而不是提示词配置。
接收环境不需要原始 manifest、Skill 文件或源代码仓库来理解工具。
包携带了这些信息。
Relay 的本地运行时然后处理凭据、会话、权限和传输。
目标仍然需要安装 Relay,但单个能力成为小型可分发单元,而不是必须在每个智能体环境中重建的集成项目。
我开始将它们视为 智能体的软件包,而不是"工具定义"。
构建它们。版本化它们。签名它们。分发它们。安装它们。
让智能体发现它们。
7、我想用 Relay 探索什么
Relay 还处于早期。
但我感兴趣的更大问题已经变得清晰得多。
我不认为公司会手动将数千个现有系统一个一个变成定制的 AI 集成。
我也不认为让 LLM 每次通过阅读源代码重新发现每个系统的工作方式是答案。
需要介于两者之间的东西。
一个层,将我们已有的系统变成紧凑、可分发的能力,智能体可以理解和操作。
底层的东西可能是电商服务。Kubernetes。身份系统。数据仓库。可观测性平台。甚至是一个十年的内部 API。
抽象不应该改变。
数千个现有系统
            ↓
小型、有意图的能力
            ↓
     CLI / Skills / MCP
            ↓
智能体编排真实工作流
这就是 Relay 背后的实验。
它不是另一个 REST 包装器。
它不打算取代 MCP。
它也不假设每个现有系统都需要为 AI 重建。
它是尝试给智能体一个一致的接口,通向已经存在的复杂系统。
8、试用 Relay
Relay 是开源的:github.com/abhishek-cha/relay
如果你正在构建智能体、内部开发者平台、MCP 基础设施、沙箱运行时,或者试图将 LLM 连接到大量现有服务,我希望你试试它。
看看抽象在哪里起作用。
更重要的是,告诉我它在哪里失效。
原文链接: Why I Built Relay: A Better Interface Between AI Agents and Real Systems
汇智网翻译整理,转载请标明出处