多 Agent 交接:把"写条"换成四字段契约与台账
一张任务单能说清哪里疼,却让下一个 agent 开不了工。交接要写成四字段契约,状态交给 append-only 台账推导。
一句话结论:多个 coding agent 之间真正缺的,不是"把话传过去",而是一份能被脚本校验的交接件——它必须写明从哪个提交开始、跑哪条命令、什么算对、谁来验收;再加一张只追加的台账,让"谁在跑、卡了多久、花了多少"由机器推导而不是由人记录。你手写的那条,其实是一张症状描述,不是执行契约。
披露:本文编译三篇 2026-10 的一手实践文章 + 一份 Agent Board 实验记录(作者自建项目的运行数据),并补充编者按。原文作者均自披露立场(详见文末"边界")。我们没有独立复现任何实验;文中所有数字都标明来自哪一篇。
一、票据说对了症状,执行者还是开不了工
原文举的例子小得刺眼:一个 CSV 导出丢了筛选条件。任务单写着"CSV 导出丢失筛选"。
这句话准确描述了哪里疼。但它没有告诉执行者:
- 从哪个仓库版本开始改;
- 用哪条命令跑起来;
- 什么算对(预期输出);
- 谁能验收这次改动。
于是执行者只能先猜。而"猜"正是你想自动化掉的那部分。
作者给的判断方法很实用:比较任务跟踪与托管执行,要比职责,不要比标签。任务跟踪器可以是一个管理良好的执行系统的一部分;agent runner 也可能被管得很糟。区别只在于——交接有没有把下面四件事写清楚:
| 维度 | 要回答的问题 | 常见糊弄 |
|---|---|---|
| Context(上下文) | 能从哪个确切版本开始?相关行为、约束、允许改的文件是什么? | "在 main 上改一下";用一段长对话代替一份短而新的规格 |
| Runner(执行者/环境) | 谁是授权操作者?环境是否已知(依赖装好、权限拿到)? | 只写"交给某个 agent"——如果没人装依赖、没人能授权仓库访问,写了等于没写 |
| Evidence(证据) | 交付里有没有补丁版本、真实跑过的命令、结果、没测的用例? | "done" 只是一个状态标签,不是验证记录 |
| Acceptance(验收) | 谁负责判定"结果满足要求"? | 执行者自己把需求悄悄换成"更容易实现的那种理解" |
这四条不需要任何特定工具就能落地——这也是它们有用的原因:它们在工具登场之前就已经能判分了。
二、把交接写成契约(模板可直接抄)
原文给了一份 CSV 修复场景的模板(明确说明:尖括号里的值必须来自真实项目、命令名不许凭空编)。中文化并通用化后是这样:
task:      一句话说明要保住的行为
context:
  repository:  <已获授权的仓库>
  base_revision: <核实过的提交>
  reproduction: 复现步骤(选中 status=open,再导出 CSV)
  expected:   导出内容恰好是匹配筛选的行
  fixtures:   <脱敏后的样例数据路径>
scope:
  allowed:    导出查询 + 针对性的回归覆盖
  excluded:   认证、schema 迁移、无关的 UI 改动
execution:
  operator:     <开发者或已授权的 agent 操作者>
  setup_command: <本仓库核实过的命令>
  test_command:  <本仓库核实过的命令>
  permissions:   仅使用已有的开发权限
delivery:
  patch_revision:        必须
  commands_and_results:  必须
  sample_output:         样例数据导出的脱敏 CSV
  untested_cases:        必须写,即使为空
acceptance:
  product_owner: 确认筛选语义
  engineer:      评审实现与回归证据
有三条硬规则附在模板上:
- 不要把凭据粘进契约。执行者用自己已有的授权工具和账号。
- 环境不可用是"执行阻塞",不是"共享账号"的邀请——这两者混在一起,就是审计黑掉的开始。
- 模板是提议的操作实践,不代表某个平台已经自动提供了全部字段。
注意 untested_cases: 必须写,即使为空。这一行比它看起来重要:空着不写和写"没有"是两回事,前者是信息缺失,后者是一个可核对的声明。
三、走一遍:复现 → 范围 → 证据 → 双人验收
原文用同一个例子走了一遍完整交接。这个过程值得完整保留,因为它正好是"人在环里"该待的位置:
- 产品负责人造 fixture:三条记录,两条 open、一条 closed;期望的筛选导出恰好两行。
- 工程师确认行为并指出导出路径(谁改哪一块先定下来)。
- 执行者先在记录的 revision 上复现失败。如果复现不出来,下一次有用的交付不是代码,而是"尝试过的命令 + 环境细节 + 观察到的输出"。在版本不一致的情况下改代码,很可能是在修另一个问题。
- 复现之后再动手:范围化改动 + 为筛选导出补覆盖;同时检查未过滤导出——因为修好一条路,容易顺手把另一条路收窄。
- 交付附 patch revision 与真实命令输出。
- 两人分别验收:工程师看实现与回归证据;产品负责人看脱敏样本,确认"筛选"的语义是用户以为的那个。
- 任一验收不过:在同一张任务单上记录原因与下一次尝试。
原文诚实标注了这一点:这些只是提议的检查,没有声称跑通、没有声称有测试通过。这种标注本身就是标准的一部分——没跑过就别写成跑过。
四、换工具也要能读:可移植版五字段 + 五段证据
第二篇(同一作者)把同一件事做成可移植版:一个人用终端 agent,一个人用 IDE 助手,交接件仍要能读。
关键判断:可迁移的是任务契约(输入、允许的改动、必需证据、评审人);对话历史只是可选上下文。
五字段:
outcome:   交付后应成立的一句话
scope:     allowed(允许改什么)/ excluded(明确排除什么)
inputs:    revision / 关键参数 / 复现用的合成输入
acceptance: 逐条可判定的验收用例(含"保持不变"的行为)
stop_when:  什么时候必须停手交回
stop_when 是这篇最有价值的一栏,通常写三条:
- 解析契约与已记录行为冲突;
- 改动需要动生产配置;
- 无关的失败让对比不再可信。
五段证据协议(交付时按此格式回):
Before:      命令、退出码、观察到的输出、base revision
Change:      改了哪些文件、每个文件为什么必要
After:       同一复现、聚焦测试、真实退出码
Uncertainty: 没跑的检查,以及为什么没跑
Review:      提交引用 + 具名验收人
两句判据值得单独记住:
"模型说校验修好了"是假设;一条命令和它的输出,才是"某个检查跑过"的证据。 评审者仍要判断:这条检查是否覆盖了目标失败。
还有两道容易被跳过的门:
- 资格门在比较能力之前。先看访问权,再看专业度。一个很聪明的同事,如果没有仓库权限,不合格——"别人可以把 token 贴给他"不算资格。
- 诚实的非结果。原文的例子很好:执行者发现"worker 数量设 0"在这个仓库里是有意的自动伸缩。此时正确动作是停手交回事实、修订需求,而不是改掉现有行为去满足一个自己编出来的测试。
收尾四查(验收人动手前):核对记录的 revision、复现点名的那几个用例、检查错误信息有没有顺带泄露配置、检查 diff 里有没有混进部署或无关清理。
五、把交接做成对象:Work Order 与 Work Report
第三篇走的是另一条路:不用模板,用对象。
作者的观察很直接:agent 之间传消息很容易;难的是把"需求、已定决定、结果、校验、未完成工作"一起存住。研究 agent 把结论交给编码 agent 时,后者需要的不是一段总结,而是原始需求、约束、已经做过的决定、结果、未解决问题、下一步。
于是做成两类文档:Work Order(派活)和 Work Report(回报),三个入口共用同一套模型与校验规则:
- TypeScript:
agent-work-layer(schema、校验、生命周期、交接) - MCP:
agent-work-layer-mcp(Claude Code 等客户端可以通过 MCP 工具创建/接受/报告/评审) - Python:
agent-work-layer(PyPI,同文档模型、同校验规则;两个实现跑共享测试用例,同一份文档给出同样结论)
真正有意思的是它中间的 MCP 网关:worker 不直连真实工具,而是经过网关,每个 Work Order 只能调它允许的工具、只能花它的预算,每次调用都记为证据。
0.7 版加了一层"副作用闸"——staged tools:
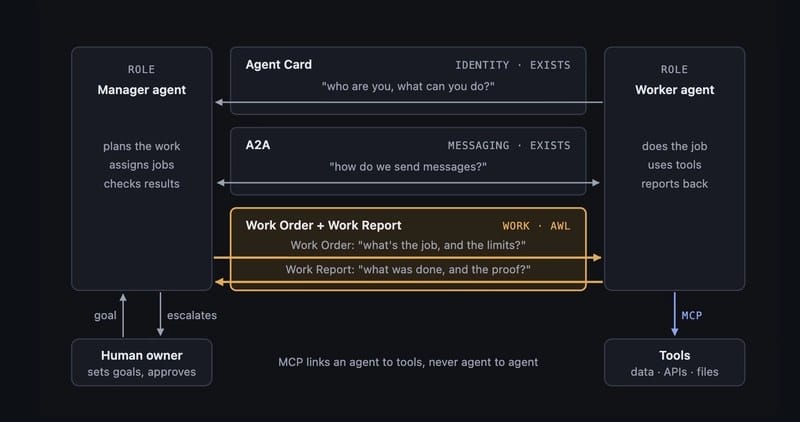
图:源文 0.7 版的 staged tools 示意——读直通、写被扣住、批准后执行一次。(图源:dev.to @murthyg,2026-10-16)
它的机制值得抄:
- 读照常:worker 还能研究;只有被列为 staged 的调用等待。
- 写被扣住:网关照常计数、记录参数,但不转发;worker 收到类似
pending:gmail/send#3的占位符,并在报告的effects里列出这次调用。 - 经理决定:批准 → 网关按序执行一次;退回 → 直接丢弃,因为什么都没跑过,所以没有要撤的东西。
四个"真跑过才发现重要"的细节:
- 可以只批准部分副作用(
effects: ["gmail/send#3"])。 - 副作用之间可以相互依赖:还没创建的 issue 没有编号,后面的调用可以用
{"$ref": "github/create_issue#3", "pointer": "/structuredContent/number"}引用,执行时回填。 - 每个副作用至多执行一次:执行前先拿报告里的每个 effect 与网关实际日志对账,对不上就一个都不跑;重复
--commit也不会重发,即使中途崩过。 - 子 agent 绕不过去:worker 不能把 staged 工具交给子 agent——子 agent 的写会在 worker 批准时就执行,那早于经理看到任何东西。
另外还有两个小东西:progress()(worker 边做边发进展)和 trackRecord()(一个 worker 的历史:一次批准、退回返工、失败、过期,以及花掉多少预算)——评审一个人的可靠性,要看这些,而不是看它的自述。
原文作者是这三个包的作者,属于"自己在做这件事"的立场,读的时候要打折。
六、台账:状态不要"存",要"推导"
如果说前三篇解决"交接件写什么",Agent Board 解决的是另一半:交接之后你还能不能看清全局。
问题陈述只有三句话:并行跑一堆 agent 时,你没答案的是——它还在干活吗?卡住了吗?烧掉多少额度了? 原始需求更狠:要一个"永远准确"的页面。作者随即指出这是分布式系统问题:agent 在任何单个进程之外启动和死亡、异步上报、崩溃时靠沉默撒谎。
它的做法是:把看板当作台账的投影,台账是唯一真相源。四条不变量:
- spawn 之前先注册:任务行存在得比进程早,所以经支持路径启动的 agent 不可能不被记录。
- unknown 保持 unknown:不估百分比、不推断退出码、不猜用量。拿不到可靠 pid 的 Claude 会话,进程状态就显示 unknown,Stop 按钮直接置灰。
- 推导,不存储,健康态:status 是生产者记录的事实;health 是读取时由 status + idle 时间算出来的。
- 永不阻塞 agent:埋点必须 fail-open——台账忙的时候丢事件,而不是让 agent 变慢。
三个生产者
- 启动包装器:先写任务行,再以 JSON 事件模式 spawn;子进程活着时每 15 秒心跳,记录 exit code;spawn 失败记
failed+ 退出码 127(而不是消失);信号转发在发 prompt 之前就装好,所以 stop 能到子进程。测试专门验证顺序:假 agent 在第一个事件前卡住,测试轮询台账断言"行已存在"。 - Claude 生命周期钩子:start/stop、prompt 提交、helper 起停、工具调用前后。生命周期钩子同步跑,工具钩子异步跑(不给 agent 加延迟)。每个钩子 25 ms 锁等待 + 150 ms 工作预算,目标 200 ms 内退出;超时就记日志丢事件;永远 exit 0,且绝不写 stdout——因为任何打印都会被注入回 agent 的上下文。
- 对账器(每 5 秒):running 但进程没了且没有 exit →
lost;running 空闲超 600 秒 →stalled,下一个事件翻回;扫进程表找出没走包装器的 Codex 进程,向上最多走三层父进程避免重复计数,按 pid 记为untracked,进程退出后变lost。
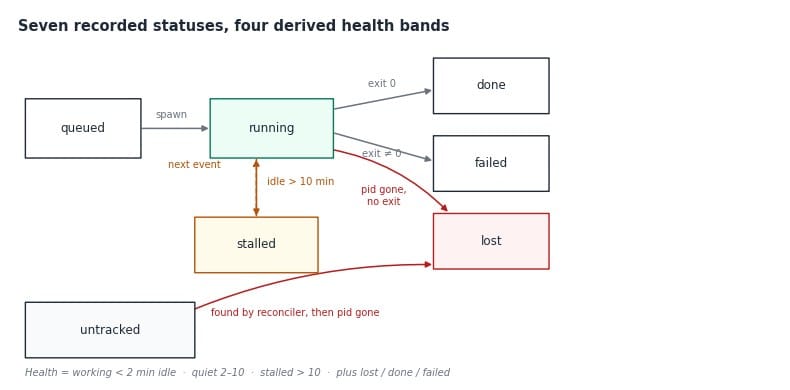
图:据 Agent Board 原文第 5 节重绘的七状态与四档健康(working < 2 分钟空闲 / quiet 2–10 / stalled > 10 / 另有 lost、done、failed)。(编者重绘,数据来自源文)
进度只在有分母时才存在
这条规则很值得抄:"完成度"只在声明了分母时才显示。带步数启动的 run 会让 agent 输出 PROGRESS n/total 行,台账从消息里解析;Claude 任务用 checklist 的已完成/总数,每轮清空;其它一律显示"未上报"。即便有,那也是 agent 自己的声称——时间线才是证据。
准入控制:一个写者、两个槽位
同一仓库的并发由内核 advisory lock 限住:锁根由 checkout 路径的哈希推出;每次写先拿排他写锁(一个 checkout 一个写者),再抢两个槽位锁之一(无阻塞尝试,都占满就阻塞在槽 0)。上限是每个仓库两个包装器控制的 run。没有 sentinel 文件、没有 sleep、没有轮询循环,持有进程崩了,内核关闭文件时自动释放。
为什么是 2 而不是 3:这是证据而不是口味。第一天全部 high effort,Codex 周额度一天掉到只剩 11%,第三条并发运行卡住而两条在跑。同批规则还包括:发布类工作(全量测试、浏览器套件、批量部署)走单独的全局浏览器锁 + 源绑定回执;每次 run 带 token 预算(默认 4,000 万),超额停止并 exit 125。
运行记录(2026-09-08 ~ 10-23 的只读统计)
| 指标 | 值 |
|---|---|
| 任务行 / 事件 | 28,149 行 / 540,175 条 |
| 按来源 | 8,331 Codex(Astra)、7,267 Claude 会话、12,373 Claude helper、178 其它 Codex |
| 包装器启动的 Codex | 1,380 done、116 failed、267 lost |
| 包装器之外发现的 Codex 进程 | 6,568 个,全部以 lost 结束 |
| 完成 run 的平均墙钟 | 7.95 分钟(803 次) |
| 评审判决 | 160 APPROVE、337 FIX、87 INVALID |
| 工作项 | 95 done、22 waiting、15 doing、19 idea |
| 测试 | 22 个 Python 文件 188 个测试方法 + 12 个浏览器脚本 |
最大那个数字最有教育意义:绝大多数 Codex 行压根不是包装器启动的——它们是对账器自己抓到的、以 untracked 进入、退出时变 lost 的进程。那既是对账器在干活,也说明有多少 agent 活动本来完全不可见。
五类真实失败
- 杀链反应:杀掉评审者 → 返回信号退出 → 判决解析成 INVALID → 触发修复循环 → 又spawn 一个 worker 和一个评审。每杀一次多出两三个任务。 修法:被信号终止的评审者以
STOPPED判决结束链条。 - 预算结构:第一天 36 个任务、约 24 agent 小时,全 high effort。分解后发现:重读上下文约 25%、超大命令输出 18%、重复的全量验证 12%、例行工作开 high effort 12%。角色、有界包、发布窗口、两 run 上限都是从这里来的。
- 幽灵 helper:从不关闭的 helper 显示"卡了几百小时",把界面淹了。改为按项目聚合 + 15 分钟空闲移出。
- 锁竞争:另一个渲染服务持锁时,板子自己仓库的构建报
database is locked。运维规则:在那里构建时暂停该服务。 - "先报 ready 再验证":界面工作在没人用真数据打开过真浏览器之前就报了 ready。新规则:UI 没被看过截图就不算 ready。
七、评审闸:包、判决语法、一轮修复
实现被当作一个角色 worker 跑,之后是独立评审。评审者拿到的不是对话,而是一个包:
- 任务本地 diff;
- 最多 200 行测试输出;
- worker 报告;
- 原始 brief 的路径;
- 全部塞进 256 KB 预算。超预算时,先丢未变化的上下文和非测试文件的正文,同时给评审者能自己打开的恢复路径;大于 8,000 字节的 prompt 存成文件、按引用传。
判决语法是严格的:只允许 APPROVE,或者一份编号的修复清单。其它任何内容一律归为 INVALID。FIX 只回一轮,然后第二次评审;仍不解决就 exit 2,进入 Needs you 队列——没有任何东西会自动升级。评审者可以是 Astra、Kimi,或两者都要(两者都批才算过,分歧单独标注)。
台账里 584 条判决:160 APPROVE、337 FIX、87 INVALID。修复请求是批准的两倍——作者说这正是循环的目的,不是坏信号。
Needs you 是"只有人能解"的队列,算出来而不是攒出来,五个来源:两小时内失败的任务、还在要改的评审、两小时内手工提出的需要、15 分钟内活跃 Claude 会话提出的需要、waiting 泳道里指派给我的工作项。三条抑制规则让它又短又真:
- 某个需要在它最新信号之后被确认过 → 抑制;
- 某次失败之后,同目录或同标题的后续 run 成功了 → 抑制;
- 需要按任务去重,只留最近信号。
每列最多显示 5 条,其余折叠。作者的原话是:需要你,最多五条,只留真实且当前的。
八、讨论这一层:限轮共识与"两堆分类法"
前面都在讲"交接什么",但你要解决的还有"方案怎么谈"。这块最实用的是 XMPro 那篇(厂商 CEO 观点,立场明显,但框架好用)。
共识循环:agent 对计划有分歧时迭代——交草案 → 暴露冲突 → 修订 → 再来。能解决大多数分歧,但不是全部;解决不了就升级给人。
但升级是有成本曲线的:一个团队偶尔升级叫治理;五十个团队每次谈不拢都升级叫洪泛队列,而被淹没的人会默认批准。这就是 automation bias(Parasuraman & Manzey 2010 的综述;欧盟 AI Act 第 14 条"人类监督"直接点名了它)。橡皮章和有效控制,在正常情况下产出完全一样,差别只在那个真正要紧的案子上才暴露。
由此得到一条硬约束:agent 的算力便宜,能裁决的人不便宜。任何"把所有未决分歧都送给人"的设计,都是一个贴着"监督"标签的瓶颈。
"两堆分类法"(我很推荐拿它体检自己的升级队列):把这周推给人的最近二十个决定分成两堆——
- 第一堆:双方对"会发生什么"有分歧(数据不同、历史不同、对同一个杠杆的信心不同)。这堆不该占用人,它需要的是让两方看到同一份证据。
- 第二堆:双方对"会发生什么"一致,但对"想要什么"有分歧(吞吐 vs 能耗、这个客户的单 vs 那个客户的单)。这堆才值得一个人的一天。
如果你的队列大部分在第一堆,那你是在用治理流程跑一个证据问题,加审批人不会修好它。
分工的关键一句:让 agent 负责策略,让数学负责成交。在 NEC × XMPro 的测试床里,每个 agent 只决定两件事——八个时段的权重、以及自己的离场底线:
U(o) = w1·u1(o1) + w2·u2(o2) + … + w8·u8(o8) 仅当 U(o) ≥ r 才接受
成交由 NegMAS 的交替出价协议完成:没有任何语言模型出价、让步或宣布成交。同样的位置进,同样的协议出,可审计到每一条出价;一次完整谈判约 1 秒;真的没得谈时,agents 走开——那也是正确答案。
于是可以在"强行达成一致"与"叫人"之间插第三个阶段:调解者提出候选结算,先过约束过滤(违反硬约束的候选永远不会被提出),每个 agent 只判断"这个候选是不是比桌上的更好",任何一方可否决,且不必暴露自己的权重。人收到的就不再是"两个草案 + 死锁通知",而是谈不拢的短清单 + 出价 + 谁否决了什么——这是几分钟能做的决定,不是一场调查。
另一篇(角色与边界那篇)补了四条工程纪律,都很短:
- 角色 = 一个 job + 一个可检查的输出。"帮我做市场"不是角色;"研究竞品并交出带来源列的结论表"是。
- 边界放进工具,不要放进提示词。评审者能读 diff、能评论,但不能合并;指令可以被忽略或误读,缺失的工具没法被使用。
- 交接要显式:说出 artefact 是什么、为什么移动、接收方必须检查什么,并留一份交接日志(这样"决定是从哪一步开始变味的"才有答案)。
- 协调者要有预算:最多重派几次、时限多少、连续失败两次怎么办。而且协调者报告要指得出每个产出的证据,不是"全部完成"。
最后一句最像经验之谈:先两个角色、一条交接,把它跑到"无聊",再加第三个。 大多数团队会发现第二个角色比第一个难设计,第三个更难——那是该放慢的信号,不是该再加 agent 的信号。
九、拼起来:三层各写什么、谁写、缺了会怎样
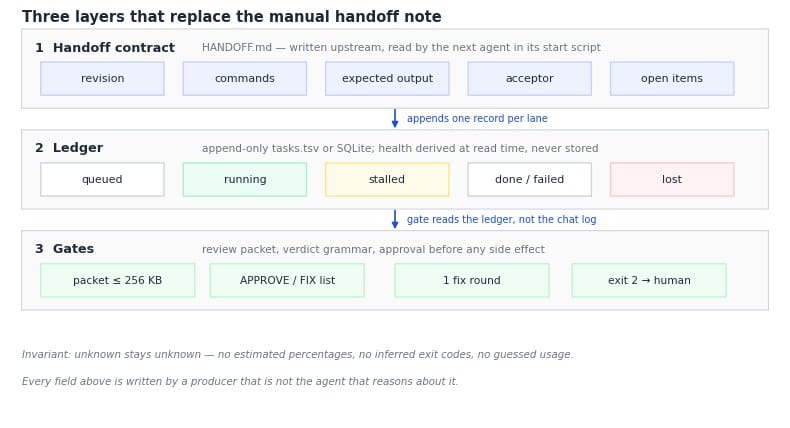
图:三层结构——交接件写给下一个 agent,台账写给机器推导,闸门卡在副作用之前。(编者绘制,字段与阈值来自上述四份源文)
| 层 | 产物 | 谁写 | 谁读 | 缺了会怎样 |
|---|---|---|---|---|
| 交接件 | HANDOFF.md(五字段 + 五段证据) |
上游任务负责人 / 上游 agent | 下游 agent 的启动脚本 | 下游开始猜,或回头问你——就是现在这样 |
| 台账 | tasks.tsv 或 SQLite(只追加) |
包装器、生命周期钩子、对账器 | 看板、闸门、协调者 | "谁在跑/卡了多久/花了多少"没有答案;崩溃时靠沉默撒谎 |
| 闸门 | 评审包 + 判决 + 审批 | 独立评审者 / 有权限的人 | 合并、部署等有后果的动作 | 报告被驳回时,邮件已经发出去了 |
三个真正的自动化点(不是"让 agent 更聪明",是"让人少写一次"):
- 上游收尾时自动生成交接件:模板 + 一个校验脚本,检查四字段是否齐、
acceptor是否等于implementer、base_commit是否真实存在。 - 下游启动时自动读交接件:启动器把
HANDOFF.md拼进第一轮上下文,而不是你去聊天框里粘贴。 - 闸门卡在副作用之前:不是"报告交上来再驳回",而是写操作先排队等批准——这正是 staged tools 的价值:拒绝之后不需要撤销任何东西。
十、边界与坑
- 台账只覆盖走包装器的 run。Agent Board 里 6,568 个"包装器之外被发现"的进程,就是这条限制最好的证据:绝大多数活动本来是不可见的,你必须先承认有一部分抓不到。
- 心跳只证明活着,不证明有进展。健康态是 liveness 信号,作者在板子上也这么写。
- Claude hooks 拿不到可靠 pid,所以板子上停不掉它;进度计数是agent 自报;预算也要从 agent 自己的 token 事件里数。
- 判决语法过严会付出代价:584 条里 87 条 INVALID(约 15%)。严格是对的,但要有一个人定期看 INVALID 长什么样,否则模型被"格式"卡住而不是被"内容"卡住。
- 锁与构建会打架:
database is locked出现过,规则是构建时暂停持锁服务。 - "先报 ready 再验证" 是最常见的自欺:UI 没人在真浏览器、真数据里看过,就不算 ready。
- 别把凭据写进交接件。这是原文唯一用加粗强调的禁令。
- 四字段不是签收单。它防的是"开不了工",不防"做错了"——后者靠证据包与验收人。两者别混。
- 国内环境的适配要自测:MCP 网关这类东西对本地模型、内网 MCP server 的兼容性差异很大,别按文档假设能用。
十一、三步落地(每步带判据)
第 1 步(一周):交接件模板 + 校验脚本。 写进仓库的 HANDOFF.md 模板(五字段 + 五段证据),加一个 30 行的校验脚本。判据:连续 10 个任务里,下游没有一次因为"缺信息"回来追问。
第 2 步(一周):启动包装器 + 5 秒对账器。 先写台账行再 spawn;15 秒心跳;对账器把"进程没了但没 exit"判成 lost,把空闲超 10 分钟判成 stalled。判据:任何时刻都能回答"谁在跑、卡了多久、花了多少",并且 unknown 没有被填成 0。
第 3 步(一周):只读评审者 + 判决语法 + 一轮修复上限。 评审只给包不给对话,判决只能是 APPROVE 或编号清单;FIX 只回一轮,仍不解决进"需要你",该队列超过 5 条就先停下来修流程,而不是继续加班审批。判据:修复请求/批准比例稳定,Needs you 常驻不超过 5 条。
讨论那一层放到第 2 步之后:先给"计划"一个独立关卡(只读的 plan-adversary),再给它两轮上限,谈不拢就走升级——否则你会得到第 8 节里那个被淹没的审批人。
编者补充:和站内已有的几篇怎么接
- 第 66 篇《多 Agent 写代码:代码是最简单的部分,协议才是系统》给的六条契约里,本文把隔离状态、独立验证、审批边界三条落到了字段级(见 那篇的六条契约)。
- 第 24 篇《Agent 交付验收:声明与 diff 对账》解决"声明是否属实";本文第五节的 effects 对账(报告里的每个副作用先与网关日志核对,对不上就一个都不跑)是同一思路在副作用层的实现(见 claimcheck 与三树差分门)。
- 第 23 篇《1,866 个项目的 Agent 说明书实测》讲长期策略该放哪;本文的
HANDOFF.md是单次任务的契约——AGENTS.md 管规则,HANDOFF.md 管这一次(见 AGENTS.md 实测)。 - 第 64 篇讲 Git 作者与凭据归属;交接件里的
owner_agent必须和提交归属对得上,否则台账与git log会讲两个故事(见 多 Agent 同机:Git 作者与提交归属)。
边界
- 本文为编译整理,四份源文的关键结论与数字均来自原文,我们未独立复现任何实验;原文中"提议但未执行"的检查已在正文标注。
- 立场披露:前两篇(dev.to @hiroshi_takamura_c851fe71)作者自披露"AI 辅助撰写、示例未在生产仓库跑过",并引用 Wagglet 的产品页作为工作流参考;第三篇(dev.to @murthyg)作者是
agent-work-layer的项目作者;Agent Board 是作者自建项目的单机、单操作者运行记录(其局限见源文第 12 节);XMPro 一篇是厂商 CEO 的观点文。 - Agent Board 的数字是一个操作者、一台机器、一个订阅的记录,不能直接外推成团队或企业规模的表现。
- 各工具的字段名、阈值(256 KB / 200 行 / 15 秒 / 10 分钟 / 4,000 万 token)都是源文的具体取值,不是普适标准,请按自己的仓库与预算重新标定。
- 术语:lane 译"车道"、worktree 保留原名、packet 译"评审包"、staged tools 保留原名。
相关阅读:Claude Code 与 Codex 交接:哪些状态搬得过去 | AI 编程 / Vibe Coding 完全指南 | Agent / MCP / 自动化完全指南 | 多 Agent 写代码:协议才是系统 | Agent 交付验收:声明与 diff 对账 | 1,866 个项目的 Agent 说明书实测 | 多机并行 coding agent 实战栈
Sources
- A task record is not an execution contract: a handoff template for coding agents,dev.to,2026-10-12:https://dev.to/hiroshi_takamura_c851fe71/a-task-record-is-not-an-execution-contract-a-handoff-template-for-coding-agents-4bp8
- A portable handoff contract for teammates using different AI tools,dev.to,2026-10-15:https://dev.to/hiroshi_takamura_c851fe71/a-portable-handoff-contract-for-teammates-using-different-ai-tools-4ige
- Stop AI Agents from Acting Before You Approve: Work Orders for TypeScript, Python and MCP,dev.to,2026-10-16:https://dev.to/murthyg/how-to-build-reliable-work-handoffs-between-ai-agents-in-typescript-1neh
- Sam Ochoa,Agent Board: coordinating concurrent AI coding agents with a shared task ledger(WP-05),2026-10-23:https://samuelochoa.com/papers/agent-board/
- Pieter van Schalkwyk,Should Multi-Agent Systems Negotiate?,XMPro,2026-10-19:https://xmpro.com/should-multi-agent-systems-negotiate/
- Running a Team of AI Agents: Roles, Boundaries, and the Handoffs That Break,dev.to,2026-10-24:https://dev.to/flisk/running-a-team-of-ai-agents-roles-boundaries-and-the-handoffs-that-break-4fe9
本文由 hubwiz 编译整理,转载请注明出处。
这是「AI 编程 / Vibe Coding」专题的一部分。完整地图见:AI 编程 / Vibe Coding 完全指南