Agent Loop不是 while (true)
差别不在语法。这是一个喋喋不休的 demo 与一个知道发生了什么的系统之间的差别。
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
大多数关于 agent harness 的讲解都停在那张熟悉的图上:
model
  ↓
tool call
  ↓
tool result
  ↓
model again
这张图没错,只是太小了,描述不了真正的问题。
当 agent 运行在真实环境中——工具并发执行、用户随时打断、进程崩溃、任务寿命超过 HTTP 请求、某些操作带有副作用——难的问题就不再是"我该如何再次调用模型?"
难的问题是:
还有什么工作没有解决?谁有权解决它?进程死掉之后还剩什么证据?
这才是 agent 循环真正的工作。
这也是 Pi、Pi Durable 和 DeepSeek Harness 值得对比的原因。它们不只是"LLM 加工具"的三种实现,而是把运行时控制平面放在了不同的位置:
- Pi 刻意把核心循环保持得很窄,并暴露接缝(seams),让宿主应用掌握策略。
- Pi Durable 开始把对话、提交、工具工作和恢复转化为持久的运行时状态。
- DeepSeek Harness 把循环、收件箱、调度器、恢复模型和会话事件日志都当作运行时契约本身的一部分。
研究它们的有用方式不是逐个功能对比,而是问:当系统还欠一次动作时,谁知道?
1、Agent 循环究竟是什么
先看一个编码 agent 的请求:
"修复失败的登录测试。读取相关文件,运行测试,必要时修改代码。"
模型响应了两个工具调用:
read_file("src/auth.ts")
run_test("login")
假设两者开始并发执行。
三秒后,用户补充道:
"不要修改配置文件。"
到这一步,系统已经不再是一个玩具循环了。
运行时必须决定以下所有问题:
- 新的用户消息属于当前工作还是下一个任务?
- 它能否取消已经开始执行的工具?
- 工具返回后,模型还需要看到它们的结果吗?
- 如果某个工具声称信息已足够完成任务,它能就此结束任务吗?
- 如果工具执行期间进程崩溃,该工具是从未启动、启动未完成,还是完成了但结果没被记录?
- 如果模型撞上 token 上限,这一轮算完成、被中断、可重试,还是仍在进行?
这些问题全都是循环语义,但它们并不都是普通编程语言意义上的控制流。
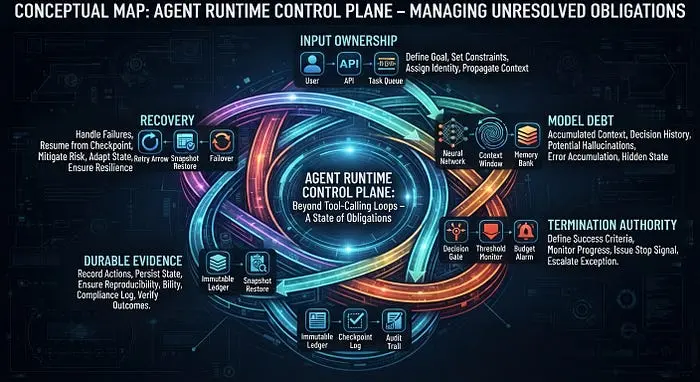
更好的理解方式是把它们看作债务(debts)。
2、真正重要的两种债务
第一种是模型债务(model debt)。
工具返回了结果。模型是否还欠系统一次决策?
assistant → tool call
tool → result
在许多 agent 设计中,工具结果会产生一项义务:
tool result
    ↓
model must inspect it
但也许工具已经产出了最终的结构化输出,或者工具报告任务可以终止。在这种情况下,运行时可以判定不需要再调用一次模型。
第二种是消息债务(message debt)。
是否有输入正等待展示给模型?
这些输入可能包括:
- 用户的转向(steering)指令。
- 一个后续请求。
- 插件注入的上下文。
- 一个恢复事件。
- 一个被标记为不确定的工具结果。
- 一个需要人工批准的策略决定。
工具可能声称任务已完成,但这不会抹掉排队中的用户消息。
这个区分写下来显得理所当然,然而令人惊讶的是,仍有大量 agent 系统把这两个概念坍缩成一个布尔值:
should_continue = true | false
当用户、工具和运行时事件在不同时刻到达时,这个布尔值就变成了陷阱。
更有用的心智模型是:
Agent loop = a settlement engine for unresolved work
而不是:
Agent loop = repeatedly call the model
仅仅这一个框架上的转变,就解释了 Pi、Pi Durable 和 DeepSeek Harness 之间大部分的架构差异。
3、为什么现在这很重要
对于短命的聊天机器人,经典循环通常就够了。
用户提问,模型调用搜索工具,搜索返回,模型作答,会话结束。
这种环境有个友好特性:用户会等待,进程活着,工具基本只读,失败代价很低。
编码 agent、部署 agent、研究 agent、客服 agent 和长时间运行的后台 agent 没有这种奢侈。
它们引入了不同的运行环境:
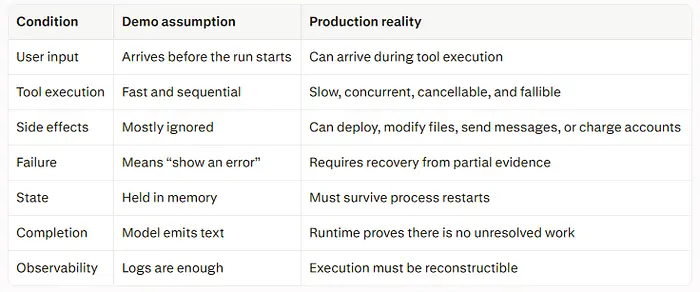
重要的转变在于:
一个认真的 agent 不只是推理程序,它是一个内部装着概率性规划器的部分失败系统。
规划器是模型,部分失败系统是 harness。
这就是为什么那些看似无聊的主题——队列、取消、检查点、工具调用排序、重放策略、收件箱语义——最终会比循环本身更重要。
模型可以决定调用 deploy()。但它自己无法判断:在"工具已启动"和"结果已持久化"之间进程崩溃后,部署到底有没有发生过。
这不是推理问题,而是运行时证据问题。
4、Pi:核心很小、接缝外露
Pi 的核心设计有一种许多框架不具备的纪律性。
它不试图在中心循环里定义所有可能的 agent 运行时策略,而是保持执行路径相对较小,并给宿主应用明确的干预点。
在基础层面,流程是可辨认的:
prompt
  ↓
provider request
  ↓
assistant response
  ↓
tool calls?
  ├─ no  → turn ends
  └─ yes
       ↓
    execute tools
       ↓
    append tool results
       ↓
    next provider request
但 Pi 有用的部分不是那些箭头,而是箭头周围的接缝:转向(steering)、后续工作(follow-up)、请求准备、工具调用钩子,以及轮次终结(turn-finalization)决策。
Pi 的 Agent Core 文档区分了即时转向与后续输入,并暴露了围绕工具处理和轮次结算的生命周期机制。这是一个刻意的选择:核心只负责跑循环,而集成方决定周边的大部分策略。
5、输入归属才是关键
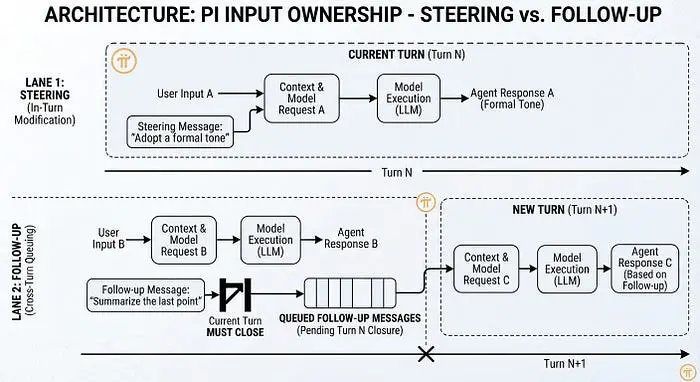
Pi 最有意思的区分是 转向(steering)与后续(follow-up)之间的区别。
这不是外观上的 API 命名,而是对用户意图的运行时分类。
假设 agent 已经开始工作:
用户这时说:
"不要修改配置文件。"
这条输入改变了当前任务的约束,它应该影响当前工作内的下一次模型决策。
这就是转向。
相比之下,假设用户说:
"那之后,写一个 PR 描述。"
这并不重新解释当前的修复操作,而是在当前工作结算后追加一个独立的目标。
这就是后续工作。
用一张图会更清楚。
Current turn

assistant
  ↓
tool calls
  ↓
tool results
  ↓
steering enters next model request
  ↓
model continues
对比:
Current turn
  ↓
natural completion
  ↓
follow-up becomes new work
  ↓
new turn
这是一个很小的区分,后果却很大。
如果每条进入的消息都塞进同一个 pendingMessages[] 队列,系统就丢失了一个关键事实:这条消息属于哪个执行面?
这种歧义会制造糟糕的行为:
- 用户想阻止一次不安全的编辑,但消息要等到任务结束才被处理。
- 用户问了个新问题,agent 却把它当作对旧任务的修正。
- UI 无法判断该显示"agent 正在调整"还是"agent 稍后处理这个"。
- 运行时无法可靠地重建模型当时为何看到了某段上下文。
Pi 的做法很务实:按输入与进行中工作的预期关系来分类新输入。
6、转向控制的是未来,不是过去
这是 agent 工程中最重要的实践规则之一。
假设 run_test("login") 需要 45 秒。三秒后用户说:
"算了,别跑测试了。"
运行时无法诚实地说测试从未运行——它已经开始了。
如果工具可取消,运行时可以取消它;它可以阻止模型发起额外的测试调用;它可以标注当前情况,让模型自行调整。
但它不能仅仅因为用户补了一条消息就逆转历史。
由此引出一条值得带进每个 agent 设计的原则:
转向改变的是未来的决策,它不会追溯性地抹掉已经完成或已经开始的副作用。
这就是为什么工具 API 需要比 execute(args) => result 更丰富的语义。
一个真实的工具可能需要表达:
- 执行是否已经启动。
- 它是否可取消。
- 取消是协作式还是强制式。
- 重放是否安全。
- 它是否有副作用。
- 它的外部结果是否可能变为未知。
- 它的结果是否暗示任务已完成。
Pi 并不强迫所有这些都塞进一个重量级的运行时模型,它给宿主留出了拥有这些策略的空间。
这既是它的强项,也是它的取舍。
7、finishTurn() 比"停止"微妙得多
天真的工具循环假设:
tool result
  ↓
always call model again
当工具结果本身就是最终产物时,这种做法很浪费。
想象一个结构化输出工具:
assistant
  ↓
generate_valid_json(...)
  ↓
final JSON produced
如果再次调用模型只是为了复述或重新格式化工具已经定稿的内容,系统就要为很少的价值支付额外的延迟和 token 成本。
Pi 的轮次终结机制就是为回答这个问题而生:当前这一轮是否还欠提供商(provider)一次请求,还是现在就能结算?重要的不是"永远停止"对"永远继续",而是运行时是否已经满足了这样一项要求:在需要时,模型要再获得一次行动的机会。
这个语义区分很重要:
continue ≠ blindly invoke the model one more time
更好的解释是:
continue = ensure the model gets another decision opportunity
如果新的转向已经排队,下一次模型调用可能就满足了这项义务。运行时不应该仅仅因为两个不同机制都要求继续,就制造一个冗余的重复请求。
这就是循环与调度器的区别。
8、工具不能单方面结束一批调用
工具终止是简单设计另一个常见的翻车点。
假设一次模型响应发出了三个并发工具调用:
search_docs()
get_git_diff()
run_tests()
现在想象:
search_docs() → terminate: true
get_git_diff() → terminate: true
run_tests() → terminate: false
如果运行时允许任何单个工具终止这一轮,结果会变得荒谬:
search_docs says “done”
  ↓
runtime ends
  ↓
run_tests result is ignored
更安全的模型是:
single tool → contributes a termination signal
tool batch → determines whether the batch can settle
runtime → decides whether outstanding work still exists
Pi 文档描述的模型与这一工程现实一致:工具级的终止指示不等价于无条件的全局终止,尤其当多个工具调用同属一次 assistant 响应时。
这个更广泛的教训远不止适用于 Pi:
工具可以提议闭包(closure)。闭包归运行时所有。
9、常见错误:把 agent 结束当作空闲
另一个微妙的问题出现在循环发出"agent 已完成"事件之后。
许多系统假设:
agent_end
=
everything is finished
但事件订阅者可能仍在执行异步工作:
- 写入 trace。
- 更新 UI 投影。
- 持久化摘要。
- 触发下游工作流步骤。
- 清理沙箱资源。
所以有意义的生命周期往往更接近:
agent loop completes
  ↓
terminal event emitted
  ↓
async listeners settle
  ↓
runtime becomes idle
这个区分在编排器(orchestrator)里很重要。如果父进程在子 agent 发出结束事件之后——但在清理或状态持久化完成之前——立刻启动下一个作业,你就会制造出看起来像随机抖动的竞态条件。
这类问题永远不会出现在演示的截图里,它只在系统跑了几千次之后才会现身。
10、Pi Durable:当对话成为执行状态
Pi Core 的设计隐含着一条清晰的职责划分:
Pi owns the basic agent loop.
The host owns much of the surrounding system policy.
当任务很短、用户在场、重启工作可以接受时,这是一个成立的设计。
但最终,许多 agent 工作负载会越过一条边界:
- 任务耗时数分钟或数小时。
- 多个客户端可以提交工作。
- 进程可能重启。
- 工具有外部副作用。
- 用户期望一次请求不会仅仅因为网络响应丢失就跑两遍。
- 对话历史已不足以重建执行。
到那时,只存一份对话记录(transcript)就不够了。
你需要持久化运行时相信发生了什么。
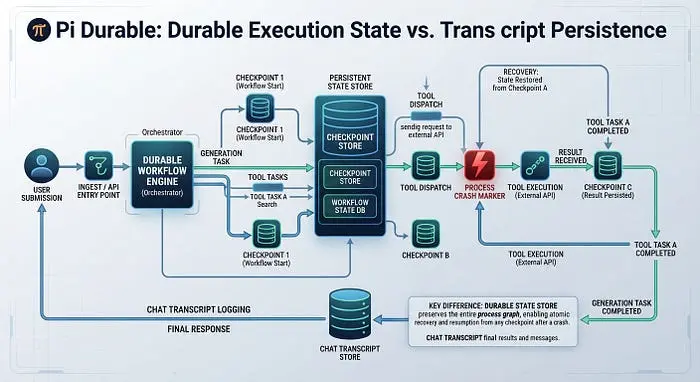
Pi Durable 正是朝这个方向走:把比消息更多的东西当作持久状态——提交(submissions)、生成(generations)、工具任务、收件箱状态、用量、agent 状态和检查点,都成为执行模型的一部分,而不是宿主顺手管理的细节。
概念上的流程是这样的:
Conversation
  ↓
Submission
  ↓
Generation task
  ↓
Tool task(s)
  ↓
Checkpoint and recovery state
重要的转变不是"数据被保存了"——每个应用都会保存一些数据。
转变在于:执行本身成了一等对象。
11、只存对话记录是不够的
一份对话记录可以告诉你:
User: Deploy version 1.8.2.
Assistant: I will deploy version 1.8.2.
它甚至可能记录了工具调用:
deploy("1.8.2")
但崩溃之后,关键问题并不是对话性的:
- 部署工具真的被派发了吗?
- 它的代码开始运行了吗?
- 部署在外部完成了吗?
- 进程是不是在结果被记录之前就死了?
- 重放安全吗?
- 重试之前,模型是否应该检查生产环境?
- 用户是否需要批准恢复?
仅凭对话记录回答不了这些问题。
这就是为什么持久化 agent 模型至少需要若干独立的事实:
message persisted?
submission admitted?
tool call recorded?
tool execution started?
tool result recorded?
external outcome known?
replay allowed?
一旦你需要这些字段,你构建的就不再是聊天历史功能,而是一个部分失败的运行时。
12、恢复不是重试
这个区分是根本性的。
考虑两个工具:
search_issues()
deploy()
对 search_issues() 来说,崩溃后重新执行可能无害。
对 deploy() 来说,重新执行可能触发第二次部署、使发布状态失效、重启服务,或让你的 agent 记录与外部环境不一致。
所以恢复策略不能简单是:
previous step incomplete
  ↓
run it again
而必须是:
previous action incomplete
  ↓
what evidence exists?
  ↓
what may already have happened?
  ↓
is replay safe?
  ↓
do we verify, retry, compensate, or ask a human?
Pi Durable 的"重放安全(replay-safe)"框架很重要,因为它强迫工具作者承认这一区分:只读查询和生产部署的恢复语义并不相同。
任何构建过支付系统、消息处理器或分布式工作流的人听着都会觉得耳熟。
模型可以是新的,故障模式不是。
13、幂等受理不等于幂等执行
假设一个客户端提交:
requestId = "job-42"
task = "Fix the flaky login test"
服务开始处理,然后连接断了。
客户端现在面临不确定性:
Did the server receive the request?
Did it start?
Did it finish?
天真的重试会制造经典的重复提交问题:
submit(job-42)
submit(job-42)
于是两个 agent 可能编辑同一条代码仓库、跑同一次部署,或产出重复的工作。
一个持久化的受理模型可以把请求 ID 当作幂等键:
same request ID
  ↓
same admitted submission
  ↓
return existing work state rather than create new work
这很有价值,但它不会神奇地为外部副作用创造"恰好一次"的执行。
这个区分值得精确表述:
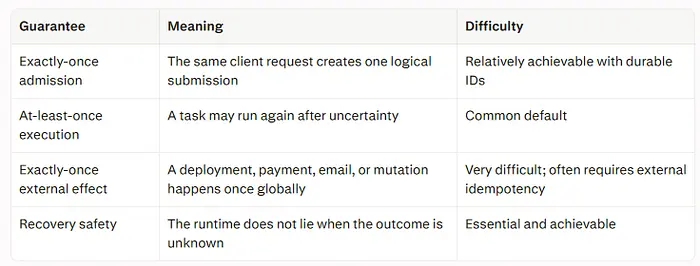
诚实的系统不是那个宣称完美"恰好一次"行为的系统。
而是那个说:
"这个工具可能已经产生了外部副作用。重放之前请先验证。"
的系统。
这才是有价值得多的保证。
14、DeepSeek Harness:循环成为运行时
DeepSeek Harness 采取了更激进的立场。
它不把 agent 循环当作带扩展钩子的紧凑引擎,而是把 agent 运行时当作一张由插件、服务、事件、持久会话事实、队列、调度器和恢复语义构成的图。
它的架构文档描述了一个插件导向的系统:模型适配器、工具、会话、agent 逻辑、循环行为、持久化及相关设施都通过运行时来组合,而不是外挂到一个中心的 agent 抽象上。
这个设计选择改变了重心。
Pi 大致是:
small agent core
  ↓
hooks and queues
  ↓
host-owned policy
DeepSeek Harness 更接近:
plugin and service graph
  ↓
agent loop runtime
  ↓
inbox + session events + scheduler + recovery
两种方向都不天然更优。
重要的问题是:你希望执行语义住在哪里。
15、在 DSH 中,一轮(turn)不只是一次请求
术语在这里变得危险。
各框架对"request""step""turn""run""activity"这些词的用法并不相同。把相同的标签当成相同的语义,是误解 agent 系统最快的方式之一。
一套有用的分析词汇是:
- Request(请求): 对模型提供商的一次调用。
- Step(步): 一次模型响应,加上该响应产生的工具执行。
- Turn(轮): 围绕输入创建的更大的逻辑工作单元,一直持续到没有相关工作剩余。
- Activity(活动): agent 运行时是否仍在结算工作的更宏观状态。
在 DeepSeek Harness 中,文档化的循环模型明确做了这一区分:一个 turn 可以包含零个或多个 step,而不是与单次模型请求同义。
这使得一次用户级操作可以长成这个形状:
Turn 17

Step 1
  user input
  ↓
  model
  ↓
  read_file()
  ↓
  result
Step 2
  new steering input
  ↓
  model
  ↓
  run_test()
  ↓
  result
Step 3
  model
  ↓
  final response
三个 step 可以同属一个逻辑 turn。
这不只是记账方式。
它意味着运行时可以提出一个真正的闭包问题:
Does this turn still contain unresolved work?
而不只是:
Has the last model request returned?
16、收件箱就是执行语义
在简单循环里,收件箱只是一个队列。
在认真的运行时里,收件箱告诉你新信息属于哪里。
有用的区分是:
next-step
和:
next-turn
next-step 输入改变的是:在当前逻辑任务内,模型下一次决策前应该看到什么。
next-turn 输入则要等当前工作结算之后,才成为新任务。
这恰好映射到前面的例子:
Current task:
“Fix the login test.”

New message:
"Do not modify configuration files."
这条消息属于 next-step。
而:
New message:
“After this, generate a PR description.”
属于 next-turn。
DeepSeek Harness 把与收件箱相关的状态转移记录为运行时模型的一部分,而不是把注入当作某个回调的隐形副作用。这提升了可重建性:系统不仅知道发生了转向,还知道消息何时进入执行面、何时被某个 step 认领。
这是 agent 框架与 agent 运行时之间最干净的差异之一。
框架给你一个注入输入的方法。
运行时给输入在执行历史中一个位置。
17、持久事实与实时控制不该是同一件事
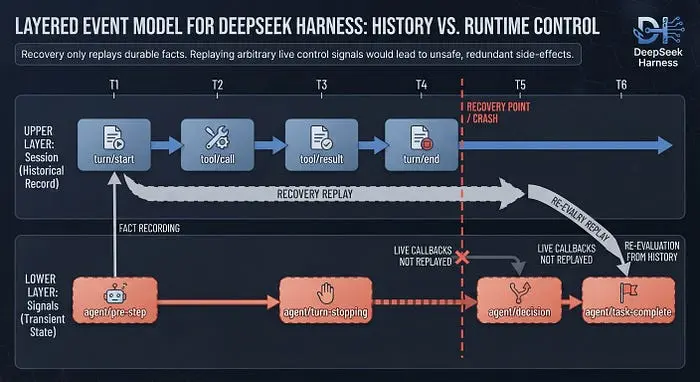
DeepSeek Harness 把持久会话事件与实时控制事件分开。
这个区分是架构性的,不是审美性的。
持久会话事件回答:
What happened?
例如:
turn started
step started
user message persisted
assistant message persisted
tool call recorded
tool result recorded
step ended
turn ended
实时运行时事件回答:
What is allowed or required now?
例如:
agent status update
pre-step hook
request lifecycle event
turn stopping signal
streaming control
tool hook
这个分离在恢复之后很重要。
一条已持久化的工具调用是历史事实;一个请求运行时停止的回调是实时控制决策。把两者混进同一个不加区分的事件系统会造成混乱:
- 这个事件会被重放吗?
- 重放会引发副作用吗?
- 它是历史记录还是一次新的策略决策?
- 如果监听器顺序变了,历史会变吗?
- 一次恢复运行会不会意外地重新触发实时行为?
DeepSeek Harness 的架构刻意把持久记录与实时执行面分开。
当进程可能重启时,你想要的正是这种边界。
18、闭包是状态,不是回调返回值
DeepSeek Harness 最优雅的思想是对终止的处理。
朴素的 agent 循环常常这样结束:
if (noMoreWork) {
  return;
}
问题在于,"没有更多工作"在事件驱动系统中并不稳定。
设想这条时间线:
13:21:04.100  Runtime thinks it can end
13:21:04.105  Plugin injects additional context
13:21:04.110  User sends “Do not modify config”
13:21:04.115  Runtime ends anyway
bug 不在于运行时没检查某个布尔值。
bug 在于它把闭包当成了瞬时决策,而不是一个必须经受最终一致性检查的状态。
DeepSeek Harness 有一个显式的轮次停止边界。运行时可以进入候选停止状态、允许相关控制活动、再次检查状态,然后只有当收件箱和未完成工作确实清空时,才提交终结性的 turn 事件。
概念上的序列是:
step ends
  ↓
no active tools
  ↓
no obvious next-step work
  ↓
turn becomes a stop candidate
  ↓
turn-stopping phase
  ↓
re-read inbox and runtime state
  ↓
if new work exists: continue
if no work exists: commit turn end
由此得到一条值得记住的运行时原则:
终止应当对照状态来验证,而不是从回调顺序推断。
当插件可以注入上下文、用户可以实时转向、而系统又要在并发下保持确定性时,这一点尤其重要。
19、工具可以提议终止;收件箱可以否决它
假设一个工具返回:
concludesTurn = true
这可能意味着:
"工具产出了足够的输出。模型不需要仅仅为了理解我再发一次请求。"
这可以减少模型债务。
但它不应抹掉排队中的工作。
假设该工具运行期间,用户补充了:
"用预发布环境,不要用生产环境。"
工具的结论不能覆盖这条消息。
所以正确的层级是:
tool proposes closure
  ↓
runtime checks unresolved tool work
  ↓
runtime checks next-step inbox
  ↓
runtime applies policy
  ↓
runtime commits or rejects closure
这比下面这样的心智模型安全得多:
tool says stop
  ↓
stop
DeepSeek Harness 的循环文档明确把 turn 的继续与否框定为"是否还有额外工作",包括排队中的 next-step 输入,而不是把工具级结论当作无条件的终结权威。
这正是 agent 循环开始像交易结算的地方。
工具做了一个局部声明。
运行时检查全局状态。
20、并发需要稳定的观察顺序
并发工具执行会制造一个微妙的不确定性问题。
假设模型调用:
A = read_file()
B = fetch_logs()
C = run_tests()
实际完成顺序可能是:
B → A → C
或:
A → C → B
如果下一次模型请求看到的结果是按网络实际完成顺序排列的,那么模型的上下文变化可能纯粹是因为某次运行中某个工具端点慢了一些。
这并不总是不可接受。但当你需要可复现性、可测试性或稳定的 agent 行为时,它就很危险。
稳健的设计是把以下两者分开:
dispatch order
和:
result commit order
工具可以并发运行,但它们的结果可以按模型最初指定的顺序提交。
DeepSeek Harness 的调度器设计正是通过并行执行、独占屏障、有界并发、稳定的模型顺序终结、取消排空(cancellation draining),以及为从未执行的调用生成合成结果,来应对这些关切。
原则很简单:
执行可以是并发的。观察应当是有意的。
这不是 agent 特有的教训,而是 agent 工具链正在重新发现的一条标准并发课。
21、难点:取消、未知结果与 token 上限
如果你想评估一个 agent harness 是否成熟,不要从它的模型适配器或工具数量宣传看起。
看它如何处理取消与不确定性。
21.1 取消不止一种含义
假设模型发出三个工具调用:
A = read_file()
B = run_tests()
C = deploy()
然后用户取消了。
生产级运行时至少要区分:
A: started, then interrupted
B: started, then interrupted
C: never dispatched
这些状态很重要,因为它们含义不同。
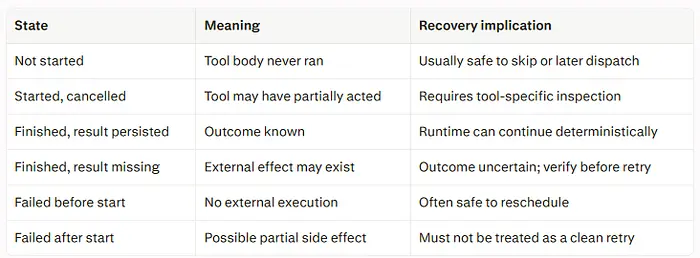
DeepSeek Harness 对工具结果做了区分,包括工具在派发前被中止与在开始后被中止的情况。这一区分对正确的恢复和可审计性至关重要。
一个取消 API 成功返回,几乎不能告诉你外部世界的任何情况。
工具可能在发出部署请求之后才收到取消信号;它可能在远程系统已接受命令之后才关闭网络连接;它可能写了一半的文件;它可能完成了一次扣款、却在持久化收据之前失败。
这就是为什么"已取消(cancelled)"不是一个足够的结果类型。
21.2 TOOL_OUTCOME_UNKNOWN 是诚实,不是失败
这是一个危险的崩溃窗口:
tool/call persisted
  ↓
tool body begins
  ↓
external side effect may occur
  ↓
process crashes
  ↓
tool/result not persisted
恢复时,系统无法如实地说:
tool failed
它不知道。
它也不能说:
tool did not run
它同样不知道。
正确的状态是:
outcome unknown
DeepSeek Harness 在其恢复模型中把这一类别显式化:一条已记录的工具请求如果没有对应的持久结果,可以成为"结果未知"状态,而不是一次干净的失败或安全的重放。
这听起来像是无关紧要的命名细节。并非如此。
它迫使下一次策略决策变得安全:
unknown deployment outcome
  ↓
inspect deployment system
  ↓
verify current release state
  ↓
only then decide whether to retry
没有这个状态,模型或运行时往往会去做危险的事:
tool failed
  ↓
retry
对 read_file() 来说也许没事。
对下面这些就不行了:
send_email()
charge_card()
deploy_production()
delete_customer()
write_database_record()
成熟的系统不是那个假装不确定性不存在的系统。
而是那个把不确定性变成一等状态转移的系统。
21.3 max tokens 是运行时状态,不只是模型错误
token 上限常被当作提供商层面的恼人之事:
max tokens reached
但从运行时的视角看,token 耗尽会改变一轮的状态。
假设模型已完成两个有用的步骤,在第三步时撞上 token 上限:
Step 1 → completed
Step 2 → completed
Step 3 → max tokens
Step 4 → completed after continuation
最终的 turn 状态应该直接变成 completed 吗?
未必。
这次运行撞上 token 上限这一事实,之后可能很重要:
- 是否应该压缩上下文?
- 是否应该提醒用户响应被截断了?
- 是否应该换模型或调整 token 预算?
- 编排器是否应把任务标记为降级(degraded)?
- 是否适用重试策略?
- 评估指标是否应把它归类为正常完成?
DeepSeek Harness 把这类条件当作粘性的 turn 级状态,而不是允许后来的一次普通完成抹掉早先的、有策略意义的事件。
这是一条通用的状态机教训:
如果先前的事件会影响未来策略,就不要只存最终事件。
一轮不只是一个最新状态,它是仍然重要的事实的紧凑表示。
22、真正重要的对比
最有用的对比不是"谁的功能更多?"
而是:谁拥有执行状态和策略?
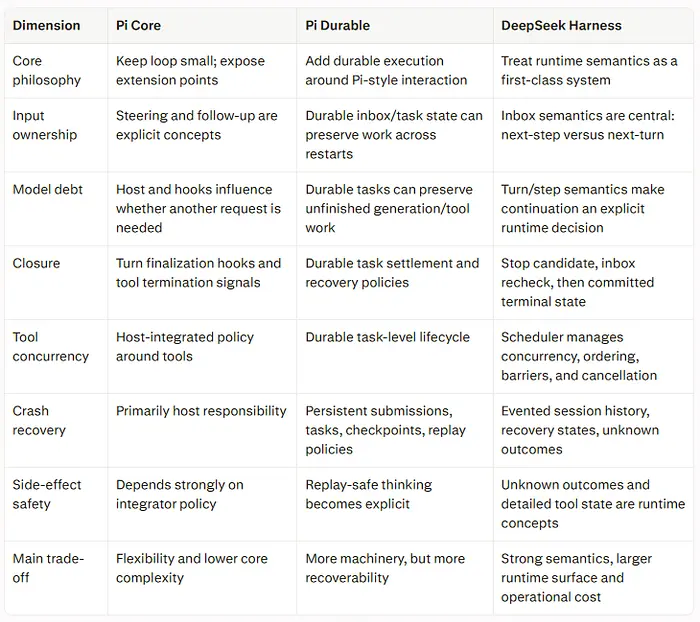
这张表不该被当作排名来读。
应当作复杂度落点的地图来读。
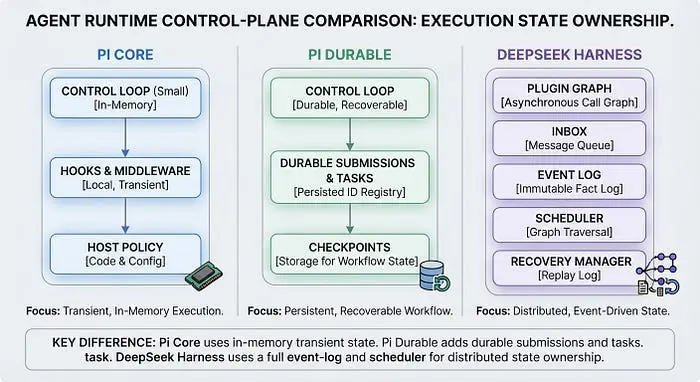
24、Pi Core:复杂度留在应用一侧
当你的工作负载长这样时,Pi 很有吸引力:
one developer
+
one repository
+
local tools
+
human is present
+
tasks last minutes
+
restart is acceptable
在这种环境里,一个庞大的持久化运行时带来的负担可能超过收益。
你将不得不维护:
- 持久事件 schema。
- 检查点迁移。
- 重放语义。
- 恢复策略。
- 分布式锁。
- 持久任务生命周期。
- 更广泛的集成测试。
- 运维仪表盘。
- 存储状态的版本兼容性。
这些成本是真实的。
Pi 的小核心姿态并不天真,它是对"把每个终端编码助手都塞进工作流引擎架构"的刻意拒绝。
它的问题是:
为什么应该由框架拥有那些只有宿主应用才能正确判定的策略?
这通常是对的问题。
25、Pi Durable:持久性进入契约
Pi Durable 占据中间地带。
它承认有些系统需要的不止一个瞬时循环,但并不要求每个集成都从一张庞大的运行时图开始。
它的核心动作是让对话、提交、生成工作、工具任务、收件箱状态、检查点和重放策略变得更显式、更持久。
当工作负载开始接近下面这样时,这是正确的方向:
multiple clients
+
background work
+
long-running tasks
+
restart tolerance
+
external integrations
+
need to avoid duplicate submissions
关键不在于"它保存了更多状态"。
关键在于:
它开始把隐式的宿主行为转化为显式的运行时证据。
26、DSH:运行时语义成为基础设施
当你的工作负载需要围绕下面这些给出更强保证时,DeepSeek Harness 很有说服力:
- 并发工具。
- 实时转向。
- 注入上下文的插件。
- 持久会话。
- 部分执行后的恢复。
- 可审计的工具生命周期。
- 多用户交互。
- 确定的观察顺序。
- 人工批准与策略检查。
- 长时间运行的后台工作。
在那个世界里,让运行时理解 turn、step、收件箱归属、工具结果、停止候选、调度器行为和持久事实,可以大幅减少泄漏进应用代码的意外语义。
但取舍很直白。
你现在是在运营一个运行时。
而不仅仅是导入一个库。
27、常见误解
"agent 循环不就是个 while 循环吗"
不是。
while 循环是重复工作最简单的控制流表达。生产级 agent 循环是一个针对不完整、并发、且时而不确定的工作的结算协议。
朴素形态是:
while (true) {
  const response = await askModel();
  const results = await runTools(response.toolCalls);
  append(results);
}
生产形态在概念上更接近:
while unresolved work exists:
    admit new input
    decide its ownership
    construct the next step
    call the model if model debt exists
    dispatch tools under concurrency policy
    persist durable evidence
    classify results and uncertainty
    apply cancellation and recovery semantics
    inspect queues and policy constraints
    validate whether the turn can close
这两个循环之间隔的不是几个条件。
隔的是运行时语义。
28、"持久化就是保存聊天记录"
不是。
保存聊天记录让你能显示历史消息。
持久化意味着:故障之后,运行时能够回答这样的问题:
What was admitted?
What began?
What completed?
What may have completed?
What can be replayed?
What must be verified?
What input is still pending?
对话记录回答不了所有这些。
29、"重试让系统更可靠"
重试会让某些系统更不可靠。
重试一次只读抓取可能是好事。
重试一次先前结果未知的生产部署,可能造成第二次部署。
重试一次邮件发送可能造成重复沟通。
重试一次扣款可能酿成财务事故。
可靠的 agent 系统不会只问:
Did it fail?
它会问:
Did it start?
Could it have had an external effect?
Do we have a durable result?
Is replay safe?
Does the external system support idempotency?
20、"工具决定任务是否完成"
工具可以提供证据,可以给出终止提示,可以产出最终输出。
但它不会自动拥有全局任务闭包的决定权。
运行时仍必须检查:
- 其他正在运行的工具。
- 排队中的 next-step 消息。
- 人工批准要求。
- 策略约束。
- 待处理的恢复工作。
- 尚未结算的持久状态。
这就是为什么"工具宣告本轮结束"应被理解为一项提议,而非绝对命令。
31、"更多运行时语义总是意味着更好的工程"
同样,不是。
一个在单个终端里跑五分钟的本地编码助手,未必需要持久任务图、事件溯源、恢复状态机和多客户端收件箱语义。
当你加入一个强大的运行时,复杂度并不会消失,它会转移到:
- schema 设计。
- 可观测性。
- 迁移。
- 测试矩阵。
- 故障注入。
- 运维归属。
- 事故响应。
正确的架构取决于你的工作负载落在哪里。
32、我的判断
从 Pi、Pi Durable 和 DeepSeek Harness 中得到的最深教训,不是谁现代、谁轻量。
而是:agent 工程会比大多数团队预想的更早变成分布式系统工程。
只要你的系统出现以下任意有意义的组合:
- 长时间运行的任务。
- 并发工具。
- 用户转向。
- 后台执行。
- 带副作用的工具。
- 进程重启。
- 多个客户端。
- 人工批准。
- 重试。
- 审计要求。
你就需要对四个问题给出真正的答案。
24.1 输入归属
一条新消息到达时,它属于哪里?
current step?
current turn’s next step?
next turn?
persistent state only?
human approval queue?
如果这不清楚,实时转向会立刻变得不可靠。
24.2 模型债务
工具返回后,模型是否还欠一次决策?
如果不是,谁有权豁免这次决策?
tool?
hook?
policy layer?
queue state?
human?
runtime?
好的系统不会盲目地再调用一次模型,也不会让任何一个单一工具意外压制必要的继续。
24.3 终止权威
谁可以关闭工作?
安全的答案通常是分层的:
tool proposes closure
  ↓
runtime checks unresolved work
  ↓
policy layer checks constraints
  ↓
inbox can veto
  ↓
human gate can veto
  ↓
terminal state is committed
这比 return 啰嗦得多,也难错得多。
24.4 持久证据
进程死掉之后,系统知道什么——而不是它希望什么?
你应该能回答:
What did the user request?
What did the model decide?
Which tool call was created?
Which tool actually started?
Which outcome was recorded?
Which outcome is unknown?
What can safely replay?
What must be verified externally?
What work remains?
如果你的答案是"我们大概能从日志里推断出来",那你还没有持久化的 agent 语义。
你有的是" hopeful debugging"(靠希望支撑的调试)。
25、实践含义
如果你今天在设计一个 agent 平台,我不会从争论规划器架构、提示词模板或多 agent 拓扑开始。
从控制平面开始。
阶段 1:让小循环诚实
对于 Pi 风格的本地 agent,先实现这些:
- 把转向与后续工作分开。
- 让工具执行状态显式化:排队、已开始、已完成、已取消、未知。
- 不要把工具的终止提示当作全局权威。
- 保证新的转向能到达下一次相关的模型请求。
- 让"agent 已完成"不同于"系统空闲"。
- 拒绝或安全地呈现不完整的工具调用,而不是猜测危险的参数。
在这个阶段,你不需要持久化工作流引擎。
你需要清晰的语义。
阶段 2:让副作用可见
在加入后台执行之前,先丰富你的工具契约。
一个生产级工具最终应当声明类似这样的内容:
Tool identity
Execution mode
Side-effect level
Idempotency strategy
Replay policy
Cancellation behavior
Outcome classification
Termination hint
External verification method
工具不再只是一个函数。
它是一个分布式状态机的参与者。
阶段 3:只在工作负载需要时才加入持久性
当你有以下需求时,再转向 Pi Durable 风格的语义:
- 必须挺过重启的作业。
- 可能重试请求的客户端。
- 可能超过单个连接寿命的任务。
- 必须可恢复的工作。
- 有意义的外部副作用。
- 需要区分"未开始"与"结果未知"。
持久化提交、工具任务、检查点、收件箱状态和恢复证据。
不要只持久化对话记录就自称持久化。
阶段 4:只在协调主导时才集中运行时策略
当你需要系统本身来协调以下事项时,再转向 DeepSeek Harness 风格的运行时:
- 插件注入的上下文。
- 复杂的 next-step 收件箱语义。
- 多步 turn。
- 事件溯源。
- 并发调度。
- 稳定的结果排序。
- 持久工具恢复。
- 取消排空。
- human-in-the-loop 关卡。
- 跨客户端会话连续性。
到那时,统一的运行时契约减少的复杂度可能比它创造的多。
但别搞错:你是在构建基础设施。
26、最终的心智模型
表层的 agent 循环是:
while (true) {
  askModel();
  runTools();
}
生产级的 agent 循环是:
while (unresolved work exists) {
  admit input;
  determine input ownership;
  decide whether a model response is owed;
  create a step;
  request the model;
  dispatch tools;
  record durable evidence;
  classify completion, cancellation, and uncertainty;
  inspect queued work;
  validate termination;
}
差别不在语法。
这是一个喋喋不休的 demo 与一个知道发生了什么的系统之间的差别。
Pi 的答案是:
保持核心很小。暴露接缝。让集成方拥有策略。
Pi Durable 的答案是:
让对话、提交、任务和恢复状态持久化。
DeepSeek Harness 的答案是:
让循环、收件箱、会话记录、调度器和恢复语义成为运行时契约的一部分。
它们不是互相排斥的哲学,而是同一条架构光谱上的三个点。
真正的决策不是:
哪个 agent 循环最好?
而是:
谁应该拥有关于未完成工作的事实?
一旦你看清这一点,其余的就清晰多了。
用户消息不只是文本,它有归属。
工具结果不只是输出,它可能产生或清除模型债务。
终止标志不只是布尔值,它是受全局状态约束的提议。
崩溃不只是异常,它制造了必须被如实表达的不确定性。
而 agent 也不是因为能调用工具就叫智能。
当系统能够正确回答以下问题时,它才具备操作层面的智能:
还有什么没有解决?可能已经发生了什么?下一个安全动作是什么?
这才是 agent harness 真正的用途。
原文链接: Agent Loops Are Not while (true): Pi, Pi Durable, and DeepSeek Harness on Continuation, Closure…
汇智网翻译整理,转载请标明出处