AI 从零设计一颗 CPU:25 个负载,每瓦性能 4.59 倍
AI 自主走完 ISA、RTL、验证到 GDS:25 个负载每瓦性能 4.59 倍,其中 15 个是最后才揭盲的。
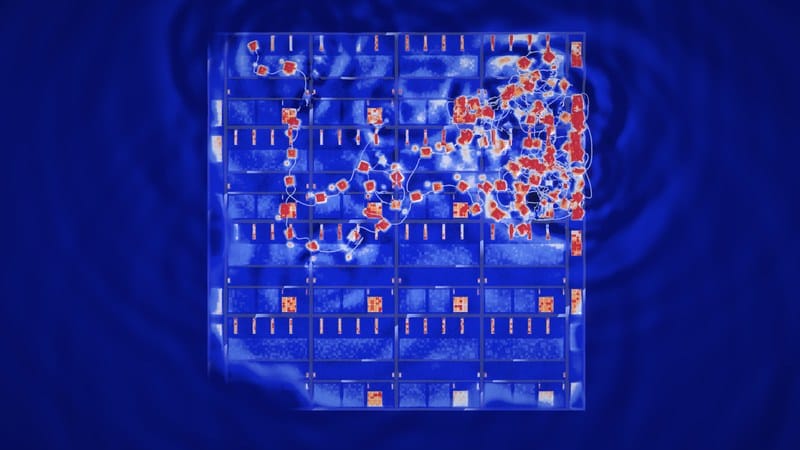
上一篇文章《Redwood》里,我们展示了:给定一个架构,我们的 AI 系统可以在创纪录的时间里实现、验证并部署一颗推理加速器。但和其他科学领域类似,我们相信只要给 AI 系统合适的自由度和护栏,它就能把软件与硬件放在一起协同设计,在整个栈上做优化,打开一个此前根本够不到的设计空间。于是我们给自己出了个问题:我们的 AI 系统和工具,能不能带来一次真正新的硬件发现,让性能大幅超过人造设计?
今天介绍 Frostbite:一颗通用 CPU,指令集是从零建的。它利用交互网(interaction nets)的三个性质——每一步都是局部的、每个依赖都是显式的、每个值恰好只有一个持有者——拿到了 CPU 性能上长期停滞已久的那种台阶式增益。
在我们最初选定的 25 个负载(其中 15 个直到最终评测才揭盲)上,Frostbite 相对一颗现代、已在硅上验证过的超标量(双发射、顺序执行)CPU 核,做到了 4.59 倍的每瓦性能。
我们的 AI 系统自主迭代了编译器、ISA、架构、微架构、RTL、验证,直到最终的 GDS。回头看它发现的那些架构原语时,我们自己也有点意外:里面有些硬件实现和运行时特性,换人来设计会非常难想到。在 CPU 核性能整体停滞的背景下,我们把一个负载概念一路做到了最终 GDS,并证明了每瓦性能与每面积性能的台阶式提升。我们相信,随着 AI 系统变强,今天已知的每一类芯片——数据中心级 CPU、AI 加速器、网络交换机和网卡——都会经历类似的根本性架构迁移。
先解释交互网
主流编程语言编译到通用 CPU 上时,会把程序各部分之间的依赖藏起来。任何一段代码都可以通过共享的可变状态读写任何变量,于是现代 CPU 硬件只能假设最坏情况,在运行时重新发现哪些指令之间真的存在依赖。与此同时,单核性能自 2000 年代初起基本停滞,把人推向了 Intel Xeon、AMD Zen、NVIDIA Vera 这样的多核大芯片。这又迫使 CPU 维持"每个核看到同一份内存"的假象,而要让这个假象既一致又高效,就得付出深缓存层级和一致性协议的面积与功耗,而且扩展性很差。
交互网[1]走的是另一条路。程序是一张节点图,计算发生在"重写通过端口相连的成对节点"的过程中。每一次重写只触碰图上一小块局部。因为每个节点恰好有一个主端口,任意两个可重写的活动对都不会重叠,所以它们可以按任意顺序重写,也可以同时重写,结果永远一样。交互网同时是线性的:每个值恰好被用一次,因此没有需要硬件去守护的共享可变状态。像 Vine[2] 这样的语言,能把看起来很普通的程序直接编译成交互网。想了解交互网以及它为什么适合做硬件,强烈推荐 Tendrils 的《On Interaction Nets》[3]。
图 1:五皇后问题的两种解法。左边是 C++ 程序一步步走搜索树;右边是同一个搜索以交互网表示,同时探索大量分支:3,183 次交互,关键路径只有 262 步。原文此处为循环动画,以下取首帧。
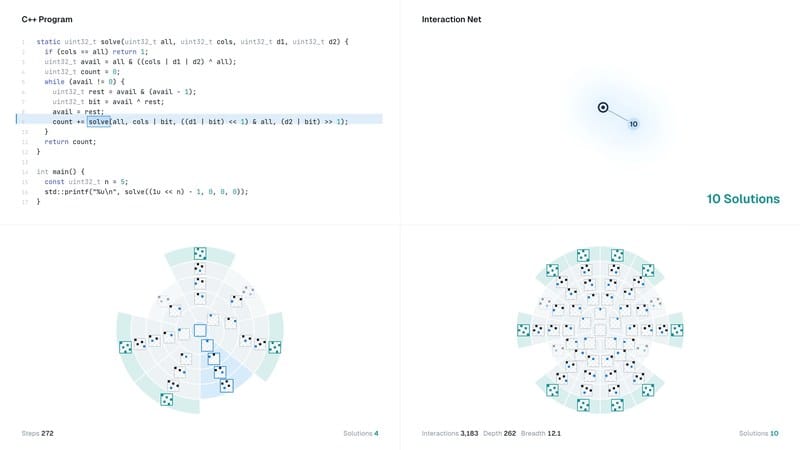
图 1 展示的是一个小搜索问题:把五个皇后放到 5×5 的棋盘上。顺序程序一次只看一个候选;交互网把其中所有独立的工作都暴露出来——平均每一步大约有 12 次交互是可以同时跑的。程序本身一个字都没改,只是那些依赖从来没有被丢掉。
理论上这应该带来两个大优势。第一是免费的多线程:并行度不是靠各种粗细粒度的并行手段拼出来的,而是直接从程序里长出来的。没有线程、锁、竞态,也不需要传统核里为了把这些东西再挖出来而准备的乱序机制。第二,既然每个值只有一个持有者、每一步都是局部的,数据就可以放在紧挨着使用位置的小块本地内存里。这去掉了传统芯片在大型缓存子系统上花掉的大部分面积和功耗,也去掉了维持这些缓存一致性所需的系统性复杂度。
流程
Frostbite 是在零架构先验的前提下设计的。我们按下面的流程推进,全程靠多组 agent 蜂群并行。
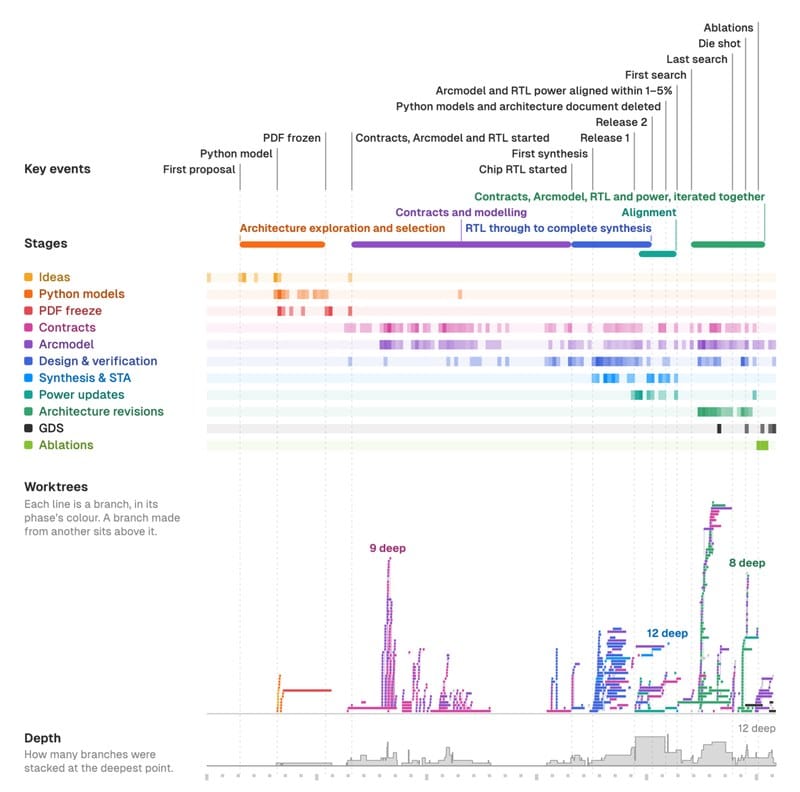
图 2:从最初的提案到消融实验的整个 Frostbite 项目——关键事件、工作阶段、agent 创建的 worktree,每条分支用其所在阶段的颜色绘制。
架构探索与选择
要开始架构探索,先得定下 Frostbite 应该做得极好的那组负载。我们从"程序如何暴露自己的工作"这个角度分了五类:大量彼此独立的片段、成轮的并行工作、长顺序链、数据相关分支、递归。每一类下都建了一个搜索集和一个留出的评测集,最终评测在评测集上做,保证设计能泛化到它从未调过的程序。FFT、radixsort、LU 这些内核沿用 SPLASH-2 基准的实现,但尺寸缩到 1/64,因为常规尺寸不适合做探索性工作。
后来我们又往留出集里补了五个更实用的负载:卡尔曼滤波、PCA、有限元分析、LU 求解、LZ4 解压。
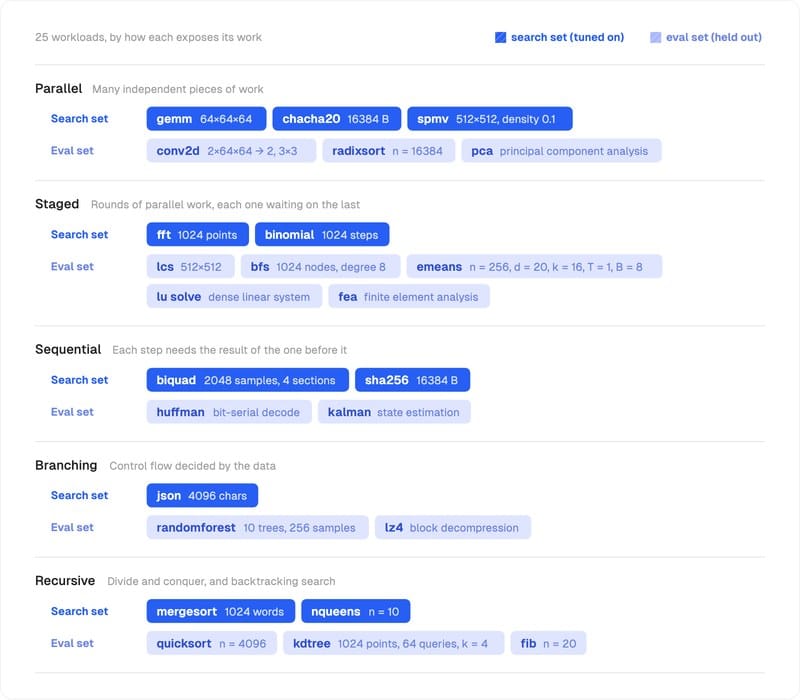
图 3:全部 25 个负载,按程序暴露工作的方式分组,并分成 agent 用来调优的搜索集与留出的评测集,同时标出各自运行规模。
agent 负责综合研究论文与现有基准,并写出 Python 模型,让高层架构想法互相权衡,最后收敛到一个单一的架构概念。这一轮探索的产物是一份 141 页的 PDF,涵盖提议的编程模型、运行时和芯片的高层模块划分。它离最终架构还很远,只是一个起点:把此前所有发现、高层需求、约束、实验与运行时特性都写清楚。等第一次架构迭代完成(第一代 RTL 生成)后,这份 PDF 就被删掉了——里面很多数字和估算跟物理上可行的东西差得很远。
形式化契约与系统建模
架构候选确定后,系统转向构建完整的软件模型。做架构空间探索时,软件模型是必需的:它让负载、ISA 与硬件的抽象视图之间能快速迭代。无论我们做的是 CPU、GPU、NPU 还是网络交换机,掌握这个迭代环就等于在有限时间里最快地探索设计空间。
为了能反复这么做,我们设计了一门内部规格语言 ASL,并用它写了 Frostbite 的系统模型 Arcmodel。ASL 支持 RTL、系统模型、UVM、SVA 等之间的机器可检查翻译与精化,全部对着一个形式化背书的规格。它的功耗与性能估算误差在 1–5% 以内,运行速度比 RTL 仿真快约 200 倍,并且可以通过"契约"做形式化验证。
到目前为止,每一个硅片项目都是人类架构师写一堆英文 PDF,然后交给实现团队和验证团队。但自然语言没法精确无歧义地描述实现所需的每个细节,也没法保证在 ASIC 设计与验证过程中抓得住 agent 的每一次幻觉。自然语言本来就不是为此而生的;在一个由 AI 写规格的世界里,我们选择形式化、机器可检查的规格语言。
ASL 既能形式化描述高层、类协议的行为——乱序处理、CSR 编程、内存序、一致性——也能描述底层细节:流水线、仲裁机制、计算传递函数。这让模型可以在有用之处保持规格开放,在需要精确行为之处严格约束。ASL 还能原生翻译到 Lean[4],我们所有跨 RTL、UVM、C、SVA 的定理证明都用它来核对 AI 的输出。ASL 的更多细节会另文展开。
在整个 Frostbite 开发过程中,我们的 AI 把 ISA、Arcmodel、设计与验证紧紧绑在一起迭代,始终以 ASL 契约为唯一真源。我们发现,有一个单一且可证明的真源,能在部署大规模 agent 蜂群时避免一大类 bug、低级错误和钻评分空子(reward hacking)的情况。归根结底,这门共同语言让模型能在整个栈上灵活工作,把从负载一直到最终硬件的改动一路传导下去。项目结束时,Frostbite 的 ASL 下沉成了 80 多万行 Lean。
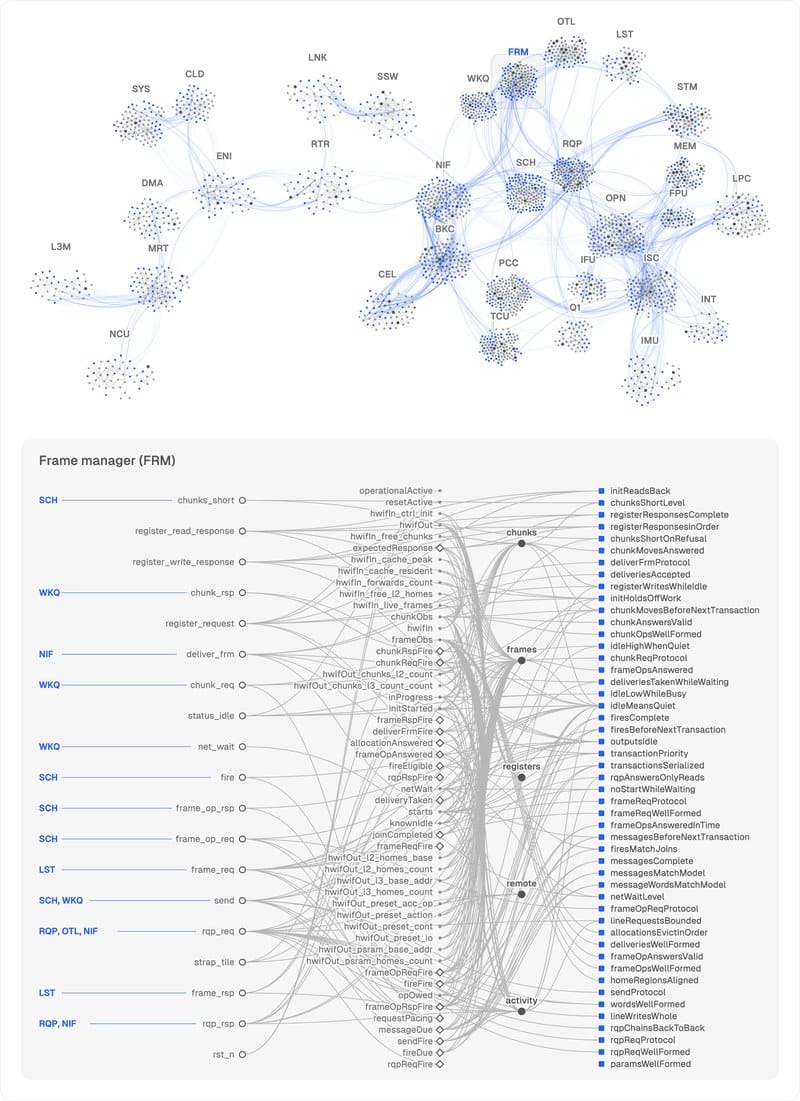
图 4:全部 31 个模块的 Lean 契约。每个模块是一簇"它的契约命名了什么",由"谁读谁"连接,蓝线表示模块间共享的信号。下方放大了帧管理器(FRM)模块。
RTL 与对齐
因为 ASL 是形式化背书的规格,从它派生 RTL 并验证,是整个 Frostbite 流程里最快的一段。不过 Arcmodel 本身对物理不敏感,它一开始的功耗与性能估算会和时序收敛、综合干净的 RTL 真实数字偏离,最坏情况差了近 250%。
在继续 ASL 自动研究之前,我们有一个系统会拿 RTL 重新校准 Arcmodel,这是一条完全自主的流水线。它先找出 RTL 里的功耗热点,把它们追踪到形式化规格中的关键计数器上——SRAM 读写、操作计数、收发的 flit、信用返回、帧未命中。然后模型可以在这些计数器上写出任意的标量 Python 函数来预测功耗,并反复迭代,直到 RTL 与 Arcmodel 的差距落在 5% 以内。
我们发现这种"无梯度学习"极其有效。第一次物理对齐做过之后,后面的迭代快得多。当然这些仍然是硅前数字;经过多轮流片,ASL 模型最终可以和真正的硅后量产功耗数字做关联。
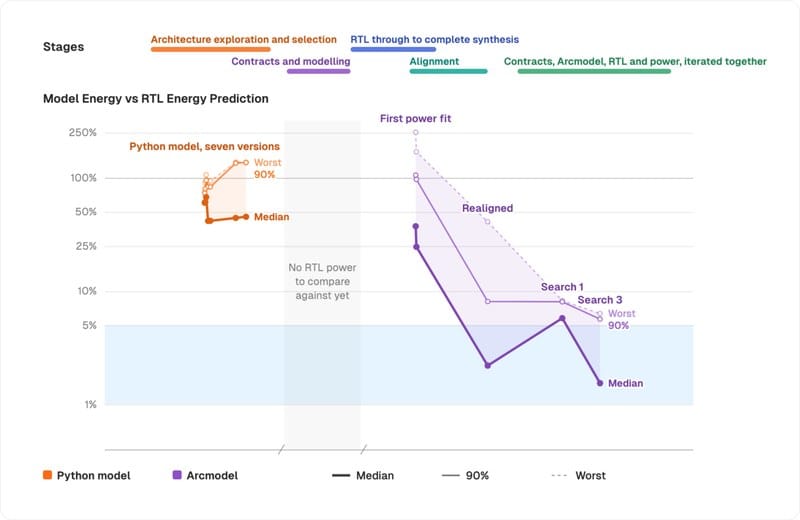
图 5:模型能耗与 RTL 能耗在整个程序上的误差。Python 模型一直离 RTL 很远;第一次功耗拟合之后,Arcmodel 被重新对齐并继续搜索,误差落进 1–5% 的带内。
把 Arcmodel 和 RTL 对齐得这么紧,后续蜂群的探索与利用都快得多。完整的 Arcmodel 芯片仿真比 RTL 快 660 倍,由此产生了大量跨栈优化。举例来说,我们的 AI 系统发现了非常细粒度的时钟门控技巧,并在几小时内相应地调整了软件运行时去适配。这种跨栈优化在传统 ASIC 流程里几乎做不出来。
契约、Arcmodel、RTL 与功耗一起迭代
一旦 Arcmodel 与 RTL 对齐,最初那些 Python 模型和架构 PDF 就被删掉,ASL 契约成为芯片唯一的规格。从那以后,契约、Arcmodel、RTL 与功耗一起往前走。agent 蜂群在并行的 worktree 里提出架构修订;每个改动都要对照契约检查、在 Arcmodel 中建模、在 RTL 中实现、测量功耗,然后保留或丢弃。四轮搜索加最后一轮消融,蜂群共试了 58 个想法,保留了 37 个——从运行中瓦片上的时钟门控,到更小的 L3 表、一个共享的扩展器。
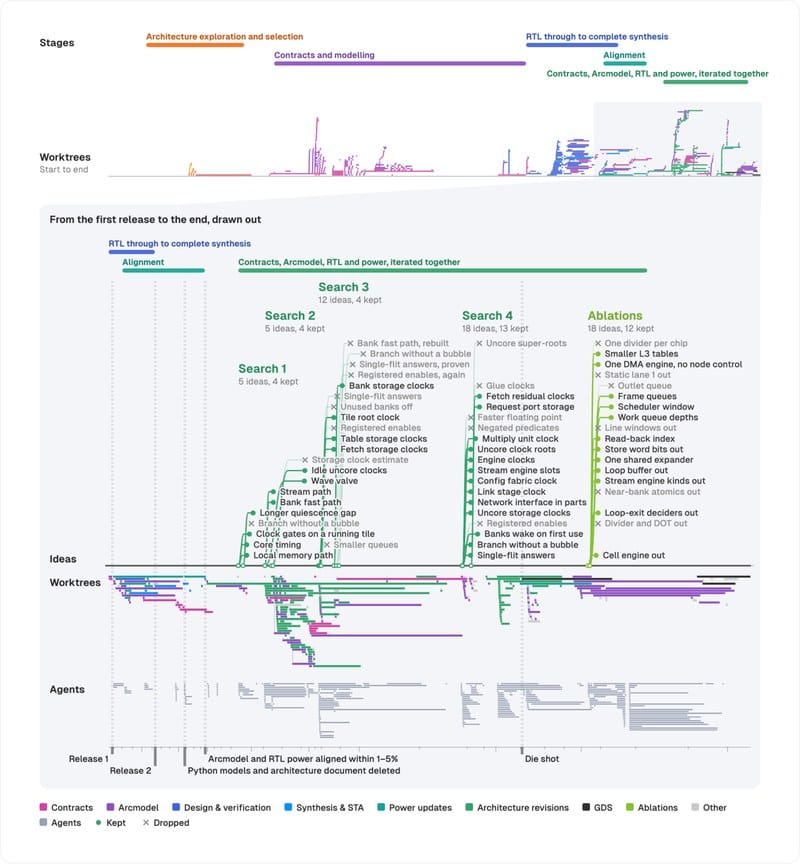
图 6:从第一次发布到项目结束:每轮搜索的想法、它们变成的 worktree、在上面工作的 agent,以及每个想法的保留或丢弃。原文此处为动画,以下取首帧。
架构上的新东西
完整展开这套架构值得单独写一篇。这里我们只挑自认为新颖或有创造性的特性,用来展示我们的系统能把硬件设计的前沿推到哪一步。
Frostbite 的程序用 Vine[2] 书写,这是一门语法类似 Rust 的完整编程语言。Vine 程序被编译成 Ivy——一种编码交互网结构的中间表示。优化器会尽量多地应用图归约规则,所以最终的 Ivy net 形状基本固定,由三种原语组成:数据、计算节点、控制节点。但它的运行时仍然非常动态:通常的计算图把并行性编码在结构里、在时间上流水化,而这里并行性必须在运行时从状态中导出,在空间上流水化。最初的朴素实现很慢,于是 agent 不得不开始想办法。
生成的 ISA 就从这组约束里长出来。其中很多是意料之中的:宽指令包、硬件循环计数器、流。我们认为更有意思的是那些动态特性,尤其是从交互网其他部分"取、窥视、复制"值(那些部分可能正在并行执行)的操作。于是瓦片们活了起来,跨越空间互相通信。
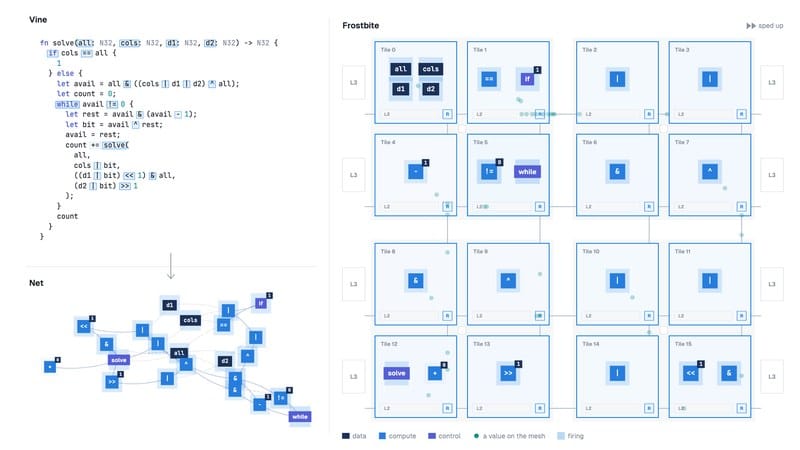
图 7:Frostbite 上的"从代码到硬件"。第一次调用把芯片填满,随后它发出的调用跟着走,以递归方式复用同样的节点,直到每个瓦片都在同时触发——递归被铺开到空间上。原文此处为动画,以下取首帧。
涌现出来的性质:偷工作
因为并行性是铺在空间上的,系统里没有中央调度器。我们看到 agent 设计出的是一套很优雅的工作传播规则。一个瓦片遵守三条规则:先跑自己的工作,也就是输入端口里已有的工作;如果空了,就从邻居那里取它有富余的工作;如果找不到,就直接进入不活跃状态省电。
agent 在实现这件事上表现出的精细程度相当惊人。下面是单个 Frostbite 瓦片的硬件:
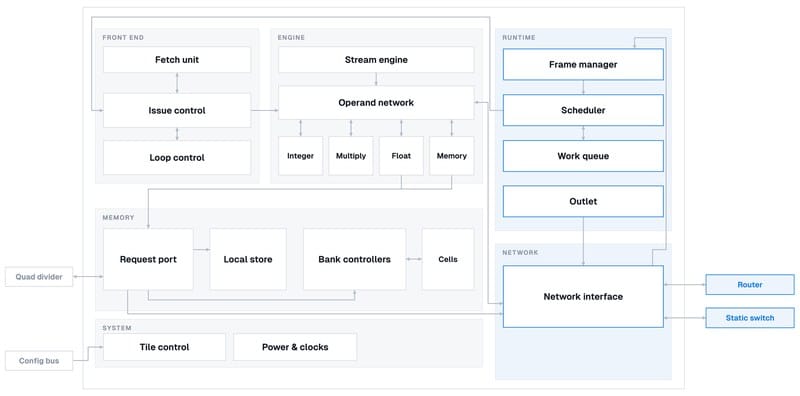
图 8:一个 Frostbite 瓦片。外框展示了该怎么理解各模块的域划分。
其中大部分应该都眼熟。我们关心的是 RUNTIME 域,它负责上面那套偷工作的行为。
编译器把代码切成短段,一旦输入就绪就无中断地跑完。它们在 engine 里执行,大多按传统计算的方式通过 front end 组织。当某个循环或分支裂成大小无法预先知道的并行片段时,正在运行的段会把"后续要执行的"搁进本地内存里的一条小记录——frame manager(帧管理器)。接着它把新任务丢进一条叫 work queue 的硬件队列,自己取走最新的那个。空闲的邻居随后可以顺着网络把剩下的任务拉走。当任务在芯片上任何地方以任意顺序完成时,返回包会递减那条搁置记录上的计数器,并在最后一块到达的瞬间自动唤醒下一段。
在硬件里它长这样:
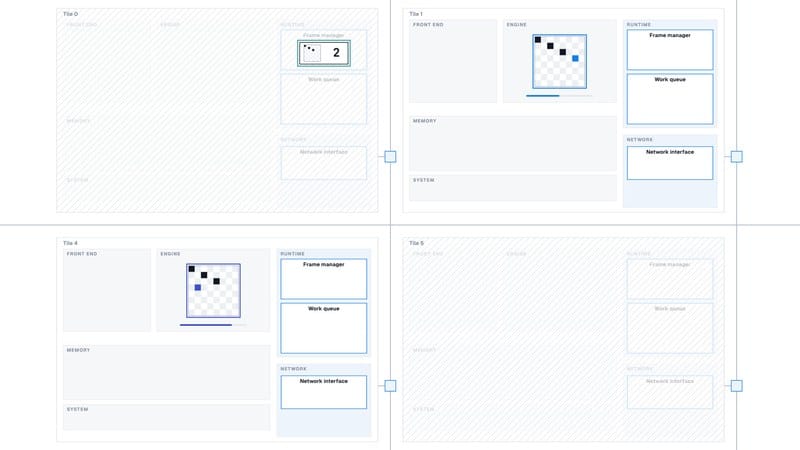
图 9:瓦片如何共享一个负载。原文此处为动画,以下取首帧。
可以把每个"任务"想成当前棋盘往下一层、多一个皇后的那种局面。瓦片 0 得先为所有可能的皇后配置排三个任务,才能结束当前棋盘状态。它有空,于是取走最新那个(来自自己)并运行。与此同时邻居们拿走了其他任务,只有瓦片 5 回去睡了。
这个行为从来没有任何人规定过。我们可以直接把它追溯到特定回归上的必要性,以及针对性能指标的爬山过程。
结果
我们在 7nm 工艺上综合了 Frostbite,综合时达到 800 MHz 时序,最终 GDS 里是 500 MHz。每个 Frostbite quad(2×2 的瓦片阵列)配四个 L3 节点是 0.792 mm²。我们把一个 Quad+L3 集群与一颗现代超标量(双发射、顺序执行)CPU 的单核对比,后者我们称为 TCPU(Traditional CPU),同工艺下 0.895 mm²。†
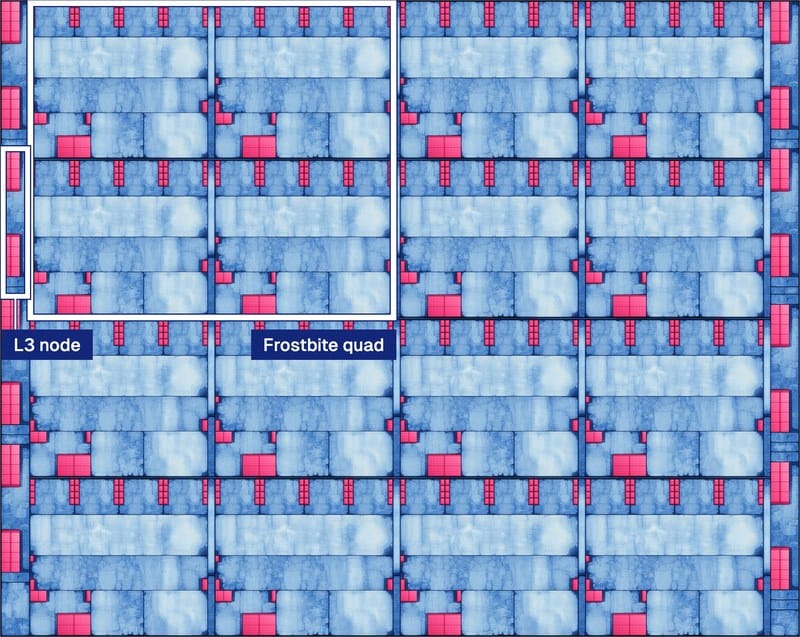
图 10:Frostbite 版图,4×4 瓦片,7nm 工艺,其中框出一个 Frostbite quad(2×2 瓦片)和一个 L3 节点。
我们的负载覆盖面很宽:从 gemm、conv2d 这类密集并行内核,到 JSON 解析、Huffman 编码、k-d 树、递归 Fibonacci 这类不规则、带分支的程序。搜索集的负载驱动了全部架构优化、ISA 设计、RTL 与验证;芯片既在 10 个搜索集负载上评测,也在 15 个留出负载上评测,其中包括后来补的五个实用负载(图 3)。
为了公平比较,我们先用一个 Frostbite quad 对 TCPU 测"单核"性能,因为两者面积接近。在全部负载上,平均每面积性能 8.77 倍;而在全部 25 个负载(搜索集加留出集)上,Frostbite 达到 TCPU 每瓦性能的几何平均 4.59 倍:10 个搜索集负载上 6.02 倍,15 个从未调过的留出负载上 3.83 倍。如预期,这套架构在高度可并行的任务上最强,但在带分支的动态代码上也超过了 TCPU。
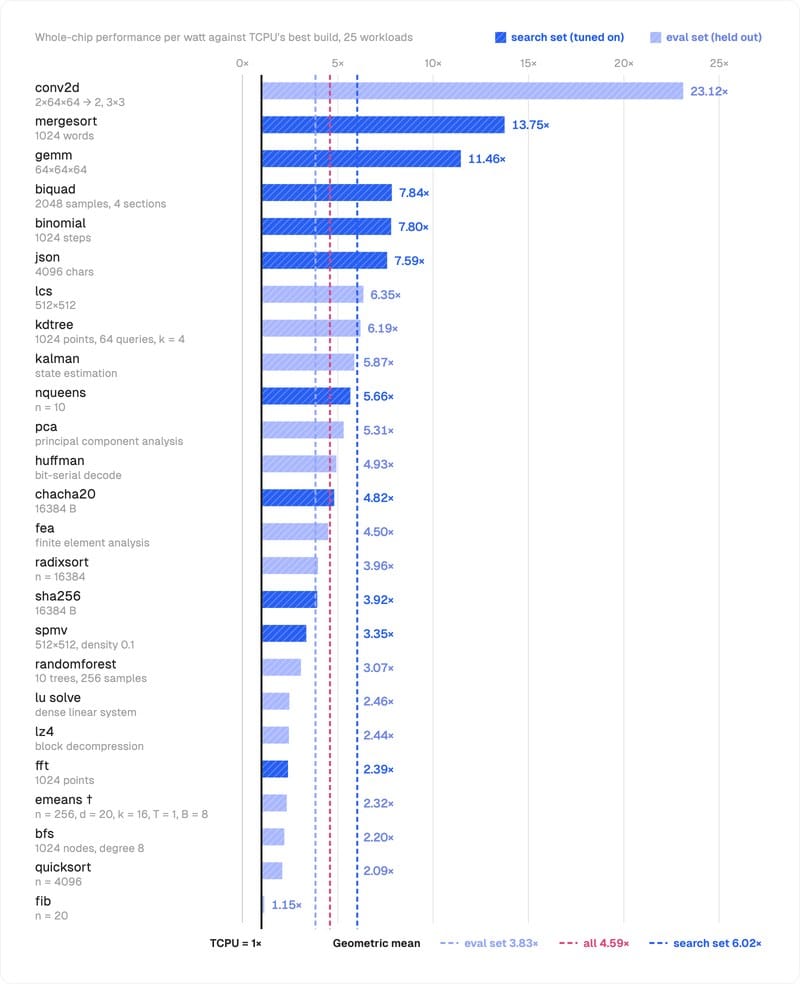
图 11:一个 Frostbite quad 相对 TCPU 最佳构建的每瓦性能,覆盖 25 个负载:搜索集 10 个、留出评测集 15 个。虚线标出评测集、全部 25 个、搜索集三者的几何平均。
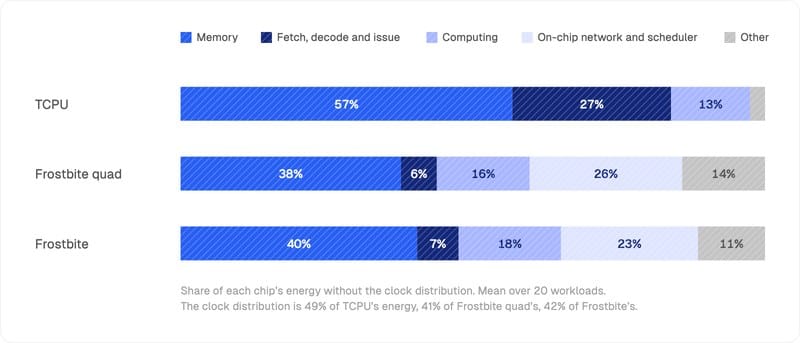
图 12:各芯片按功能划分的能耗占比(不含时钟分布),对比 TCPU、一个 Frostbite quad 和完整的 4×4 Frostbite。20 个负载的平均。
能耗构成说明了节省来自哪里。刨掉时钟分布(占 TCPU 能耗的 49%、占一个 Frostbite quad 的 41%),TCPU 有 57% 的能耗花在内存上,27% 花在取指、译码和发射上。Frostbite 把内存降到 38%,把取指/译码/发射压到只剩 6%;换来的代价是 26% 花在片上网络与调度器上——那是瓦片之间共享工作、传递消息的成本。
更让人兴奋的是,当我们把芯片扩到 4×4 阵列(四个 quad)时,功耗分布基本不变。在通用多核 CPU 的排布里,增加核数就得加厚重的一致性机制和大容量缓存;而跑交互网时,同一套数据局部性规则始终成立,加核不增加系统复杂度。下图说明了这一点。
接下来几个月,我们会在更大的行业基准集(如 SPEC、PARSEC)上,把 Frostbite 的网格式配置与带大缓存的多核 TCPU、更大更宽的超标量 CPU 做对比。
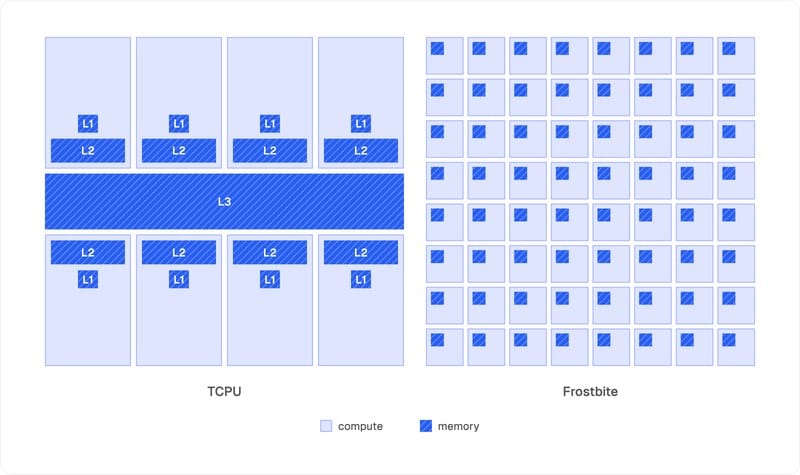
图 13:内存放在哪。多核 TCPU 在核之间共享 L1/L2/L3 的深层次缓存;Frostbite 给每个瓦片自己的小内存。示意图,未按比例。
接下来做什么
交互网存在了 35 年以上,但它的生产价值从未被真正说清楚。历史上,探索分布外(out-of-distribution)架构一直有风险:说服自己需要时间、投资和人力。我们认为 AI 从根本上改变了这笔账。在追求更高性能、更低功耗的路上,负载、ISA 与硬件的极端协同设计会持续被需要。有了大规模的 agent 蜂群、成熟的搜索空间技术、精确的护栏、形式化验证和更快的 EDA 工具,AI 系统将能以超过人类认知的质量去发现并构建新的加速器。还有很多事要做,但把"自主芯片设计的未来可能长什么样"公开出来,我们认为时机到了。
我们计划继续扩大 Frostbite 的开发,包括但不限于:
- 提供一个软件试验场,让任何人能在 FPGA 托管的 Frostbite 上跑程序。
- 做一个初步的操作系统,能管理硬件资源、多程序、虚拟化等。
- 扩大蜂群规模,把 Frostbite 推到更高的每瓦性能,并在更大的负载集上与更多 CPU 对比。
- 公开 Frostbite 的 RTL 与 ISA。
我们玩得很开心。
读这篇要记住的三条边界
一,这是自证,不是第三方复现。 所有数字来自 Architect Labs 自家流程:负载集、对比核、功耗模型都由同一套系统挑和建。原文没有给完整复现脚本,也没给 25 个负载的逐项数字,只给了几何平均与一根柱状图(图 11)——读的时候按"厂商自述"处理。
二,比较对象刻意模糊。 对比的 TCPU 被描述为"现代、硅上验证过的超标量(双发射、顺序执行)核",面积 0.895 mm² @7nm;但原文注明"出于法律原因,不能披露具体是哪颗 CPU"。所以 4.59 倍的分母不是你可以自己复核的东西。另外作者明确说后续才会在 SPEC、PARSEC 上与更大更宽、带大缓存的 CPU 比——现在这版对手是最保守的那一档。
三,perf/W 是硅前估算。 绝大多数数字是综合后、时序收敛前的模型数值;文中也承认 Arcmodel 一开始与 RTL 差了近 250%,靠一次自动校准把误差压进 1–5%。这仍然是"模型对齐模型",要到硅后量产功耗才算落地。
真正值得学的不是"AI 造芯片"这个标题,而是它把单一可证明真源当成护栏:形式化契约在 ISA、模型、RTL、验证之间做翻译与精化,谁都不能偷偷改口径。这是 agent 蜂群能在一个硅片项目里跑起来的前提,和我们做工程侧验证遇到的是同一个问题——只是这里的赌注是一颗芯片。
原文出处
- 原文:Architect Labs, Introducing Frostbite: A new CPU architecture discovered, designed, and verified end-to-end by AI,2026-11-18。 链接:https://architectlabs.com/blog/frostbite
- 前作:Redwood,https://architectlabs.com/blog/redwood
- 参考文献: 1. Lafont, Y. (1990). "Interaction Nets." POPL '90, 95–108. https://doi.org/10.1145/96709.96718 2. The Vine programming language. https://vine.dev 3. Tendrils (2026). "On Interaction Nets." https://tendrils.co/blog/2026-04-26/on-inets 4. de Moura, L., Ullrich, S. (2021). "The Lean 4 Theorem Prover and Programming Language." CADE 28, LNCS 12699, 625–635. https://doi.org/10.1007/978-3-030-79876-5_37
- † 原文注:出于法律原因,无法披露对比 CPU 的具体型号。
延伸阅读:本站《权重空间编程:模型读自己的权重再写回去》、《lint 不够用的地方:AI 生成的代码怎么验》,以及支柱页《AI 编程 / Vibe Coding 完全指南》。
本文由汇智网编译整理,转载请注明出处。
这是「AI 编程 / Vibe Coding」专题的一部分。完整地图见:AI 编程 / Vibe Coding 完全指南