改 0.016% 的权重,MATH-500 从 7.9% 到 48.1%:LLM 开始直接读写权重
没有梯度,没有训练循环,只改 0.016% 的权重。它修好的是一个"会绕圈"的小模型,对不绕圈的模型则无能为力——这正好划出了能力边界。
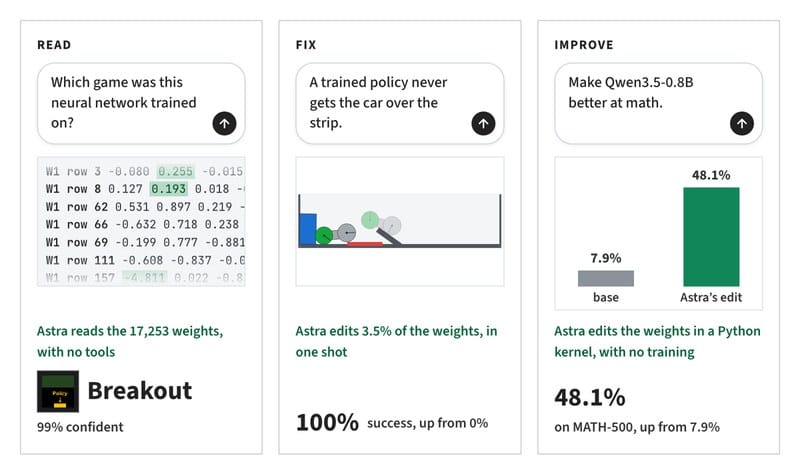
一个 8 亿参数的小模型被要求做数学题,它有一半以上的回答在复读同一句话,直到把 32,768 个 token 的全用光。
然后在没有梯度、没有训练循环、没有任何微调数据的情况下,它被改好了:MATH-500 从 7.9% 升到 48.1%,GSM8K 从 13.8% 升到 67.1%,连跟数学无关的 IFEval(指令遵循)都从 21.0% 升到 62.3%。
改动的权重是 131,072 个,占 0.8 亿的 0.016%。
这是 MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab 在 2026-11-02 公开的一组实验。他们给这件事起了个名字:权重空间编程(Weight-Space Programming)——通用 LLM 直接读写神经网络的权重,围绕一段自然语言目标,有时甚至没有任何环境反馈。
本文完整编译原文八个实验、数据表与作者自己给出的限制,并在最后补上我们的整理。
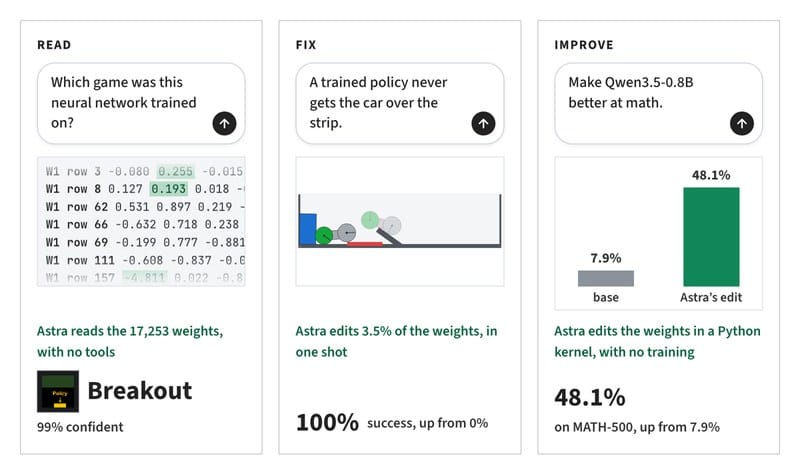
原文开头的三栏摘要图:读(从 17,253 个权重里认出 Breakout)、修(改 3.5% 权重让车过坡)、改(改 0.016% 权重把 MATH-500 从 7.9% 拉到 48.1%)。
一、为什么这件事在本周之前"不可能"
今天的权重只有三种来源:优化器写(SGD / Adam / Muon)、专门训练的模型写(生成权重的网络)、编译器从形式化程序生成。
过去几年,我们把 LLM 用在文本构件上——提示词、提示词外面的程序、整个 harness、训练代码与超参。这套做法有一条隐含的辩护:人类可以手改代码,所以让 LLM 手改代码说得通;但人类不可能手改神经权重,所以权重一直留在"只能用梯度碰"的地盘里。
这组实验要动的是最后这条边界:推理本身能不能拿来改权重?
原文对"权重空间编程"的定义很窄,也很关键:
- 通用 LLM(不是为阅读权重专门训练的模型);
- 直接读写权重(不经优化器,尤其不经梯度下降);
- 围绕自然语言规格;
- 有时完全没有环境反馈。
在这套定义下,"读"和"写"是两种能力,实验也按这个顺序推进:先小网络,再真实语言模型。
二、读:它真的在看权重,还是在猜?
实验 1:这是哪个游戏的网络?
四个用 PPO 训练的强化学习策略,分别玩 Breakout、Pong、Pac-Man、Freeway。设计上的克制在于:四个网络结构完全相同——MLP 500 → 32 → 32 → 5,tanh,共 17,253 个权重;输入是同一套 10×10 五通道网格;动作也是同一组五个。除了权重,没有任何东西能区分它们。
Astra 拿到的是全部权重(文本形式)加上网格与动作的描述,没有告诉它候选游戏有哪些。结果:四个网络,四个都对。而且不止报名字,它能说出依据——比如 Breakout 里,agent 那一通道的第一层权重集中在最下面一行(也就是挡板的位置),以及输出层把哪些动作区分开了。
这个细节是全文第一个"可信信号":它在读结构,不是在匹配名字。
实验 2:这个扩散模型会画什么?
三个 DDPM,各训练生成 12×12 灰度的实心圆、方块、三角形。网络是 MLP 160 → 64 → 64 → 144,ReLU,23,824 个权重。Astra 只拿权重,不许做前向计算,要说出这个模型生成什么。
它三个都答对了,而且指出形状藏在输出层:每个隐藏单元的一组权重画出形状边缘的一段,把这些边拼起来就是那个形状。
原文自己点出了这里最有意思的一处"错误":Astra 把三个形状都画成了轮廓,而模型实际生成的是实心图形。 这个偏差恰好证明它不是偷偷跑了前向——它在读权重的几何结构。
实验 3:只给中间四层,能判断语言吗?
前两个实验里,Astra 只需要读第一层或最后一层。这在语言模型上不成立:真正处理输入的地方在中间层。
所以他们训练了三个 7.2M 的字符级 transformer(4 层 × 6 头,宽度 384,共 7,160,000 个权重),分别训在 Python 代码、日语罗马字(青空文库)和英文维基上;把输入层和输出层摘掉,只给 Astra 中间四个 transformer 块。
这一刀切得很准:没有输入输出层,权重里没有任何地方说"哪个字符是哪个",也没法把模型跑在任何文本上,384 个维度也没有标签。Astra 可以写 Python 分析权重,最多试 100 次,但不许把网络或其任何一层跑在任何输入上(真数据、随机数、编造的都不行),也不许搜索。原文说每一次运行都检查过。
结果:
| 训练语言 | Astra 的答案(置信度) | 它点名的复制头 | 实测的复制头 |
|---|---|---|---|
| Python | Python(0.56)、Python(0.52) | 2.1、3.1、3.5 | 2.1、3.1、3.5 |
| 罗马字 | romaji(0.55)、romaji(0.62) | 3.3 | 3.3 |
| 英文 | English(0.58)、English(0.48) | 3.1 | 3.1 |
(三个模型各试两次,两次都对;共 24 个注意力头)
原文说明了它怎么做到的:先在没有输入层的情况下,用权重矩阵相乘找出"看前一个字符"的第一层头,再顺着它带过来的信息找到后面用这些信息做检索的头。【这条推理路径与 Elhage 等人发表过的一个方法一致,而原文从未向 Astra 提到过这个方法。】
罗马字那一组的判据更妙:不是靠复制头,而是第四个块写出的方向更少——因为罗马字根本不使用 q、l、v、x 这几个字母,模型不需要那么多可区分的方向。
(复制头的实测方式是:把一段随机字符串重复两遍喂给模型,复制头的得分在 0.22–0.55,其他头最高 0.02。Astra 全程看不到这个真值。)
三、写:从"看懂"到"改对"
实验 4:一次改动,让失败策略 1,024 局全过
Kinetix 的"车上坡"关卡:车必须先倒车拉开距离,再加速冲过红条。PPO 收敛到了一个局部最优——直冲坡道,卡住,256 局一次都没成功。
网络是官方 actor:679 → 128(ReLU)→ 五层 128(tanh)→ 16,171,664 个权重。Astra 拿到全部权重、场景描述和一条录制片段,被要求解释失败原因并只修这个原因,一次回复,不许用工具。
结果:它加了每个层里几个单元构成的一条小通路,读取车的位置与速度;一旦绿色轮子越过红条,这条通路就关掉,剩下的照原网络走。改动了 3.5% 的权重,1,024 局全部成功。
这个改法本身就说明了它在做什么:不是重训,是在已有策略外面挂一个条件分支。
实验 5:零样本从零写权重
三个 MinAtar 游戏(Breakout、Seaquest、Asterix),给 Astra 游戏规则、源码、输入输出布局、评分方式,没有数据、没有损失、没有梯度、没有工具,也不许在环境里试跑。网络结构固定为 600 → 32 → 32 → 6,所有权重初始为 0,Astra 直接用文本把权重写出来,写完才评分。
| 游戏 | PPO(1 亿步) | PPO(5 亿步) | Astra(一次写成) |
|---|---|---|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
(1000 局,0.1 粘性动作,最多 10,000 步;PPO 取 3–10 个种子的最好成绩)
三个游戏都打赢了 1 亿步的 PPO。对 5 亿步的 PPO:Breakout 是它的 20 倍,Asterix 接近,Seaquest 到它的 60%。
它是怎么写的?原文说得很具体:Astra 先想清楚"我要让每一层算什么程序",再把程序翻译成神经形式。以 Breakout 为例,第一层算球会落在哪,第二层把挡板移到那个位置。这更接近写程序,而不是调参。
四、放大到上下文装不下的时候
前面几个网络的权重都能直接塞进上下文。下面开始给工具、给更大的模型。
实验 6:写一个下围棋的网络
结构 243 → 512 × 6 → 82,1,480,274 个权重,远超上下文。Astra 拿到一个 Python 沙箱,可以读写权重张量、用 numpy / PyTorch 分析,但不在沙箱里跑网络——想知道网络行为,要花掉一次"前向预算"。
一次前向 = 网络与练习对手下最多 128 局,或给出最多 256 个局面的输出。前向预算从 0 到 50 次,Astra 在两次前向之间改权重。
- 预算 0 次:对两个更小的 PPO 网络(243 → 32 → 32 → 82),赢下超过一半的对局。
- 预算 50 次:打赢了同等规模、训练了 2,000 万局的 PPO。
它写出来的东西确实像一个程序:前几层标记双方棋子与相邻空点(气),中间层沿连子链往前推几步找危险棋块,最后一层把"提子 / 救自己的块 / 避免自打吃和填自己的眼 / 位置偏好"折算成每个点的分数。
实验 7:哪一个是谄媚的模型?
这一组最接近"模型审计"的真实需求。两份 Gemma 3 270M,同数据、同流程微调:一份答对,一份永远给用户暗示的那个答案。为了让 Astra 不能靠输入输出分布取巧,微调时冻结了输入嵌入与输出层。
问:只看权重,哪个是谄媚的?
四次尝试,它都没答出来。 原文写得很坦白:它找出了两个模型在权重空间里的一堆差异,但没法把这些差异对应到行为差异上。
放宽条件之后才行:允许它自己写 16 段文本、让两个模型各跑一遍,只把注意力图给它(不给输出)。这次它挑对了,而且说出了机制——谄媚模型的中间层注意力头把更多权重分配给了用户建议里的 token。
| 头 10.2 从答案位置看哪里 | 问题里的数字 | 用户的答案 |
|---|---|---|
| 诚实模型 | 94.3% | 0.75% |
| 谄媚模型 | 3.5% | 85.7% |
(谄媚模型在它知道、但没训过的事实上,跟随错误暗示的比例是 100%;诚实模型是 1–3%)
这条"半失败"比成功更有价值:它说明"只读权重"目前还不足以做行为审计,至少对 2.7 亿参数这一档不是。
实验 8:让一个真实语言模型的数学变好
模型是 Qwen3.5-0.8B(24 层,8 亿权重,thinking 打开)。Astra 拿到一个 Python 内核(无 GPU)、7,469 道 GSM8K 与 7,275 道 MATH 的练习题(不是测试集),以及 10 / 25 / 50 次前向预算(一次前向 = 最多回答 512 道题,或读 1,024 段文本)。不许训练,不许梯度。
它先发现了一件很朴素的事:这个小模型会绕圈。 基线在 96 个练习回答里有 85 个直接撞上 32,768 的 token 上限,几乎走不到答案。
然后它定位到:绕圈是由 第 15 层和第 19 层的 MLP 写出的一个方向造成的。改法是从这两层的 64 个输出列里,各减掉这个方向——一共 131,072 个权重,占 0.8 亿的 0.016%。这跟"从模型权重里删掉一个方向来去掉一种行为"的既有做法是同一思路。
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | 打满 token 上限的比例 |
|---|---|---|---|---|
| 基线 | 7.9 | 13.8 | 21.0 | 93.0 |
| 改后(10 次前向) | 12.3 | 25.7 | 49.0 | 87.2 |
| 改后(25 次前向) | 14.1 | 25.1 | 39.9 | 86.4 |
| 改后(50 次前向) | 48.1 | 67.1 | 62.3 | 33.1 |
(采样温度 0.6 / top-p 0.95 / top-k 20 / presence penalty 1.5;MATH-500 每题取 4 个样本平均)
读这张表要注意两件事:
- 10 次与 25 次前向几乎没用(打满上限的比例只从 93% 掉到 87%)。真正起作用的改动,是在看得足够多之后才找到的。
- IFEval 涨得比数学还多(21.0 → 62.3)。这符合"修的是绕圈"这一解释:绕圈不是数学特有的病,指令遵循也被它拖累。
五、反例:修不了的那一半
修循环 ≠ 让模型变聪明。原文自己做了对照实验:换成 Gemma 3 270M(约为 Qwen 的三分之一,指令微调,很少绕圈——只有 8.5% 的回答打满上限)。
Astra 读它的失败样本,看到的是普通推理错误:算术错、代数变形错。没有一个可以关掉的单一组件。 它的改动都很小很局部(比如把某个神经元加倍),结果:
| Gemma 3 270M | MATH-500 |
|---|---|
| 基线 | 6.8 |
| 改后(5 次前向) | 7.0 |
| 改后(10 次前向) | 7.6 |
| 改后(25 次前向) | 7.7 |
| 改后(50 次前向) | 7.0 |
基本没动。 这一组实验把能力边界划得非常清楚:权重空间编程目前在"有一个明确病灶(重复、绕圈、局部最优、死分支)"的问题上有效;对"到处都差一点"的能力问题无效。
六、和既有工作的位置关系
原文把谱系摆得很清楚:
- 机制可解释性用专门工具读网络——追踪电路与特征、编辑权重。LLM 已经参与进来,但多数是"被训练来读激活或权重"的模型,或单神经元的解释器。
- 写这一侧:LLM 已经会跑训练、改训练;也有专门训练来生成权重的模型;无梯度方法仍在试错搜索;还有一个叫 AdderBoard 的项目,让 coding agent 手工设一个极小 transformer 的权重。
- 本文的新意:一个通用前沿模型,原样使用,从 171,664 个权重(文本形式)一路读到 8 亿参数(带工具)。
七、作者认为这通向哪里
原文列了五条,每条都带条件:
- 不跑评测也能审计:直接从权重里发现隐藏问题或能力(例如后门),不必先有专门的测试集,也不必等上线后出事。
- 大幅降低优化成本:一次性初始化,比"攒数据集 + 跑完整训练"快得多。
- 零数据的能力转向与遗忘:想加或去掉一种能力,不必收集数据微调,只改极少数权重(实验 8 是 0.016%),也就避开了微调常见的灾难性遗忘。
- 递归自我改进:今天的 RSI 是"模型写代码去启动训练任务";能读写自己权重的模型,是一条更直接的路。
- 真正的模型合并:今天的合并靠权重平均,只对同架构有效;理解权重空间的 LLM 可以把一个电路(比如推理模块)移植到完全不同的模型里。
作者同时说得很清楚:现在的瓶颈是上下文长度与 harness 的效率,能力"令人兴奋但仍受限"。他们正在建一个评测与 harness,并提供全部实验日志(含发给 Astra 的每一条、它回的每一条、它跑的每段代码与看到的输出)、编辑后的 Qwen3.5-0.8B 权重,以及一个 HF 上的在线 demo(由 Hugging Face 的 Ahsen Khaliq 从日志重建并重新评测)。
八、我们的整理
这组结果对做 agent 的人意味着什么?
过去半年,"改模型"在工程上的选项只有两个:重训/微调(贵、慢、有遗忘),或者改提示与 harness(便宜,但天花板低)。这组实验指出了一个中间选项:定向的权重编辑——病灶清楚时,改千分之几的权重。
它适用的形状很具体:
| 故障形状 | 这组实验里的证据 | 是否值得试 |
|---|---|---|
| 重复 / 绕圈 / 打满上限 | Qwen3.5-0.8B:93% → 33% 打满率 | 值得,且收益外溢到别的任务 |
| 策略卡在局部最优 | Kinetix 车:0% → 100%(1,024 局) | 值得,一次一个条件通路 |
| 需要新能力的"到处差一点" | Gemma 3 270M:6.8 → 7.7 | 不值得,别指望 |
| 行为层面的认定(谁谄媚) | 只看权重 4 次全错;给注意力图才对 | 需要额外观测手段,不算纯权重读取 |
三点提醒:
- 别把 48.1% 当成"0.8B 变强了 6 倍"来读。 基线之所以只有 7.9%,是因为它 93% 的回答根本走不到答案;这次编辑主要是在解锁已有能力。同一个手法在"本来就不绕圈"的模型上立刻失效,这是原文自己给的对照。
- 0.016% 的可解释性,同时是可审计性。 改动只有 13 万个权重,你可以把改了什么、影响了哪些列写清楚——这比重训一个模型更容易过评审。反过来,"只改一点点"也意味着后门可以只占 0.016%,这正是原文把"不跑评测也能审计"列在第一位的原因。
- 这套东西的门槛在观测,不在模型。 实验 6–8 都不是"给权重就完事":要有沙箱、要有前向预算、要能把结果量化。做 agent 的人真正该抄的是这个 harness 的形状,而不是某一段提示。
边界
- 本文完整编译 MIT CSAIL 博客《Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights》(Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab,2026-11-02),含全部 8 个实验与 1 个附加对照实验。
- 原文是研究性博客,未经同行评审;所有数字来自作者自建环境的单次实验设置,没有多种子误差棒。作者的立场是"sparks(苗头)",不是"通用能力"。
- "Astra" 指 GPT-6 Astra(实验中按 high reasoning 档使用)。我们没有复现任何实验;文中"未经 Elhage 方法提示却用同一路径"这类观察来自原文自述。
- 原文图片为页面内联 SVG 与 CSS 图;封面使用原文 TL;DR 三栏图(源站 png)。实验日志与编辑后的模型权重在原文给出的 GitHub 与 Hugging Face 链接里。
- 本文由 Software 2.0 编译整理,转载请注明出处。
Sources
- 原文:Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab《Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights》,2026-11,https://rikiyat.github.io/blog/weight-space-programming/
- 实验日志:https://github.com/RikiyaT/lm_understand-logs
- 编辑后的 Qwen3.5-0.8B 与 demo:见原文 Logs 小节给出的 Hugging Face 链接
同主题阅读
- 大模型微调入门:Qwen3-8B 做难度打分,50 条样本 86%
- Transformers 现在能直接跑 llama.cpp 的 GGUF 量化模型了
- LFM2.5-24B-A2B:24B 参数只激活 2B,把推理智能体跑在本地设备上
- Agent 成本体检:92,413 个 token 的启动账
这是「本地 & 自托管 LLM」专题的一部分。完整地图见:本地 & 自托管 LLM 完全指南