BEV视频交通要素检测与跟踪
重新审视并详解我此前的开源应用型项目 OfflineMOT
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
"飞机为我们揭开了地球真实面貌。几个世纪以来,公路一直在欺骗我们。" — 安托万·德·圣-埃克苏佩里,《风、沙与星》(1939)
许多物理的、动态的、宏观的系统,最好从鸟瞰视角研究它们的活动——观察点固定且足够高,以覆盖整个场景;这类情况包括城市交通流或野生动物群体行为。
这个俯视参考点提供了固定观察者的优势,活动被压缩为纯粹的 2D 运动。
在我们的时代,先进技术已经可以实现这种观察者优势,具体来说是使用配备摄像头的四旋翼无人机——它可以长时间飞行,并在不同高度范围内活动。
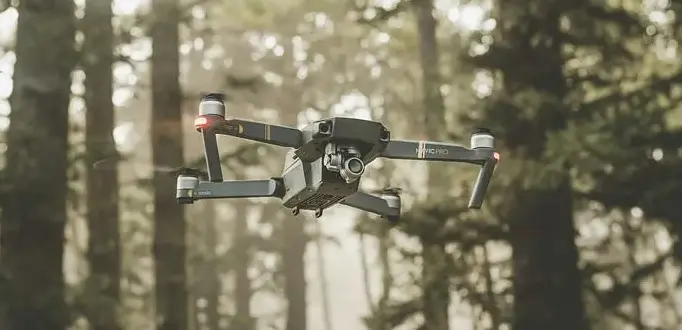
手头的任务是把这些无人机拍摄的录像转换成有用的代表性数据,这正是本文研究的软件所解决的问题:OfflineMOT [1],一个我五年前开发的开源 Python 包,用于混合交通流的多目标跟踪与检测问题。我们将走过它针对的问题、核心的三种技术、每种技术在代码中的实现、结果长什么样、它在哪里失效,以及它接下来可能走向何方。
1、为什么需要专用工具?
MOT 的应用很多,从自动驾驶汽车到交通分析与监控。然而由于场景和时间约束差异巨大,不存在对每种情况都完美的单一方案 [1]。一辆车侧向拍摄交通的车载摄像头,和一架垂直俯拍的无人机,面临截然不同的挑战,为两者兼顾而构建的方法往往在两头都偏弱。
因此 OfflineMOT 解决的是一个更窄的问题:鸟瞰、固定的视频,没有实时性要求。项目启动时,这个具体场景(行人、骑行者和车辆的俯视轨迹)缺乏有针对性的开源方案 [1]。这个包是为从克劳斯塔尔工业大学(TU Clausthal)录制的骑行者行为数据集中提取轨迹而构建的,也服务于任何需要运动物体轨迹的研究者。
*离线(offline)*这个词是关键设计选择。既然精度优先于运行时间,这个包可以承受更慢但更仔细的步骤,比如用深度检测器复查目标,以及在视频结束后对整条轨迹做后处理。
2、相关工作
大多数现代 MOT 方法遵循*基于检测的跟踪(tracking-by-detection)*范式:在每一帧检测目标,然后随时间关联这些检测。SORT [3] 用卡尔曼滤波和基于框重叠的匈牙利匹配做到了这一点,DeepSORT [4] 增加了学习得到的外观描述子来在遮挡中保持身份。Tracktor [5] 走了另一条路,通过把每个框回归到下一帧,把检测器本身变成跟踪器。
后来的工作把关联推得更远。ByteTrack [6] 表明通常被丢弃的低置信度检测有助于找回被遮挡的目标,OC-SORT [7] 则通过更多地依赖观测来减少卡尔曼滤波在遮挡期间的漂移。与此同时,基于 Transformer 的跟踪器如 TrackFormer [8] 和 MOTR [9] 联合学习检测与关联,带着"track query"逐帧传递。
在无人机一侧,VisDrone [10] 和 UAVDT [11] 等基准表明航拍素材本身就是挑战:目标很小、密集排列,且视角不寻常。上述多数方法是为通用基准、在线逐帧运行而训练的。OfflineMOT 选择了相反的取舍:固定的俯视、宽松的时间预算,以及一条可以针对每个新视频调参的流水线。
3、全局图景:三种技术,三个信任层级
OfflineMOT 叠加了三种技术,各处于不同的优先级 [1]:背景减除(最低)、YOLOv4 深度学习检测(最高)、以及居中的核相关滤波器(KCF)单目标跟踪。每个部分住在自己的模块里,可以单独启用、禁用或调参。
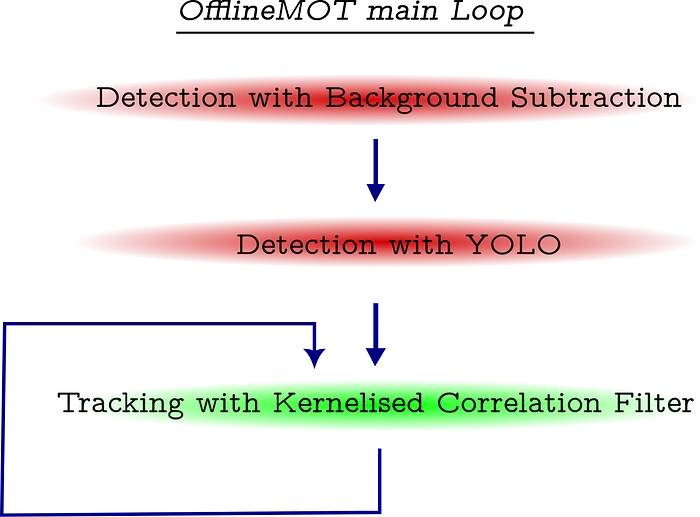
分层背后的逻辑很简单。背景减除便宜,能抓住一切移动的东西,但它对目标是什么一无所知。跟踪器逐帧跟随每个目标,而检测器——最昂贵也最受信任的部分——确认目标是什么并修正它的框。
背景减除发现的移动团块不会立刻变成被跟踪的目标。它进入一个候选列表,安静地被跟踪,直到 YOLO 确认它是行人、骑行者或汽车。只有到那时它才获得 ID 并加入已确认目标。
每个目标还保留一小段历史:对每一帧,三个标志表示它是被检测到、被跟踪到,还是被背景减除确认的。这段历史稍后决定目标是否真实、是否丢失,以及哪些帧需要插值。JOSS 论文中发布的完整工作流如下所示。
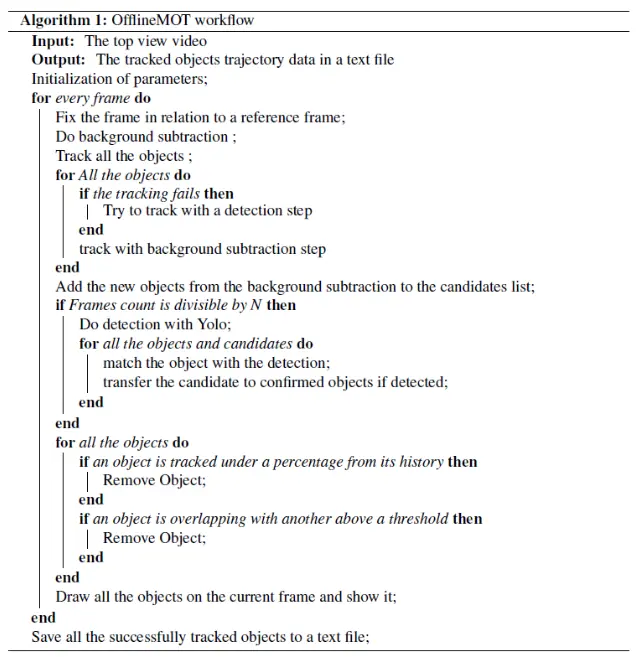
在代码中,整个循环就是 core.py 里的 extract_paths 函数。它按编号步骤组织,接下来的三节我们会一个技术一个技术地跟着走。
4、技术一:背景减除
4.1 理论
固定相机下,交通场景中的大多数像素在每一帧显示同样的道路、草地或屋顶。背景减除利用了这一点:它学习每个像素正常外观的统计模型,并把偏离它的像素标记为前景。经典表述把每个像素建模为高斯混合 [12],后来在分量数目上做成了自适应的 [13]。
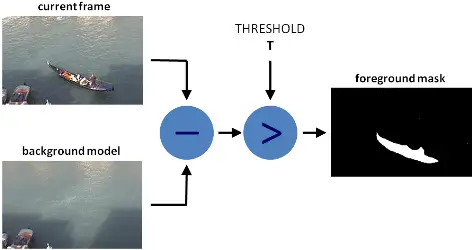
OfflineMOT 使用 OpenCV 中可用的 K 近邻(KNN)变体 [14]。它不拟合高斯,而是为每个像素保留一组近期样本,如果足够多的样本落在距离阈值内,就把新像素标为背景。它还能标记阴影,这对户外无人机素材很实用。
4.2 为何选择它
背景减除快、不需要训练,而且与类别无关。它抓住一切移动的物体,包括检测器从未见过的目标,因此可以作为一个便宜的运动候选阶段。它的弱点是静止假设:如果相机漂移,整张图像看起来都是前景。
悬停的无人机永远不会完全静止,因为有风和控制噪声 [1]。因此 OfflineMOT 包含一个可选的视角固定步骤,在减除之前把每一帧重新对齐到参考背景。
4.3 实现
background_subtraction.py 中的 BG_subtractor 类封装了 OpenCV 的 KNN 减除器。在每个新帧之前,当前背景图像会以较高的学习率喂给模型四次。这把模型锚定在最新的干净背景上,让缓慢的道路使用者不太可能被它吸收。
然后掩码被腐蚀以去除斑点噪声,阴影像素(OpenCV 中灰度值 127)被丢弃。每帧还事先用 CLAHE 在其亮度通道上做对比度增强(core.py 中的 enhance 函数),为减除和检测都均匀化光照。
掩码由 get_big_objects 转成目标。它用 scikit-image 标记连通区域,只保留大于 bgs_min_area 像素且extent(区域面积除以其外接框面积)合理的区域。细长条状的区域通常是噪声,不是道路使用者。
5、技术二:YOLOv4 深度检测
5.1 理论
YOLO [15] 把检测当作单个回归问题。卷积网络的一次前向传播把图像划分成网格,对每个单元格预测边界框、置信度分数和类别概率。最后的非极大值抑制(NMS)步骤去除重复的框。
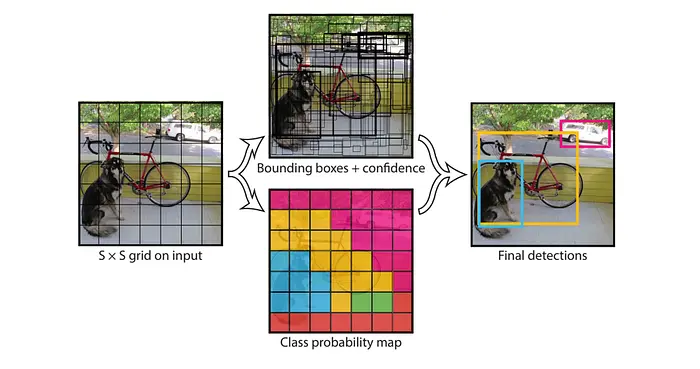
YOLOv4 [16] 保留了这种单阶段设计,并汇集了当时的最佳实践:CSPDarknet53 主干、SPP 与 PANet 颈部、YOLOv3 检测头,并用"免费技巧包"(如 Mosaic 增强)训练。结果是一个强劲的速度-精度折中,且能在单张消费级 GPU 上训练。
5.2 为何选择它
背景减除和跟踪告诉我们东西在哪里,但不告诉我们它们是什么。检测器是唯一分配类别的部分,因此它获得最高优先级:当它触发时,它的框覆盖另外两个阶段。
YOLOv4 在当时是自然之选。它文档完善,可用 Darknet 在自定义数据上训练,也能移植到 PyTorch。随包发布的网络是在行人、骑行者和汽车的俯视图像上训练的,标注与训练都在克劳斯塔尔工业大学内完成。
5.3 实现
detection.py 中的 YoloDetector 类加载 Darknet 配置(.cfg)和 PyTorch 权重(.pth),使用 pytorch-YOLOv4 项目 [17] 的转换脚本(都在 offlinemot/tool 子目录中)。
6、技术三:相关滤波跟踪(以及卡尔曼滤波)
6.1 理论
核相关滤波(KCF)[18] 是相关滤波跟踪家族中的单目标跟踪器。从第一个框开始,它学习一个对目标响应强、对周围响应弱的滤波器。在每个新帧中,滤波器响应的峰值给出新位置,滤波器则在线更新。
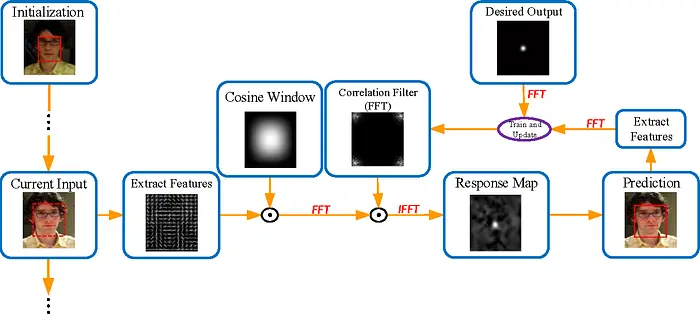
巧妙之处在于它的学习方式。KCF 在目标图像块的所有循环移位上训练一个岭回归——这些移位构成一个循环矩阵。循环矩阵可被离散傅里叶变换对角化,因此训练和检测都归结为频域中的逐元素运算,而核技巧以很小的代价加入非线性。
6.2 为何选择它
KCF 每秒能跑几百帧,不需要在目标域上训练,还会报告自己成功还是失败 [1]。这个失败信号正是 OfflineMOT 需要的:一次跟踪失败触发一次检测步骤,而不是在每一帧都运行昂贵的检测器。
俯视视角也对 KCF 有利。从上方看的汽车在穿越场景时几乎保持相同的形状和尺度,这很适合基于模板的跟踪器。
在 2023 年的一次更新中,增加了两个选项:GOTURN 跟踪器 [19]——一个离线训练的回归网络,作为 KCF 的即插即用替代品;以及一个融合全部三路证据的卡尔曼滤波 [20]。两者都通过配置开启(Tracker_goturn、use_kalman)。
6.3 实现
每个道路使用者是一个 TrafficObj 实例(objects_classes.py),持有自己的 OpenCV 跟踪器。每一帧,track() 调用 self.tracker.update(frame),略微放大返回的框,并在框变得太小时重新初始化跟踪器。
开启卡尔曼滤波后,状态是两个框角加一个共享速度,x = [x1, y1, x2, y2, vx, vy],采用匀速模型。关键思想是每一路证据都有自己的观测噪声:
检测噪声随 YOLO 置信度增长而收缩(detection_min_var/(1+p)),而跟踪和背景减除使用固定方差(tracking_var、bgs_var)。更新本身是教科书式的卡尔曼步骤,带一个马氏距离门,拒绝离预测太远的检测或背景观测:
z = self.get_state(box=new_box)[:4]
m_dist = mahalanobis(x=z, mean=self.x[:4], cov=self.P[:4,:4])
if m_dist > self.cfg.mahalanobis_dist and way != 2:
    return None
...
R = self.get_R(way, self.last_detect_prob, new_box[2:])
S = dot(self.H, self.P).dot(self.H.T) + R
K = dot(self.P, self.H.T).dot(inv(S))
y = z - dot(self.H, self.x)
self.x = self.x + dot(K, y)
self.P = self.P - dot(K, self.H).dot(self.P)
目标的生命周期由 update() 管理,使用前面提到的三标志历史。经过 min_history 帧后,确认太少的目标被当作噪声删除。确认帧占比掉到 missing_thresh 以下的目标被视为丢失,如果它曾是真实、已分类的目标,则予以保存。
重叠目标在主循环的第 10 步处理。当两个框的重叠超过 overlap_thresh 时,较弱的一个被删除——除非它有长久且可信的历史,那样的话它的框会回滚到上一帧。
7、运行框架
OfflineMOT 在 PyPI 上,安装只要一行:
pip install offlinemot
一切通过一个 configs 对象控制,它可以打印、在代码中编辑,并保存为 .ini 文件供相似视频复用。最快的测试是运行自带的示例视频:
import offlinemot
from offlinemot.config import configs

cfg = configs()                 # or configs('my_params.ini')
cfg.print_summary()             # show the current values and sections
cfg['detect_every_N'] = 3
cfg['detect_thresh'] = 0.4      # YOLO confidence, between 0 and 1
offlinemot.core.extract_paths(config=cfg)   # no path = the example video
cfg.write('new_config_file.ini')            # reuse for similar videos
首次运行时会下载示例 YOLO 模型(约 250 MB),一个窗口会实时显示被跟踪的目标。要处理你自己的视频并回放后处理结果,传入其路径:
offlinemot.core.extract_paths('path_to_video', config=cfg)
offlinemot.show_results.show_result('path_to_same_video', config=cfg)
结果保存在视频旁边的文本文件里,每个目标每帧一行:frame_id [top_left_x top_left_y width height] class_id track_id angle。例如,39 [3748, 964, 169, 73] 2 5 138 表示第 39 帧的 5 号目标——一名骑行者,朝向 138 度。
两个小功能对困难视频有帮助。用 manual_start,你可以在第一帧上为检测器漏掉的目标画框。从 2023 年起,运行中按 s 可以暂停,让你手动纠正跟踪。
8、结果
下面的 GIF 展示了 OfflineMOT 在车辆-人群交互(VCI)CITR 数据集 [2] 示例视频上的表现。框按颜色编码:绿色是行人,蓝色是骑行者,黑色是汽车,红色表示当前帧跟踪失败,白色是尚未分类的移动物体。
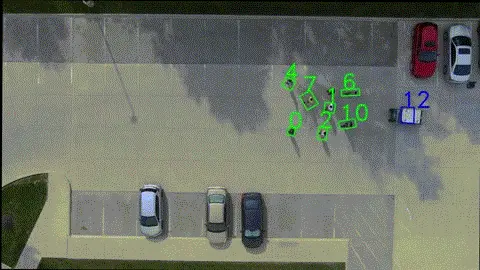
大多数道路使用者被识别出来,并以稳定的身份穿越人群。注意这个场景、它的背景和无人机相机从未出现在检测器的训练集中,这解释了你可能看到的少数小故障。在这个包所构建的骑行者数据集上,结果在不同场景和条件下都非常准确 [1]。
9、失效案例
最常见的错误来源是检测器。如果视频有噪声、分辨率低,或与检测器的训练图像差异很大,跟踪错误就可能随之而来 [1]。上面的示例视频就是一个例子:一个移动物体引发问题,因为背景和场景对网络来说是新的。
论文建议的补救措施有两条 [1]。第一,在与目标视频相似的例子上重训 YOLO 网络。第二,通过 configs 类彻底调参,因为对某个高度或相机有效的值,换一个可能就失效。
设计本身还意味着几条限制:
- 密集人群。 检测与目标的匹配是贪心的,按中心距离和尺寸,而非全局分配。在拥挤人群中,两个邻居可能互换框和身份。
- 长时间遮挡。 树木、桥梁或大型车辆可以把一个道路使用者藏住很多帧。没有基于外观的重识别,所以一个丢掉后重新出现的目标会拿到新 ID。
- 移动相机。 视角固定修正的是风引起的小漂移,不是平移或飞行中的无人机。自由移动的相机会彻底破坏背景减除 [1]。
- 运行时间。 在全帧和放大裁剪上做检测——通常每帧都做——很慢。这是离线设计的代价,不是 bug。
当确实出问题时,2023 年的手动纠正功能提供了一个实用的逃生舱:按 s 暂停,重画框,然后让跟踪器继续。
10、接下来可能走向何方
自 2022 年 OfflineMOT 发布以来,这个领域发展迅速。三个方向格外突出,从最容易到最有雄心。
10.1 重训,或替换,检测器
既然多数错误来自检测器,在与目标视频相似的素材上重训 YOLO 就是第一补救措施 [1]。训练好的网络可以来自 Darknet 或 pytorch-YOLOv4 [17],接入它只需三个路径:
cfg['model_name'] = 'path/to/weights.pth'          # trained weights
cfg['model_config'] = 'path/to/yolov4-custom.cfg'  # network structure
cfg['classes_file_name'] = 'path/to/obj.names'     # one class name per line
更大的一步是换现代检测器。当前的 Ultralytics YOLO 版本 [21] 易于微调,并包含在 DOTA 航拍数据集 [22] 上预训练的定向边界框(OBB)模型。旋转框比轴对齐框更适合从上方看到的汽车,而且免费附送朝向。
集成成本按设计就很低:检测器完全活在 YoloDetector 里,新后端只需返回同样的 (top_left, bottom_right, confidence, class_id) 元组列表。VisDrone [10] 和 UAVDT [11] 等航拍基准可以作为额外训练数据。
10.2 用于跟踪的 Transformer 与基础模型
TrackFormer [8] 和 MOTR [9] 这类 Transformer 跟踪器端到端地学习关联,而不是依赖 dist_thresh 这类手工设定的阈值。MOTRv2 [23] 更进一步,把预训练检测器的候选框喂给 MOTR,这很接近 OfflineMOT 自己的哲学——由强检测器引导跟踪器。
基础模型打开另一条路。SAM 2 [24] 可以接受一个框提示(比如来自 YOLO),并用流式记忆把像素级精确的掩码在视频中传播。掩码给出道路使用者的真实轮廓和朝向,而离线设置留下空间让它在时间上向前和向后双向传播并调和两者。
代价是算力,以及对端到端跟踪器而言,用于训练的带标注俯视视频。两者在离线场景下都比在线更可接受。
10.3 在线兄弟:OnlineMOT
相反的方向是实时使用,例如来自无人机的实时监控。这里,逐目标的 KCF 跟踪器和贪心匹配会让位给全局的基于检测的跟踪关联,如 ByteTrack [6] 或 OC-SORT [7],它们也会修复密集人群中的 ID 互换。
如今其中大部分几乎已是现成的。Ultralytics 内置六种跟踪器,包括 ByteTrack、OC-SORT 和 BoT-SORT,跟踪也适用于其 OBB 模型 [21]:
from ultralytics import YOLO
model = YOLO('path/to/top_view_obb.pt')  # fine-tuned on drone footage
results = model.track(source='drone_video.mp4', tracker='bytetrack.yaml')
最有前景的设计可能融合两个世界:一遍快速的在线过程产出轨迹,然后 OfflineMOT 的离线阶段用平滑、类别投票、间隙插值和背景减除检查漏检目标来精修它们。
原文链接: Detection and Tracking of Multiple Traffic Elements from Top-View Videos: Project Spotlight
汇智网翻译整理,转载请标明出处