打造自己的 PR 审查智能体
我已经做过几版自动化的 PR 审查器,最让我一直印象深刻的是:AI 那部分出奇地小。
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
我已经做过几版自动化的 PR 审查器,最让我一直印象深刻的是:AI 那部分出奇地小。
对于一篇讲 AI 审查智能体的文章来说,这话听着可能有点怪,但在实践中,系统的大部分就是普通的软件工程。你接收一个事件、决定要不要做点什么、收集上下文、启动一次隔离的运行、通过编码 harness 调用模型、解析结果,再把发现回贴到源系统。
这篇文章讲的是架构。示例中 LLM 那一侧我会用 GitHub Copilot SDK,因为它和这类编码智能体工作流贴合得很干净。整体模式换成其他 harness 或者普通 CLI 也一样好用。
快速总结:
- 主要是控制流,不是 AI。 PR 机器人就是普通的事件驱动软件,LLM 只是其中一个阶段。
- 智能体负责审查,不负责跑业务流程。 审查周围的一切都应该是普通代码。
- 事件驱动是自然的形态。 接收 PR 事件、收集上下文、运行一次有边界的审查、回贴结构化结果。
- 编码 harness 非常契合,因为它们本来就知道怎么读文件、检查仓库、执行命令。
- 结构化输出很重要。 模型的发现应该便于你的代码在回贴之前进行校验。
- 同一套架构可以泛化。 任何有明确开始、处理、结束的 AI 自动化都能用这个形态。你同样可以基于 GitHub Actions,(2026.3.23 编辑)甚至全新的 Agentic Workflows 来做同样的事。
1、机器人本身很简单
从高层看,PR 审查器并不是什么复杂的产品。
你的源系统里发生了点什么:一个 pull request 被创建、更新、被评论,或被显式标记为需要审查。你的系统决定这个事件是否应该触发审查,收集仓库上下文,运行审查逻辑,然后把发现回贴回去。
这听起来几乎无聊,而这正是重点。这是我强烈认为的、关于好的 LLM 系统的关键之一:让它们尽可能确定。不要让智能体决定自己身处什么流程。让代码来决定。
智能体的工作是审查这个变更。它周围的一切都应该是普通软件。
2、触发审查
启动方式有几种显而易见的选择:
- PR 创建时总是审查。 简单且覆盖面广。
- 创建和更新时都审查。 覆盖迭代过程。
- 只在显式命令时审查。 控制成本和噪音。
- 由 UI 动作触发。 面向产品特定的入口。
这主要是产品决策,不是 AI 决策。你也可以混搭:一个轻量的默认审查,加上按需的更深的专项审查。
触发事件几乎可以是任何东西。我经常用 PR 事件,但同一套架构也适用于 issue 分诊、工单分类、bug 复现、文档生成,或者任何由系统事件开启一段有边界工作的场景。
3、ADO service hooks 作为集成点
在 Azure DevOps 里,service hooks 是天然合适的选择。它们本质上是一种事件订阅机制:发布方发出事件,订阅方进行过滤,然后一个 webhooks consumer 把 JSON 负载发送到你的 HTTPS 端点。
对 PR 自动化来说,有意思的 事件 有:
- pull request 创建
- pull request 更新
- pull request 被评论
- pull request 尝试合并
Azure DevOps 允许你控制 webhook 负载里带多少资源细节。我更喜欢较小的负载,事后再自己拉取完整的 PR 详情。这样 webhook 接收端更简单,也把上下文收集强制收敛到一条一致的路径上。
4、架构重于模型
我一直在用的形态相当简单:
- 源系统事件到达。
- 管理层判断是否应该启动工作。
- 管理器收集足够的上下文来创建一个审查任务。
- 管理器把运行状态存入数据库。
- 管理器启动一次隔离的 worker 运行。
- 执行 LLM 审查并返回结构化输出。
- 管理器解析结果,把评论或发现回贴到源系统。
- 管理器更新运行状态。
注意,LLM 只是整条流水线中很小的一部分,而且这套逻辑毫无火箭科学。
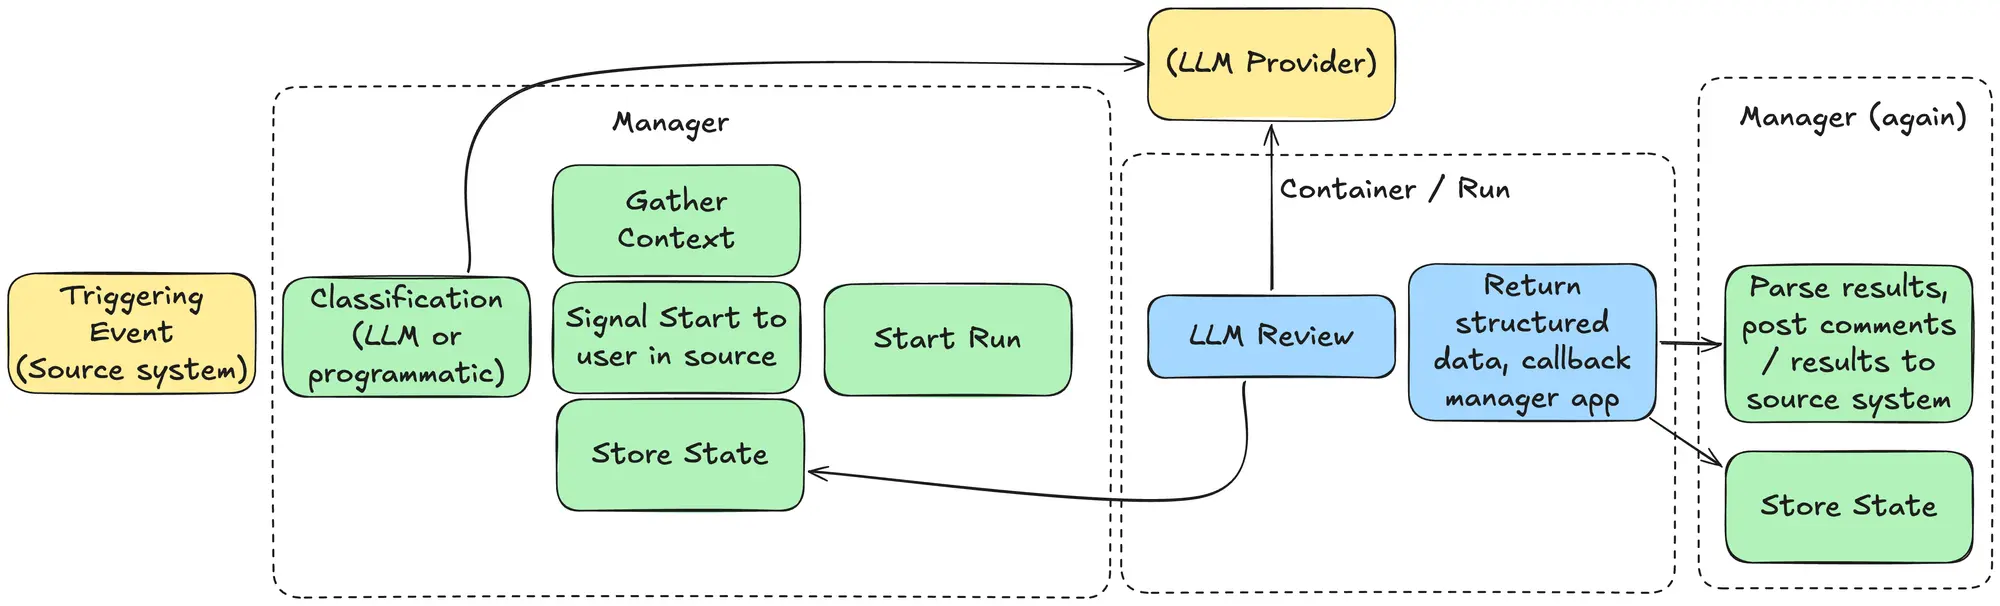
我自己的实现用 Azure Functions 做管理层,用 Azure Container Apps jobs 做隔离执行。函数接收 Azure DevOps webhook,并为每次审查启动一个 container app job。我喜欢这个形态,因为每次审查都是隔离的:有自己的执行、日志和失败边界。
另一个我觉得有意思的选项是基于 microVM 的沙箱。如果你之后想要更容易地恢复会话,或者想在沙箱里跑嵌套容器执行,它就开始变得重要。对简单的审查流程来说,容器 job 通常就够了。MicroVM 在业界确实正在起飞,各种能快速拉起隔离沙箱的服务遍地开花。自从读了 Ramp 这篇文章之后,我就一直打算基于它来构建。在我看来,主要好处是也能很轻松地在 microVM 内的容器里运行应用。
状态存储方面,几乎什么都行。我用过表格存储,完全够用。如果你真正需要的只是运行状态、关联 ID、状态和回贴结果的元数据,那并不需要什么特别高级的数据库。
5、AI 只是其中一个阶段
AI 阶段不需要拥有整个审查流程。它不需要决定任务何时启动、重试如何进行、状态存在哪里、评论如何回贴,或者 webhook 幂等性如何处理。这些都是普通的应用逻辑。
LLM 的工作要小得多:
- 检查仓库和 PR 上下文
- 审查这个变更
- 返回结构化发现
我认为这些有边界自动化的最健康心智模型,是把 LLM 当作另一个 API 依赖。用例越小、边界越紧,护栏就应该越严。如果任务更宽、更具探索性,你可以放松一些。
6、为什么编码 harness 很契合
PR 审查正是编码 harness 非常自然契合的场景之一。模型需要的能力,恰好就是这些 harness 已经提供的:读取文件并检查 diff、搜索代码库,以及按需执行命令,比如 lint、类型检查或项目特定的校验。
这就是为什么这件事用编码 harness 来做效果最好,而不是在 LLM API 外面套一层薄薄的纯文本包装。
我用 Copilot SDK 和 OpenCode SDK 都实现过;说实话,只要你的流程足够简单,直接用 CLI 也可以。关键不在于具体哪个 SDK,而在于运行时本身理解面向代码的工具。
根据你的信任模型,你可能还想让审查智能体执行 bash 命令。这能明显提升审查质量,但显然也要求更强的隔离和权限处理。纯审查类的工作没有命令执行大概也行,但如果你想进到修复建议和验证那一步,它就变得更重要了。
7、掌控编排,而不是控制流
你的代码应该决定:
- 何时启动一次审查,以及该事件是否有资格
- 检查哪个仓库或提交范围
- 使用哪套智能体配置
- 如何处理重试、去重、超时和结果回贴
LLM 应该决定:
- 这个变更是否看起来有风险、是否存在安全问题
- 测试是否看起来缺失
- 发现应该如何总结
这种划分让整个系统更容易推理,也更容易信任。
8、LLM 运行的内部
在审查运行内部,我并不太喜欢让一个巨大的智能体包办一切。 对我更有效的是:一个主审查者并行分发给各个专项智能体,然后综合它们的输出:
- 一个主审查者智能体
- 若干并行的专项子智能体(其实只是一个子智能体,拿到关于该使用哪些 skill 的指示——通常每个专项对应一个 skill)
- 一个最终的综合步骤,产出结构化的审查输出
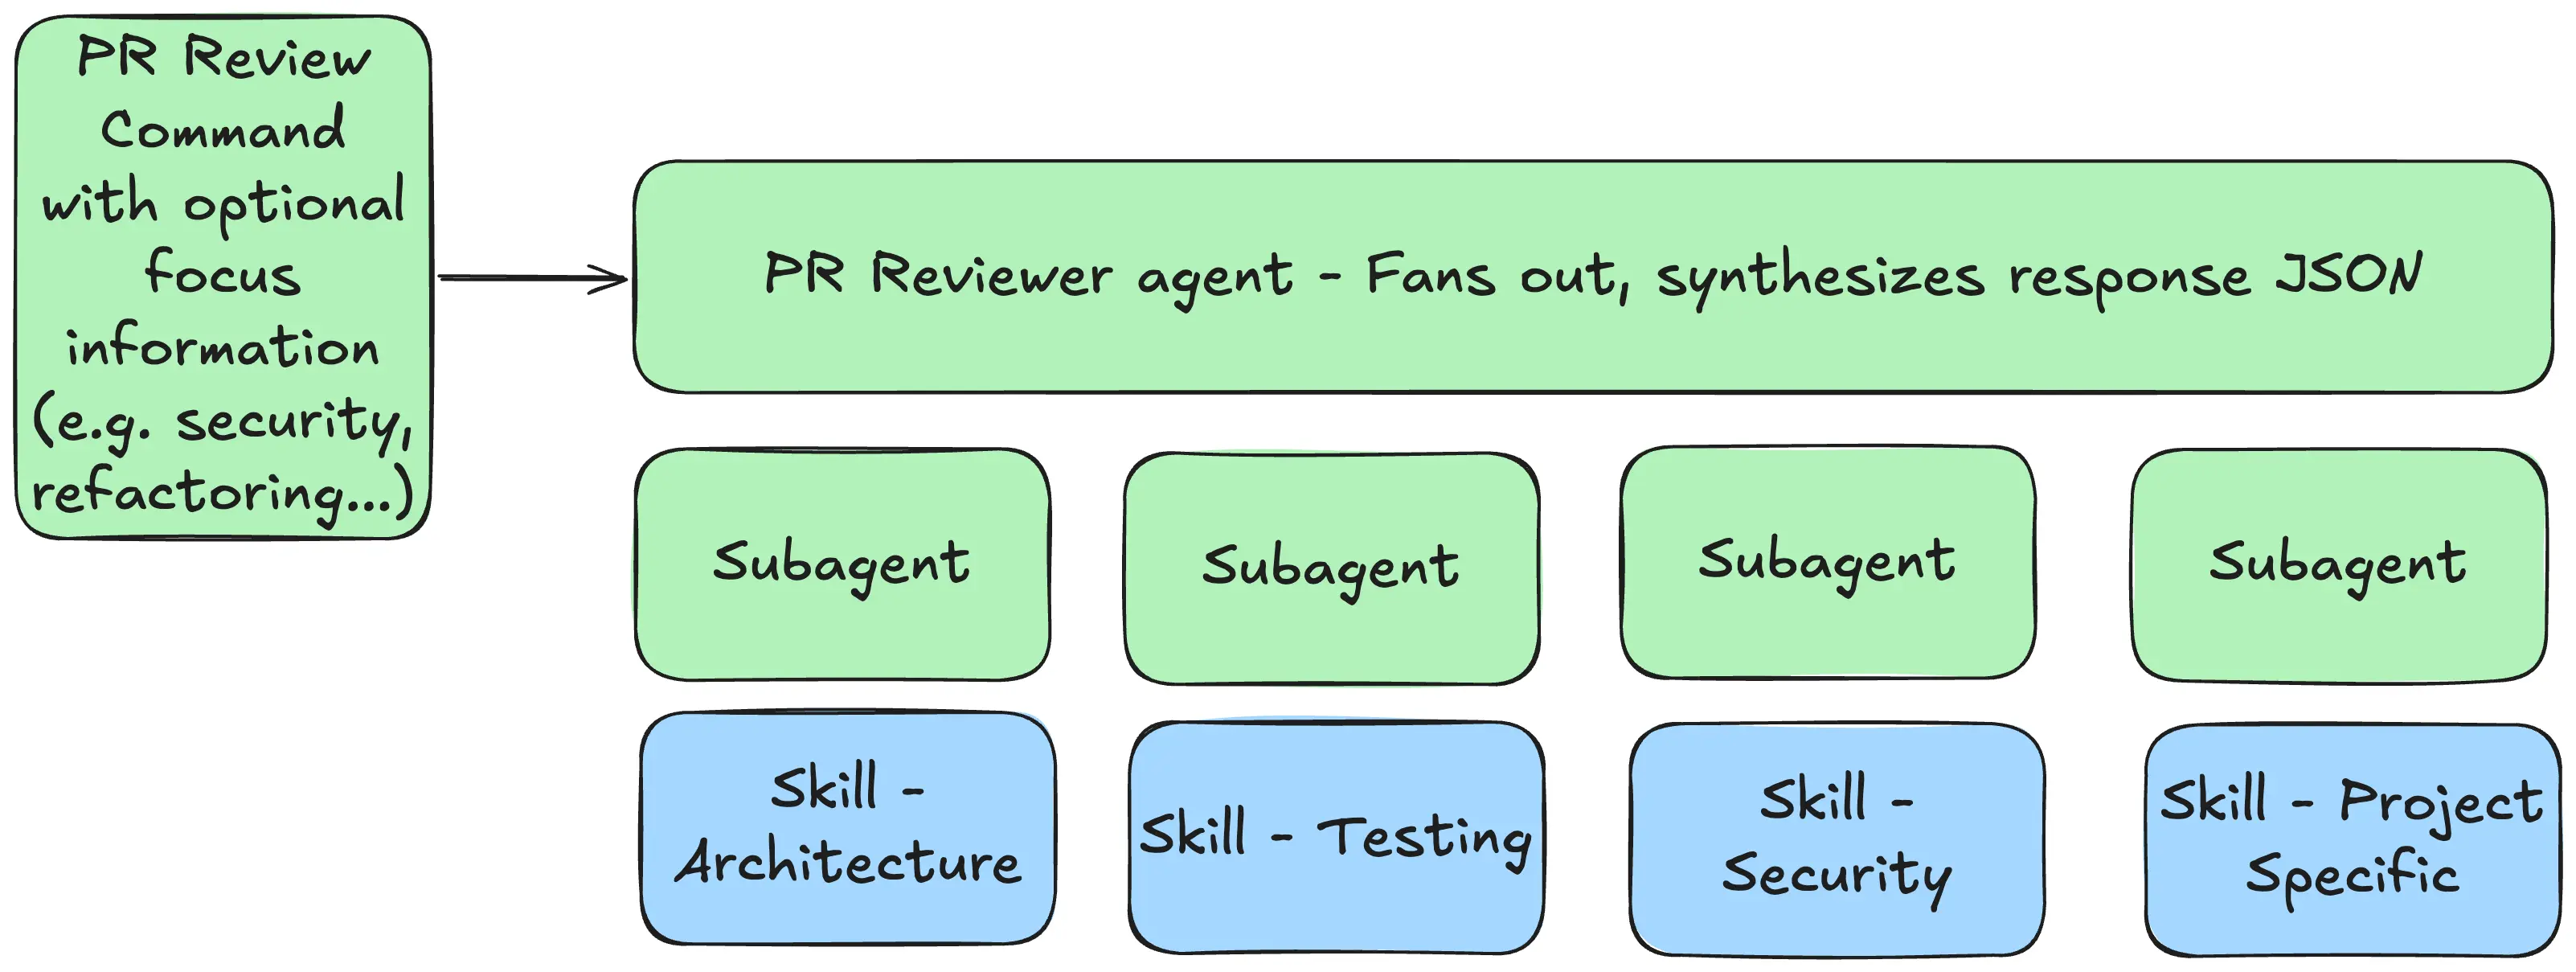
这跟我之前写的那些原语对应得很直接。命令包含做什么的指示,智能体包含怎么做的指示,skill 则打包某个专项可复用的领域指导。
在实践中,专项智能体可以是比如架构审查者、测试审查者、安全审查者、项目特定审查者,或者任何对你的代码库和团队最有意义的角色。重点是从不同视角切入这个问题。
严格来说,你还可以更进一步:去掉主审查者,把审查请求直接发给各专项智能体,事后只做综合。后面的例子里我就是这么做的,不过两种方式都好用。
具体数量取决于系统。一个很小的单文件变更不需要一支子智能体大军。如果审查范围窄,一个智能体通常就够了;如果审查范围更广、工作可以并行,多个专项智能体更合理。这种并行带来的延迟改善通常大于代价,当然成本会上升。
9、Copilot SDK 示例
Copilot SDK 很适合这件事,因为它通过编程接口暴露了 Copilot CLI 背后的同一套运行时。SDK 通过 JSON-RPC 与 CLI 通信,你创建的会话可以使用内置编码工具、自定义智能体、skills、MCP 服务器和 hooks。
有用的部分没有什么魔法:你定义一次会话,然后让它恰好执行一个有边界的审查任务。
下面是一个大幅简化(而且不太完整)的 TypeScript 示例:
import { CopilotClient } from "@github/copilot-sdk";

const client = new CopilotClient();
await client.start();

const outputShape = `
{
  "summary": "string",
  "findings": [
    {
      "severity": "critical|high|medium|low",
      "title": "string",
      "path": "string",
      "line": 123,
      "body": "string"
    }
  ]
}`;

const reviewTask = `
Review this pull request in the current repository checkout.

Focus only on concrete issues in the changed code.
Use repository tools as needed.
Return JSON only in this shape:

${outputShape}
`;

const customAgents = [
  {
    name: "architecture-reviewer",
    description: "Reviews architecture and maintainability risks",
    tools: ["grep", "glob", "view", "bash"],
    prompt: `
Review the pull request from an architecture perspective.

Focus on boundaries, coupling, maintainability, layering, and long-term code health.

${reviewTask}
`,
    infer: false,
  },
  {
    name: "security-reviewer",
    description: "Reviews security issues and dangerous patterns",
    tools: ["grep", "glob", "view", "bash"],
    prompt: `
Review the pull request from a security perspective.

Focus on authentication, authorization, secrets handling, injection, trust boundaries, and unsafe execution patterns.

${reviewTask}
`,
    infer: false,
  },
];

async function runReviewer(agent: string) {
  const session = await client.createSession({
    model: "gpt-4.1",
    agent,
    customAgents,
    onPermissionRequest: async () => ({ kind: "approved" }),
  });

  try {
    const response = await session.sendAndWait({ prompt: reviewTask });
    return JSON.parse(response?.data.content ?? '{"summary":"","findings":[]}');
  } finally {
    await session.disconnect();
  }
}

const specialistReviews = await Promise.all([
  runReviewer("architecture-reviewer"),
  runReviewer("security-reviewer"),
]);

const synthesis = await client.createSession({
  model: "gpt-4.1",
  onPermissionRequest: async () => ({ kind: "approved" }),
});

try {
  const response = await synthesis.sendAndWait({
    prompt: `
You are the parent PR reviewer.

Merge overlapping findings from these specialist reviews and return one final review.

${JSON.stringify(specialistReviews, null, 2)}

Return JSON only in this shape:

${outputShape}
`,
  });

  console.log(
    JSON.stringify(
      JSON.parse(response?.data.content ?? '{"summary":"","findings":[]}'),
      null,
      2,
    ),
  );
} finally {
  await synthesis.disconnect();
  await client.stop();
}
10、Skills、智能体与结构化输出
我不会把这一切构建在单个巨大的 system prompt 之上。我喜欢的切分方式是:
- 命令或任务指示: 当前这次运行应该做什么
- 智能体提示词: 每个专项负责什么
- Skills: 该专项该如何运作的可复用指导
Copilot SDK 的自定义智能体支持和 skill 加载很契合这个模式。当然,只要能把内容清晰地送达智能体,你用任何方式实现都行。我喜欢 skill,因为开发者在本地也能复用它们——尤其是项目特定的 skill,很容易在审查智能体和人类开发者之间共享。
对任何自动化来说,最终输出都应该是结构化的、易于机器读取,以便进一步处理。
11、审查会越来越啰嗦
我确实注意到的一点是:审查智能体很快就会变得啰嗦。 当前模型能产出有用的输出,但它们也很乐意产出一大堆。没有格式和严重性约束的话,你很容易得到一堆技术上没错、但可能是吹毛求疵或根本不值得卡住 PR 的评论。
如果你设置了分支策略、要求所有评论都必须处理完才能完成 PR 合并,这很快就会变成开发者的负担。
这就是我越来越倾向于加显式严重性等级的原因。这样你还可以过滤掉低严重性的发现,甚至自动把它们作为评论贴到 PR 上而不标记为审查问题,或者合并成一条评论。更好的是,也许你还可以根据严重性排序和修复复杂度,自动启动任务去修那些较小的问题。
有趣的问题是:哪些类别的发现可以安全地自动修复? 这时它就从"审查机器人"变成了更通用的自动化系统。要让它好好工作,智能体多半需要编辑代码、运行测试和校验,并确认修复真的生效了。完全做得到,但这意味着架构中隔离、权限和验证这一侧变得更加重要。
12、同一架构也能驱动 fix 命令
我还有一个 fix 命令,结构基本相同。触发方式和提示词不同,但架构几乎一模一样。系统接收一个事件或命令(比如一条写着 "/fix HOW TO FIX THIS" 的评论),收集仓库、PR 和评论线程上下文,启动一次隔离运行,让编码智能体执行一个有边界的任务,然后返回带后续动作的结构化结果,比如创建 PR 或提交修复。
一旦你把管理器、状态、隔离执行和源系统回调流程跑通,就能把它复用到一大堆相邻的自动化上。
13、同一 harness 上的本地与远程
我觉得真正有价值的一点是:把这些自动化构建在你本地也在用的同一套 harness 之上,比如 OpenCode。如果同一组智能体、skills、指令和工具配置在本地开发中也能用,你会得到一些很好的性质:代码还没进 PR 就有更快的反馈、自动化本身更容易调试、开发期间可以把审查专项作为子智能体复用,本地与服务端 AI 工作流之间的漂移也更小。 这也会带来取舍。适合本地交互使用的结构,未必就是远程 webhook 驱动的自动化想要的。如果两者都要,你就得思考如何组织提示词、skills、状态和配置,让它们同时适配两种场景。
14、这一模式可以泛化
这个模式不是 PR 审查特有的。只要自动化有明确的触发事件、一段有边界的推理工作、以及要返回的结构化结果,它在任何地方都好用。
这就是为什么我越来越把这些自动化看作普通的事件驱动系统,只不过流水线的其中一个阶段里放了个 LLM。任务范围收得越紧,模型周围的一切就应该越确定。
15、结束语
如果要把整件事压缩成一句话:把它建成一个普通的事件驱动系统,让代码拥有工作流。让模型拥有审查判断,而不是流程。用编码 harness,让智能体能真正检查真实的仓库。返回结构化发现,而不只是散文。并尽可能让任务有边界、可确定。
最重要的设计选择,往往不是你用哪个模型,而是你拒绝交出多少控制流。
原文链接: Building your own PR reviewer with coding agents
汇智网翻译整理,转载请标明出处