数据科学没死
AI 几秒钟就能生成代码。这改变了"会写代码"意味着什么,但并没有让这门知识过时。那么,还剩下什么……
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
智能体编程(Agentic coding)如今不需要开发者或数据科学家也能产出可运行的代码。在本文中,我会把这句话拆解成领域的方方面面来谈。
首先是对 Vibe coding 的现实核查:它是进入数据科学领域的捷径,还是让那些从未弄懂自己到底发布了什么的人掉进去的陷阱?
接着认真审视 为什么 AI 产品依然这么难做,即便工具更好、有了智能体编程也一样。由此出发,我会讨论 负责任 AI(responsible AI) 的支柱,并重新思考"不理解模型如何工作就部署模型"意味着什么。
最后是没人愿意大声问出口的尴尬问题:ROC 曲线和相关性能度量去哪了,以及为什么"看起来还行"已经悄然取代了它。问题不在于数据科学家是否依然被需要,而在于——当我们身处一个智能体编程几秒钟就能产出可运行脚本的环境中——其中哪些部分仍然值得学习。
1、"智能"软件的陷阱
作为数据科学家,我们过去用定制训练的模型构建应用,让它做预测和推理。我们可以冻结 Python 依赖包、离线运行应用,一切尽在掌控。今天,我们构建应用快得多,但代价是:流水线里的 LLM 或许带来便利,代价是我们正在变得依赖它所需要的服务。
产品越"智能",我们就越依赖,因为逻辑被转移到了外部方。
这种依赖和我们习以为常的那种不同。它不是安静地躺在 requirements.txt 里的依赖。它活在应用之外,活在 OpenAI、Anthropic、xAI 等公司里,而我们控制不了它。如果 API 变了、不可用了,或者某个模型停用了,软件就得跟着变。
突然之间,我们曾经自给自足的软件,依赖上了一项服务、一家公司、它的基础设施和它的商业决策。而事情到这里才更有意思。LLM 不再只是成为我们所构建软件内部的依赖,它们正在成为我们构建软件这种方式本身的依赖。Vibe coding 在这里是重要的一环。让我们进入下一节讨论这个话题。
2、Vibe Coding 是入行捷径,还是陷阱?
"这是 vibe coded 的。" 几年前我根本猜不出这句话的意思。今天的新问题是:到 2026 年,还值得好好学编程吗? 这是个公平的问题,它值得一个真正的回答,而不是一句情绪化的断言。
2026 年真实发生的情况是这样的:开发者对 AI 辅助编程的采用已接近普及,绝大多数专业开发者都在以某种形式使用它。资深工程师——那些本来就会读代码、评代码的人——报告了巨大的生产力提升。这一部分的故事是真的。
但宣传里被略掉的是这一部分。 CodeRabbit 对数百个开源 pull request 的分析发现,AI 参与编写的代码明显比人类手写的代码带来更多严重问题,包括更高的安全漏洞率 [1, 2]。arXiv 上的这篇文章也得出了类似结果 [3]。代码颠簸(code churn)在上升。重构——那种真正改进代码库的不起眼的工作——多年来在变更中的占比一直在缩小。
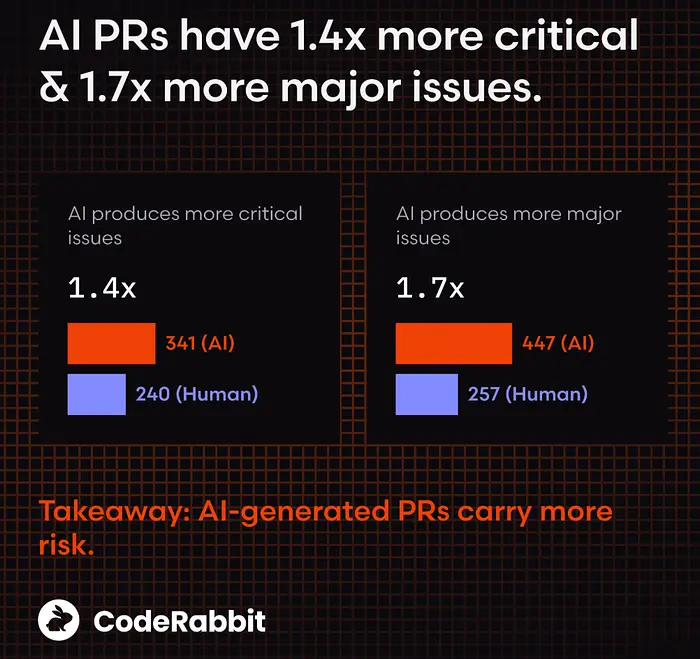
AI 能写出可运行的代码。但可运行的代码不一定是好代码。
这些都不意味着工具没用。它意味着*"能跑的代码"和"真正站得住的代码"之间的鸿沟没有消失,而是转移了。它过去横亘在初级开发者和资深开发者之间。现在,它横亘在"理解模型输出的人"和"仅仅因为能跑*就接受代码的人"之间。
一个曾经需要数年才会腐烂的代码库,现在几周就能劣化。
这正是为什么:对新人来说,基础现在比以往更重要,而不是更不重要。 如果你解释不清一段生成的代码为什么能工作,你就抓不出它错在哪,当经理追问时你更没法为它辩护。在这种环境里表现最好的工程师,不是打 prompt 打得最快的那些人,而是先花时间弄明白"好代码长什么样"的人——于是 AI 成了倍增器,而不是拐杖。
所以,vibe coding 不是一份职业。 *它是一种奖励"本就看得懂的人"、并悄悄惩罚"看不懂的人"的工具。*先学基础。 等你有办法检验 AI 的产出时,再用它提速。构建可持续的 AI 产品依然很难,而写代码从来就不是问题所在。下一节我们深入探讨:构建可持续产品,什么才重要。
3、构建可持续的 AI 产品依然很难
大多数公司现在都有数据团队,但这依然挡不住大多数数据科学项目在上线前悄悄死掉。真要说变化,内耗似乎更严重了:你今天微调的模型,几周内就可能被超越或超出预算。以下几件事依然坚如磐石,能让项目在真实世界里活下来:
1:它是业务问题,先于技术问题。 学会写干净、有文档、可测试的代码;这部分从来不是可选项。但更难的技能是:在你碰模型之前,先理解业务真正需要什么。从你能构建的最小的东西开始,去验证这个想法是否值得做,而不是堆一堆没有价值的"最技术"的东西。
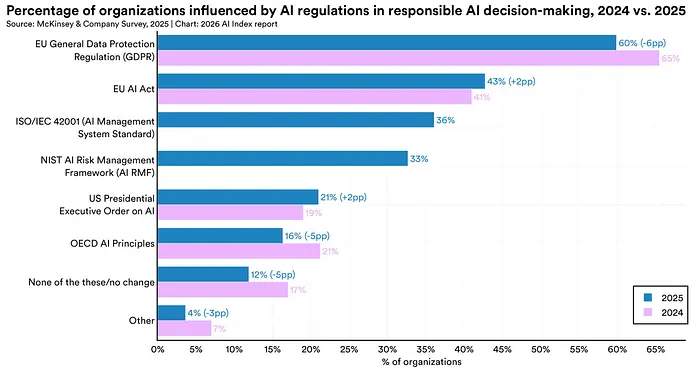
2:负责任 AI 现在有了真正的强制力。 几年前,负责任 AI 基本上只意味着好意。随着 AI 法规落地、AI 规则进入执法阶段,责任现在有了牙齿。这改变了一个项目中 "完成" 的样貌。
3:管理技术债务,现在还有模型债务。 代码债务本已昂贵。现在你还要继承模型本身的债务:对厂商 API 的依赖、悄悄退化的微调、底层模型毫无预警更新后就崩掉的提示词。
4:不是所有问题都需要模型。 有些问题只需要简单逻辑。有些用例需要的是统计检验。只有少数用例真正需要机器学习。伸手去拿最花哨的现成工具不是本事;选对工具才是。
4、负责任 AI 的六个部分
几年前,我写过一篇关于负责任 AI 及其六大支柱的完整文章。结论依然没变;负责任 AI 不是一张打一次勾就完事的清单。它是你在整个项目中持续做出的决策。 过去几年改变的不是结构,而是谁在做这些决策。以前,责任主要落在一小群训练有素、构建模型的数据科学家身上。现在,任何拥有聊天窗口和 API key 的人都在其中。 正是这一转变,让这六个部分现在更加重要,而非更不重要:工具变得更好用了,但草率使用它们的后果并没有缩小。 让我们逐一过一遍负责任 AI 的六大支柱。更多细节参见下面这篇关于负责任 AI 的文章。
The Next Step is Responsible AI, but How Do We Get There?
隐私(Privacy)。 这始终是第一个问题,你需要在写第一行代码之前就想清楚。个人数据、政治或宗教倾向、车牌或设备指纹这类间接标识符,整个项目及其之后都需要被保护。问题不只是"我们能用这些数据吗,"而是你是否审视过它的影响,并确认它只用于被验证过的那个任务。尽早问:GDPR(或其地区等效法规)适用吗?对的人——隐私官、信息安全负责人——真的在流程里吗?你又如何处理输入数据里固化的偏差?
治理(Governance)。 需要有一个人对数据负责,另外还需要有一个人对模型负责。一个构建良好、合规的模型,如果下游喂错了输入——没人标记的缺失值、错位的特征顺序、悄悄改变的 schema——照样产出垃圾。治理就是在问题到达决策者之前把它拦住。要有一个对输入和输出都进行合规性测试的流程,而且在部署前就达成一致,而不是出了问题再临时应对。
输入质量。 好的数据质量听起来理所当然,得到的关注却远少于它应得的。先从宏观看:数据是怎么收集的?收集过程随时间变过吗?怎么标注的?到底什么影响它的质量?然后进入技术层面:检查缺失值的分布、找重复、分别检查类别特征和连续特征,再看它们之间的相关性。在你开始预处理之前,先判断这个任务用手上的数据是否可行——因为预处理意味着你已经足够信任数据、可以去塑造它了。
输出质量。 高质量的输入和训练良好的模型,仍可能产出没人能用的输出。一个卫星图像模型可以在测试中得分漂亮,然后每个冬天悄悄退化,因为云层遮住了传感器——一个完全可预测、却没人想到要监控的故障。真正的问题不只是模型管不管用,而是它什么时候管用。 输出需要和生产环境中的其他任何东西一样接受持续监控,而不是一次性验证了事。
模型质量。 这分为四块:准确性(只有事先定义了验收标准它才有意义;一个分数本身不构成决策)、可靠性与可复现性(你能否用相同的数据、超参数和随机种子重建模型,它在正确的训练/测试/验证划分下是否依然成立),以及可解释性(你和利益相关方能否真正说出模型为什么做出那个决定,文档清晰到别人也能跟得上)。这些没有一项是新要求。 它们和过去的要求一模一样,只是现在更难跳过——因为越来越多的人在没有相关背景、不知道它们有多重要的情况下就发布了模型。
伦理(Ethics)。 它贯穿以上五者,而不是与它们并列。意识、正直、对受模型影响的人保持透明——尤其是关于它的局限——不是单独的勾选项。它是把其他五者串联起来的那根线。
斯坦福和麦肯锡研究了这六个部分的影响,结论是它们彼此绑定;优化其中一个,可能拉低另一个。下一节,我们来看看其中有趣的洞见。
5、责任伴随着权衡
人们很容易把隐私、公平性和可解释性当作六个可以独立勾选的框,但近期研究得出了相反的结论。这六个部分彼此拉扯。斯坦福报告 [4, 5] 描述了两个清晰的观察:
斯坦福 2026 AI Index 引用的一项研究显示,加入差分隐私保护(防止单个数据点被识别的标准技术)后,隐私得分全面提高。这很好,但它让模型准确性下降了 33 个百分点,也让模型更难解释。
另一个类似例子来自一项医疗领域的联邦学习研究。同样的隐私技术让阿尔茨海默病检测的诊断准确率下降了近 15 个百分点,而且损失最惨重的是数据集最小的医院——恰恰是最没有能力消化这种损失的机构。
目前还没有框架能干净地驾驭这些权衡。 现在有的,是一种义务:在你拼命优化六者之一、悄悄打破另一个之前,先知道它们的存在。
同样值得坦诚的是,大多数组织还没走到那一步。 斯坦福 AI Index 调查发现,负责任 AI 的平均成熟度得分为 4 分制的 2.3 分,意味着大多数公司仍在整合实践,而非全面运转。他们观察到,被引用最多的障碍不是预算或领导力;而是知识缺口,占比高达 59%。
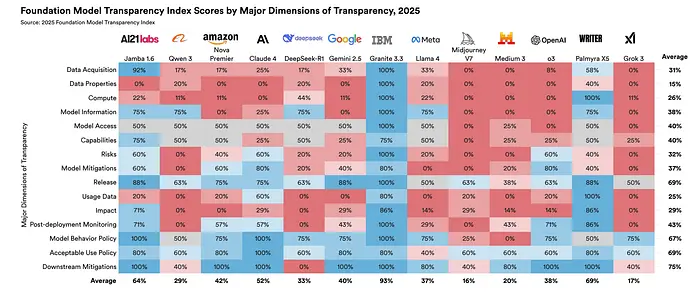
与此同时,透明度正在朝错误的方向走:所谓的基础模型透明度指数(对开发者在训练数据、算力和部署后影响方面的披露进行打分)从 2024 年的平均 58 分跌到了 2025 年的 40 分。
6、ROC 曲线去哪了?
有件事困扰我一段时间了,我想我不是唯一一个。过去,发布模型是有一套纪律的。任何东西触碰生产环境之前,你会有混淆矩阵、ROC 曲线、按类别拆分的精确率和召回率、特异度、F1 分数,全部对照模型训练之前就达成一致的验收标准来衡量。数字不达标,模型就不上线。这就是工作本身。
过去几年里的某个时候,这套纪律的很大一部分似乎悄悄消失了。不是因为它不再重要,而是因为干活的模型变了形态,而评估习惯从未跟上。从实际角度我完全理解为什么会这样。评估 LLM 确实比评估分类器难。 欺诈模型给你一个标签和一个可以对照的真值。LLM 给你一段话。没有唯一的正确答案可供比较,没有干净的混淆矩阵,没有明显的方法去计算一个聊天机器人回复的特异度。这是真实的、结构性的困难,不是懒惰。但不知从哪一步起,"这很难衡量"悄悄变成了"我们不再衡量了,"而这两件事不是一回事。
斯坦福 2026 AI 报告 [3, 4] 称,几乎每一家前沿实验室都在 MMLU、SWE-bench 这类能力基准上报告结果,相当于炫耀"车能跑多快"。这很好,但到了负责任 AI 基准——那些能告诉你模型多常撒谎、在对抗压力下多安全、当有人真的想攻破它时它扛不扛得住的基准——那张表基本是空的。在被追踪的主要前沿模型中,只有一款在超过两个负责任 AI 基准上报告了结果。只有一款报告了越狱抵抗基准。也许这是一种报告选择,也许它难以衡量,又或者这些基准只在内部打分,没有使用一套公共的、可外部比较的基准来公开披露。
LLM 不会大声失败;它们悄悄失败。
结果是一种奇怪的双重标准。那些没有记录在案的 F1 分数就绝不会发布模型的团队,现在凭"我试了几次,看起来还行,"*就把基于 LLM 的系统——支持路由、内容分类器、分诊工具——推上了生产。一份评估指南在报告里说得直白:*LLM 不会大声失败;它们悄悄失败。
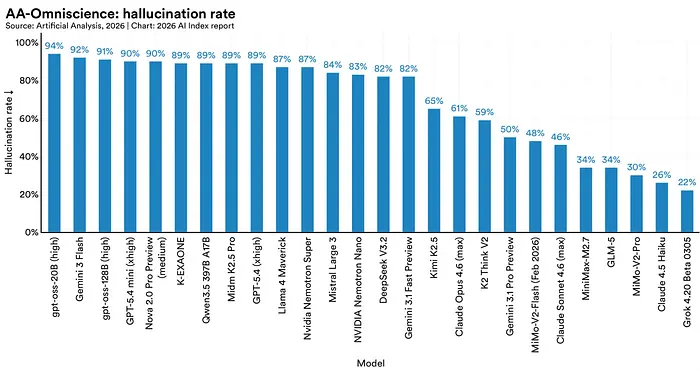
一个坏掉的 API 会抛出你不可能错过的异常。一个行为失常的 LLM 给你的却是自信、语法完美、却完全错误的回答,而下游不会标记它——除非有人为语言构建了混淆矩阵那样的东西。这个鸿沟的规模比我想象的更大。一个叫 AA-Omniscience 的新基准显示了 26 个领先模型在同一任务上的幻觉率。分数从 22% 一直到 94%。这就是"你能向监管机构辩护的系统"和"你无法辩护的系统"之间的差别。
报告里还列了更多基准。其中一个叫 KaBLE,测试模型能否区分"真的为真"和"用户仅仅相信其为真"。如果你在总结法律证词或辅助医疗诊断,这个区分很重要。 GPT-4o 在直白的真陈述上取得 98.2% 的准确率 [6]。让它处理一个以用户自身信念形式呈现的错误信念——正是支持机器人或助手需要温和纠正别人的那种场景——它的准确率暴跌到 64.4% [6]。DeepSeek R1 在同一测试上从 90% 以上跌到 14.4% [6]。两个模型在日常使用中都看起来没坏。你只有用专门构建的探测测试才能抓到它,而这恰恰是执行得不够频繁的那类测试。
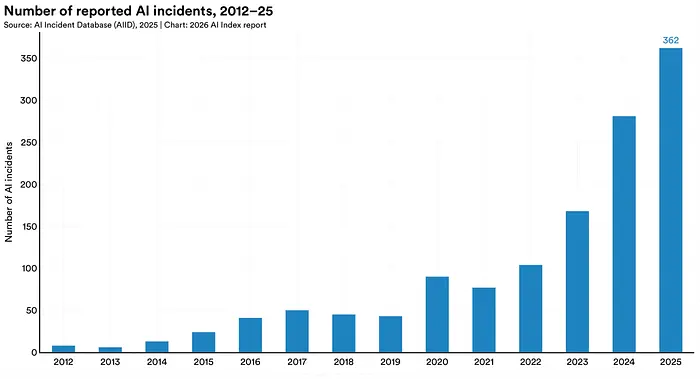
与此同时,有记录的真实 AI 事件(已部署系统造成或差点造成伤害的案例)在 2025 年跃升至 362 起,前一年是 233 起。注意 2022 年这个数字还不到 100(见下图)。这是一个朝错误方向走的趋势。我们的纪律本该在部署前抓住这些问题才对。然而它似乎正在悄悄消失。
这正是上一节的六大支柱不是可选项的原因。 模型质量依然有意义。只是它意味着衡量不同的东西:groundedness(答案是否真的紧扣你给的素材,还是跑偏了)、faithfulness、对照已知答案集的幻觉率、如果你做 RAG 还有检索精确率,以及——是的——只要任务真的有可核对的正确答案,就用朴素的准确率。这些都不再稀奇;如今已有真实的工具生态专门为它们而建,但"愿意上手用它们"仍然是大多团队没有做出的选择。
7、数据驱动的解决方案
如果你的问题确实需要模型,大多数表格类业务问题用 XGBoost 这样的树方法依然解决得很好,而不是靠一个带系统提示词的基础模型。那些自动化了繁琐环节的库——正确切分数据、在不过拟合的情况下调超参数——依然物有所值。这依然是大量生产级数据科学的可靠支柱,而且它哪也不会去。
pip install hgboost

# Import library
from hgboost import hgboost

# Initialize
hgb = hgboost()
results = hgb.xgboost(X, y, pos_label='yes')
hgb.plot()
8、结束语
数据科学活得好好的,而这其中没有任何一条意味着 vibe coding 单靠自己就能让你拿到 offer。当下为真的是工具之下一直为真的东西:先理解业务问题,能用简单逻辑或统计就用,知道什么时候模型是错误的答案,认真对待责任——因为现在真的有人能追究你了,即使衡量变难了也要衡量你发布的东西,并培养那种能抓住 AI 错在哪的判断力,而不是闭眼发布。伸手去拿最花哨的现成工具不是本事;选对工具才是。
先学基础,再学捷径。捷径年年变,判断力不会。希望对你有帮助。
原文链接: Data Science Isn't Dead, Vibe Coding Isn't a Career: A Reality Check for 2026.
汇智网翻译整理,转载请标明出处