面向数据工程师的变更数据捕获
本文我们讨论了变更数据捕获的动机、如何实现,以及它的挑战。
变更数据捕获(Change Data Capture,CDC)这个词,你找不到是谁、在什么时候创造的——不像"湖仓(lakehouse)""数据湖"或"数据仓库"。
它更像是一种行业标准的数据集成设计模式。
我只知道 CDC 已经存在很久了,支撑着许多公司的数据架构——无论是操作型的还是分析型的。
——
这周,一起来了解 CDC。
1、动机
CDC 是这样一个过程:跟踪并提取源数据库中的数据变更(INSERT、UPDATE 和 DELETE 操作),然后把这些变更投递给任何需要它们的系统。
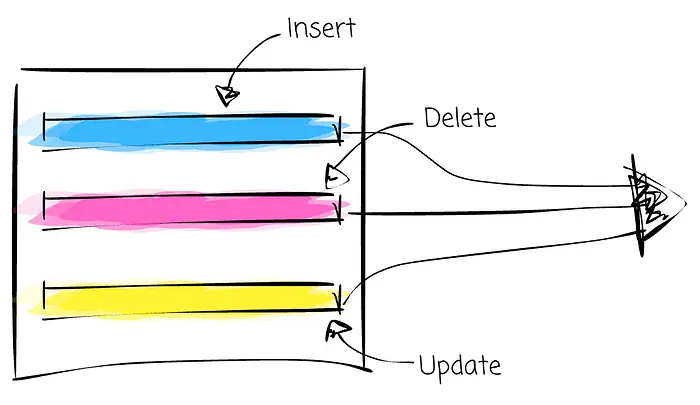
它不是扫描整张表来发现变更,而是借助机制(后文会讲)帮助系统跟踪"增量",也就是表的增量变化。
这些"增量"随后以批处理或流的形式投递给下游。
源里发生了变化,另一处需要知道。这就是 CDC 的全部要义。
——
我过去以为 CDC 是数据工程专属的技术。
操作型数据库几十年来一直在对自己做这件事。
MySQL 或 PostgreSQL 的主实例接收写入,许多副本服务读取。只读副本不会每次需要同步时都去敲主库的门、求它导出数据。
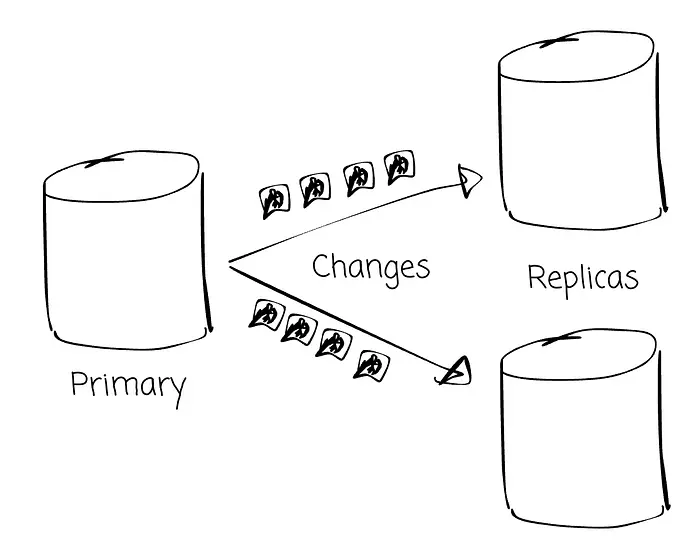
相反,它读取主库的事务日志(MySQL 的 binlog 或 PostgreSQL 的 WAL),并严格按照事务顺序重放每一个变更。
PostgreSQL 的 WAL
这基本上就是 CDC。只是数据库不这么叫它。
这个模式也被用在很多地方:缓存失效、搜索索引,或跨区域同步。
——
分析型用例是后来才出现的。
想象一下,你公司有一个支撑公司应用的 PostgreSQL 数据库。
作为数据工程师,你得从数据库中抽取数据,然后在 BigQuery 中加载和处理。
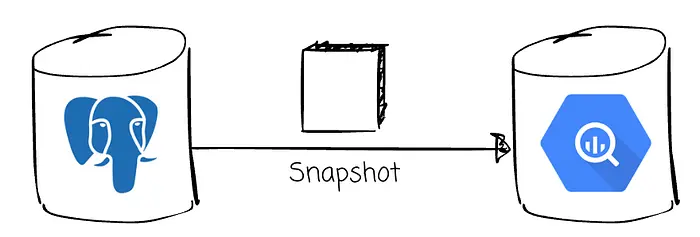
最直接的做法是请软件工程师给你数据库访问权限,这样你就能导出一份快照、落到对象存储,之后再加载进 BigQuery。
然而,用例在演化:
- 公司应用增长带来更多数据;快照导出过程越来越慢
- 导出过程现在要和数据库的主业务争抢资源
- 终端用户要求更低延迟。他们无法容忍两次快照导出之间的延迟。
——
在这种情况下,CDC 能帮到我们。
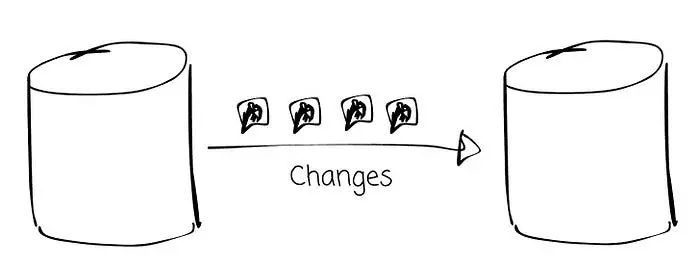
源里有东西变了,另一处需要知道。这就像数据库复制,只不过不是从 PostgreSQL 到 PostgreSQL,而是从 PostgreSQL 到你偏好的 OLAP 系统。
2、实现
实现 CDC 的方式有很多;它们在如何捕获变更、以及变更以何种形态(批处理或流)呈现上有所不同。
——
第一种方法是周期性执行 SQL 查询,检查自上次运行以来发生变化的记录。它通常依赖源表中的一个专用列,比如 updated_timestamp。
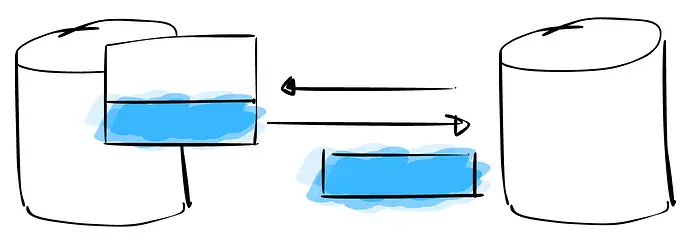
CDC 进程维护一个"检查点"(上次运行的时间戳),查询所有时间戳大于该检查点的行。然后更新检查点供下次运行使用,如此往复。
若 updated_timestamp > checkpoint → 有变更
这是最容易实现的方法,但有一些缺点:
- 它无法跟踪删除。因为它依赖查询结果,而被删除的行不会出现在结果里
- 它会压垮源。频繁扫描会抬高源的资源占用。如果两次运行之间变更巨大,源就必须处理大量数据。
- 延迟:数据的新鲜度取决于轮询间隔
这种方法叫做基于查询的 CDC(Query-Based CDC)。
——
下一种方法依赖数据库触发器;在后台运行的存储过程用于捕获表上特定的数据修改事件。对于 CDC,会在源表上创建 INSERT、UPDATE 和 DELETE 触发器
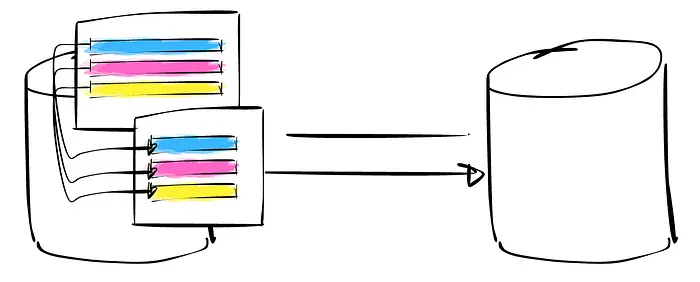
当变更发生时,关联的触发器被触发,把该变更的记录写入同一数据库中的另一张表。CDC 进程周期性地从影子表读取新条目来捕获变更。
现在,删除可以被跟踪了,但局限依然存在:
- 性能影响:对该表的每一笔事务都会带来额外的写入(写入变更表)
- 延迟依然存在:CDC 进程必须周期性地读取变更表
- 管理大量触发器可能变得复杂
这种方法叫做基于触发器的 CDC(Trigger-Based CDC)。
——
下一种方法是目前最常见的。
它直接从数据库的事务"日志"中读取变更。
具体实现因数据库而异。不过高层思路是一样的。
当一个进程要处理数据时,它把数据带进内存,在那里修改,最终写回磁盘。但内存是易失的;如果机器在刷盘之前崩溃,变更就没了。
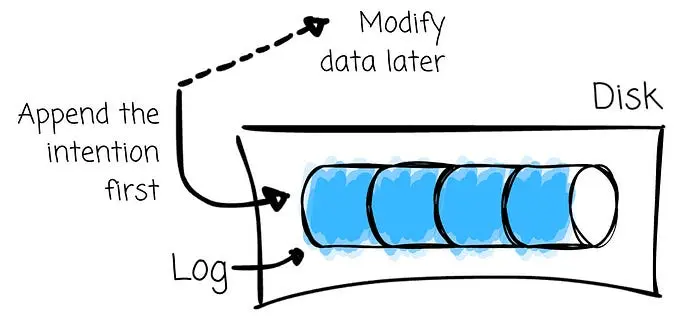
为防止这种情况,大多数 OLTP 数据库会强制写入方把他们的"意图"写进日志(MySQL 的 binlog 或 PostgreSQL 的 WAL)。
日志是磁盘上的一种追加结构,实时记录每一次变更。
如果机器在 RAM 中的修改数据到达磁盘之前挂掉,数据库会重放日志、重建该变更。
——
对 CDC 而言,日志从恢复工具变成了可靠的变更来源。从高层看,CDC 进程把变更从日志流式传输到 OLAP 系统。不再查询任何表。
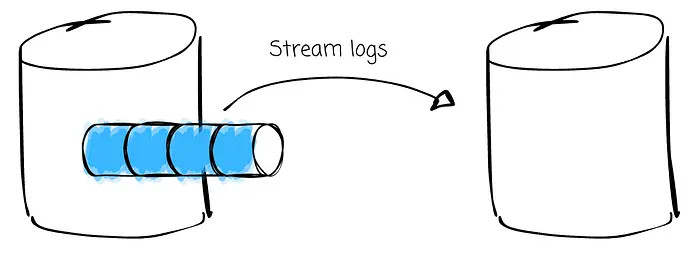
与批处理方式相比,基于日志的 CDC 有一些优势:
- 性能影响极小:这是它最大的优势。因为它读取日志文件而不是执行查询,基于日志的 CDC 能以极小的性能开销实现持续的变更捕获。
- 完整性:"日志"是所有数据修改的终极事实来源。
- 低延迟:变更一提交进日志就流式传出,这种方法把近实时的变更投递给下游。
正因如此,基于日志的 CDC 是当今最常见的方案。不过这种方法实现起来相当复杂:启用逻辑复制、为 CDC 进程授予权限,以及吸收这条流的基础设施(例如 Kafka,甚至用 Flink 来处理变更)
在本文余下部分,我们将只聚焦基于日志的 CDC。
——
我们将多花一点时间来看一条典型的基于日志的 CDC 流水线:
从高层看,它大致是这样的:
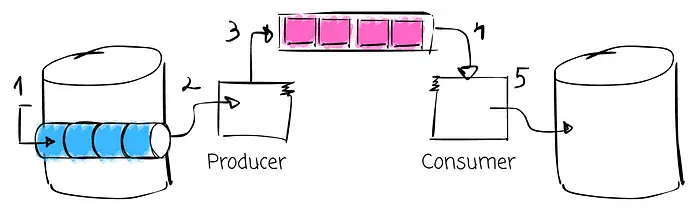
- 源数据库中的变更:当用户向数据库(如 PostgreSQL、MySQL)提交一笔事务(
INSERT、UPDATE或DELETE)时,过程开始。 - 事务日志写入:数据库在把变更应用到数据文件之前,先把该事务的记录写入事务日志。
- 日志读取器:流水线的一个组件读取该日志。它持续监控新的日志记录。
- 日志发布器:这个组件会把新的日志记录发布到消息系统。同样,你几乎不会从零构建这个实例。CDC 连接器也会处理这项任务。
Debezium Connector For PostgreSQL
- 吸收日志流:消息系统(如 Apache Kafka)随后吸收这些日志记录。这一步确保日志可靠投递。它还把日志发布者和日志消费者解耦,让双方各按自己的节奏运转。
例如,源每分钟可能产生几百条变更,但消费者无需跟上这个速率,因为它只需要最近 1 小时内的变更)
- 下游消费者:下游系统和应用订阅消息系统,从那里读取变更事件,并按各自的需求处理
接下来我们讲挑战。如前所述,我们只聚焦基于日志的方法。
3、运维
出于其健壮性,基于日志的 CDC 要正确搭建并不简单。
首先,你得为端到端流水线管理多个软件组件:日志读取器/发布器、消息系统、流处理引擎(可选)和消费者。
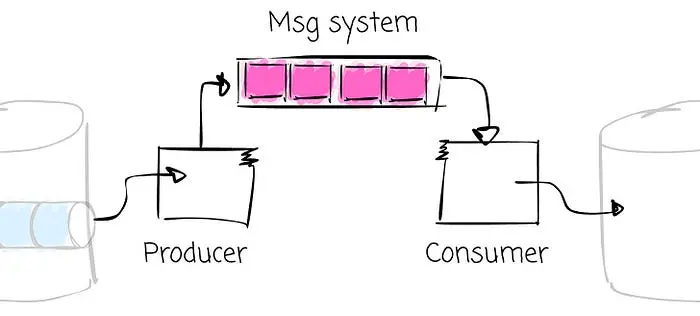
与定期把数据导出到对象存储相比,这可多了不少。
如前所述,你很少需要事事亲力亲为;CDC 连接器可以抽象掉部分复杂性。
不过,你仍然需要仔细配置、扩展和监控每一个组件。
——
接下来是权限授予。
日志读取器/发布器必须拥有读取数据库变更日志的正确权限。
权限缺失一开始会让你很头疼。(我踩过这个坑)
——
偏移量(offset)管理也是需要记在心上的事。流水线失败后,它应该从日志变更的哪个位置重置?
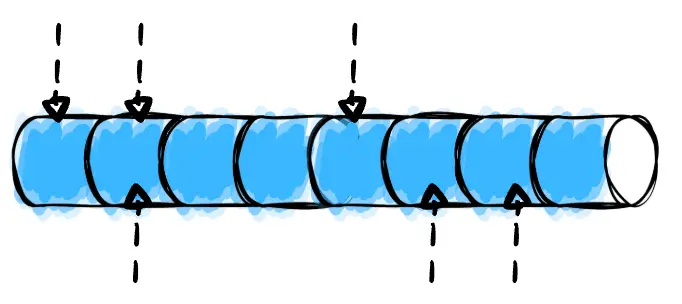
同样,CDC 连接器会替你处理这件事,但你仍需了解它,因为它对整条流水线的正确性起着关键作用。
重跑结果之间的偏移量间隙会导致数据丢失,而重复消费已经处理过的偏移量则会导致数据重复。
——
引导(bootstrapping)也是个问题。
CDC 捕获的是变更。
但这些变更必须应用到"基线"状态上才有意义。
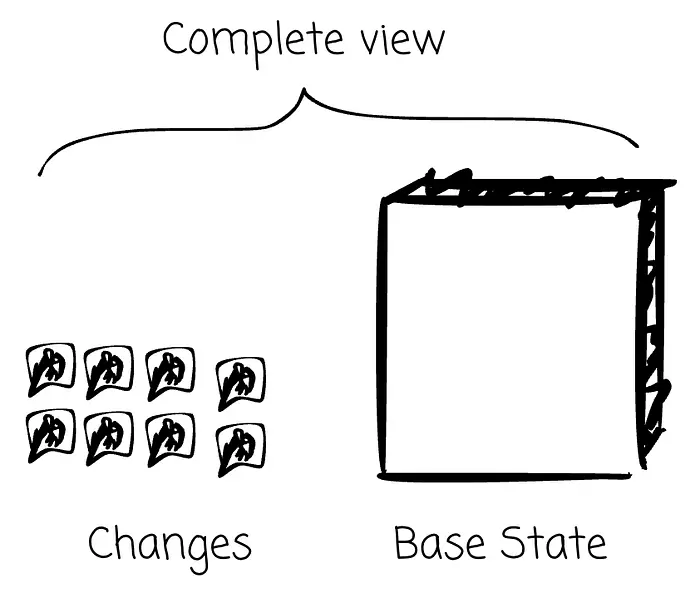
目标端必须与 CDC 开始时源表的状态一致。
为此,你必须把日志变更从最初一直流到 CDC 即将开始的那个时点。
或者,你把那张表的快照导出一次,加载到目标端,然后从那里启动 CDC。
鉴于导出基线状态是一次性的,它通常是引导的常见做法。
——
有人在源表里加了一列。
有人重命名了一列,或修改了它的类型。
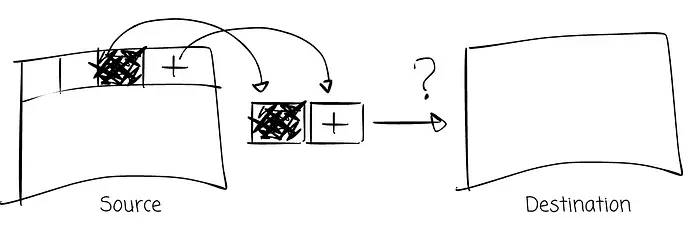
通常,基于日志的 CDC 流水线能够捕获这些 schema 演变事件。
但如何把它们应用到目标端,100% 由你决定。
Schema 演变是数据搬运中的经典问题,无论是传统 ETL 还是 CDC。
——
最后,你得决定何时把"变更"合并进"基线状态"。基线状态与变更 T 合并之后,会得到一个新的基线状态。
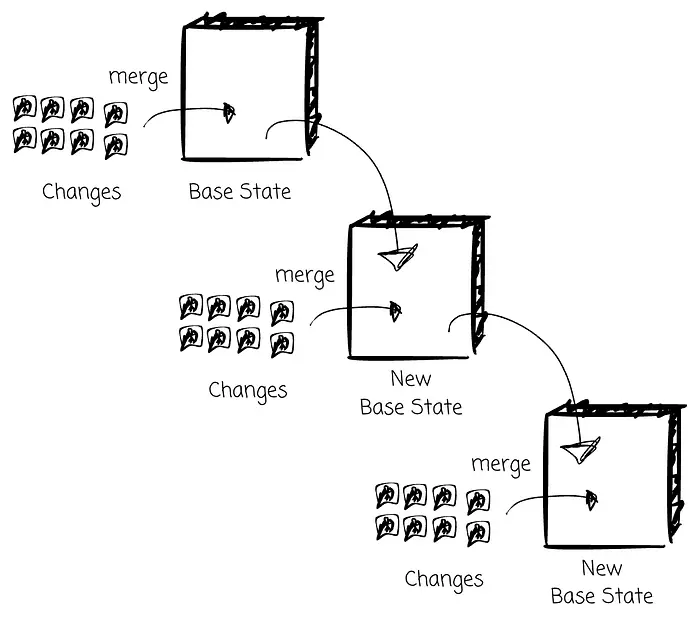
当变更 T+1 到来时,又必须再做一次合并,产生新的基线状态。理论上,这个过程会永远进行下去。
你得决定 T 与 T+1 两次合并之间的间隔。
如果合并太频繁,延迟更低,但计算资源花费更高。
如果合并不那么频繁,计算资源花费更低,但延迟更高。
4、CDC 是一条流
而流式写入在湖仓(lakehouse)里是个问题。
像 Iceberg 或 Delta Lake 这样的开放表格式,最初是为批处理工作负载设计的。
当一个进程向湖仓写入数据时,它必须在其上创建相关的元数据。
一个数据文件对应一份事务日志(Delta Lake),或者三份元数据(Iceberg),然后最终提交。这些表格式依赖元数据来保证 ACID、schema 演变、查询优化或时间旅行。
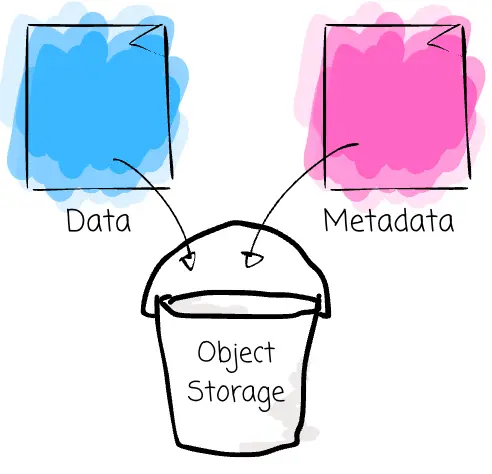
每一次元数据写入都是一次对象存储请求。
这样的开销在批处理工作负载中是可以接受的,毕竟有它的收益。
然而在流式场景下——小数据量、频繁写入才是常态——就不行了。提交过程会给每次写入请求增加延迟。流式写入频繁发生时,开销会不断累积。
——
"小数据 + 频繁写入"的另一个问题是它会产生大量小文件。
小文件会降低读取性能。每次读取文件都需要一次对象存储调用来打开、读取、关闭。文件一多,开销就累积起来了。
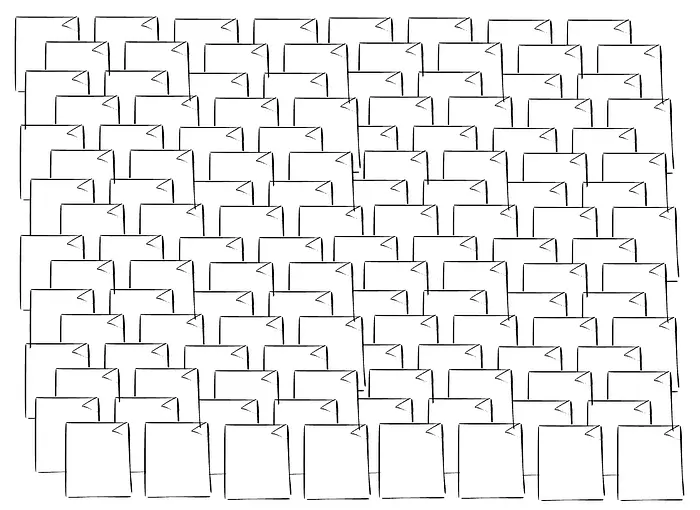
你可以在写入湖仓之前先批量攒数据来增大文件体积,但这会增加延迟。
开放表格式依赖 compaction(压实)把小文件合并成大文件。这种压实操作在后台异步进行,需要仔细配置和监控,因为它消耗大量资源,可能与表的读写操作争抢资源。
——
如果你用的是 BigQuery 或 Snowflake 这类数仓方案,基本不用担心这些,因为厂商在幕后把一切都管理好了。
但如果公司选择了湖仓,那么在部署 CDC 流水线(或任何流式用例)时,你必须把这些因素记在心里
5、结束语
本文我们讨论了变更数据捕获的动机、如何实现,以及它的挑战。
与传统 ETL 方式相比,CDC——更具体地说,基于日志的方式——是一种非常不同的范式,因为我们面对的是流而不是批。
对付流,总是很难。
原文链接: Change Data Capture (CDC) for Data Engineers
汇智网翻译整理,转载请标明出处
这是「RAG / 数据 / 文档智能」专题的一部分。完整地图见:RAG / 数据 / 文档智能完全指南