9.6 亿行,一台笔记本:多 Agent 答错率从 47% 降到 9.8%
没有 GPU,一个 28.6 GB 的 DuckDB 文件装 9.6 亿行。12 次改动回退 4 次:准确率 66.7%→90.9%,答错率 47.1%→9.8%,中位数 3.8 秒。
959,031,513 行。一台 16 核笔记本,31.4 GiB 内存,没有 GPU,全部数据就是一个 28.6 GB 的 DuckDB 文件。
在这个配置上做一个 Text-to-SQL 的 Agent,前后动了 12 次,回退 4 次。留出的 194 道测试题上,日常问题正确率从 66.7% 到 90.9%;已经作答的答案里,错的比例从 47.1% 降到 9.8%;同一台机器上秒表实测,中位数 3.82 秒。
第二个数字更值得看。一个会崩的系统至少还会报错,而 47.1% 那批答案是 SQL 跑通了、有数、数错了,一句提示都没有。财务拿着这样的结果签字,风险不来自宕机,来自"看起来没问题"。
作者是 Fareed Khan(Level Up Coding,2026-10-26,原文 38 分钟读完)。下面按他的顺序走:先量失败,再造尺子,然后一道一道墙地改,每一处都带一个"为什么留下它"的数字。
四道要求,同时压在一个 Agent 上
企业的业务用户已经开始直接问数据仓库,而不是提交一张需求单。这样做的 Agent 同时背四个指标:
- 准确:财务签得下字。
- 可控:只能碰被允许的那部分数据。
- 够快:几亿行的表也能问。
- 时间可接受:人愿意等。
原型的通病是四个一起丢:数据一大,四个指标一起往下掉,而且掉的时候不报警。
作者把目标写在动手之前,理由是"看过结果再定目标,目标会漂向系统现在的水平"。四个目标在 config.py 的 TARGETS 里:
- 日常问题正确率 ≥ 90%。
- 假成功(已作答里答错的比例)≤ 5%,必须和"作答率"一起报——一个什么都不答的系统,永远不会答错。
- 中位数回答时间 ≤ 5 秒。
- p95 ≤ 15 秒。
先量失败:四个漏水点
教程里那个最朴素的 Agent,在 102 道练习题上答错 29 道,还答了 15 道本该拒绝的问题,二十次里有一次的耗时超过 26 秒。
把每个失败按原因归类,落在四个互不重叠的漏点上(下图右下的四个红框):
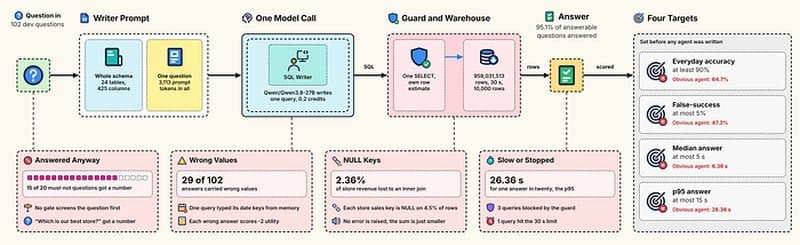
- 该拒没拒:20 道"不该给数"的问题里,15 道拿到一个数字。第一道闸根本没有。像"我们最好的门店是哪家"这种问题,在"最好"没定义之前无解,Agent 自己选了净利润,然后给了个数字,没说它做了这个选择。
- 值算错了:102 道作答里有 29 道数值是错的。有一道官方查询,模型凭记忆敲了日期键,本该去 join 日期表——100 行结果全错。
- NULL 键:
store_sales的销售键有 4.5% 的行是 NULL,inner join 静默丢掉它们,2.36% 的门店营收就这么蒸发了。 - 慢与卡死:p95 是 26.36 秒。
前两类失败一个错误都不抛。这决定了整篇文章的方法:靠日志和异常是看不见这些的,必须有一把能判对错的尺子。
9.6 亿行装进 28.6 GB
工具链刻意保持很短:DuckDB 跑在自己的 Python 进程里,不用装数据库服务;pandas 和 NumPy 收结果;httpx 调模型端点;bm25s 后来用来检索做过的例题。项目用 uv 建,所有东西都在一个文件夹里。
数据用 TPC-DS 的 scale 100。DuckDB 官方已经挂好了一份现成的 28.6 GB 单文件版本,省掉几个小时的数据生成。下载环节自己写了断点续传:
"""data.py: 仓库本体、join 关系与事实。"""
import time
import duckdb, httpx
from config import DB_PATH, MEMORY_LIMIT, SCALE, SPILL_DIR, SPILL_LIMIT, THREADS

WAREHOUSE_URL, EXPECTED_BYTES = f"https://blobs.duckdb.org/data/tpcds-sf{SCALE}.db", 28_609_622_016

def ensure_warehouse(path, url, expected):
    part = path.with_suffix(".part")
    for _ in range(0 if path.exists() else 60):           # 断了就续,最多重试 60 次
        have = part.stat().st_size if part.exists() else 0
        if have == expected:
            part.rename(path)
            break
        try:                                              # 只请求还缺的那段字节
            with httpx.stream("GET", url, headers={"Range": f"bytes={have}-"}, timeout=60, follow_redirects=True) as r:
                with open(part, "ab") as f:
                    for chunk in r.raise_for_status().iter_bytes(8 * 2**20):
                        f.write(chunk)
        except httpx.HTTPError:
            time.sleep(5)
    return path.exists() and path.stat().st_size == expected
第二个保险是字节数。一个下载到一半的文件自己不会报错,把大小和期望值比一次,就能在任何东西读它之前拦下来。
打开时永远只读,并且关掉插入顺序:
# data.py
def open_warehouse(path=DB_PATH, memory_limit=MEMORY_LIMIT):
    con = duckdb.connect(str(path), read_only=True, config={
        "threads": THREADS, "memory_limit": memory_limit, "preserve_insertion_order": False,
        "temp_directory": SPILL_DIR.as_posix(), "max_temp_directory_size": SPILL_LIMIT})
    con.execute("SET enable_progress_bar = false")
    return con
回读到的实际配置:threads 16、memory_limit 16.7 GiB、max_temp_directory_size 111.7 GiB、access_mode read_only。要 18 GB 却显示 16.7 GiB,是因为 DuckDB 按二进制单位报;111.7 GiB 是给"装不下的 join"准备的落盘空间。
959,031,513 行写成纯文本是 103.1 GB,DuckDB 只占 28.6 GB:列式存储加上按值域挑的编码,零售这种重复度高的数据压得特别好。
动手之前先扫了一遍参数,因为几乎每个问题都要扫几亿行事实表:
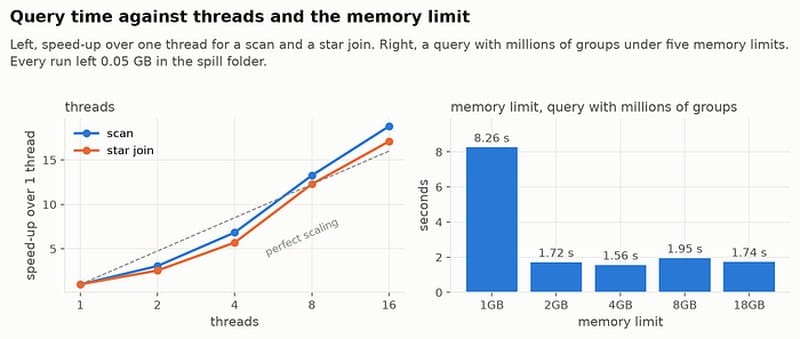
16 个线程比 1 个线程快 17 倍;内存给到 2 GB 以上,耗时基本平了。后面全程 16 线程。
数据里有两个事实会改答案
TPC-DS 和很多真实仓库一样,一个外键都没声明,但列名把关系漏了出来:ss_sold_date_sk 装的是 date_dim 的键,而维表自己的键永远是第一列。于是 join 图可以从名字里读出来:
# data.py
FACT_TABLES = ["store_sales", "store_returns", "catalog_sales", "catalog_returns", "web_sales", "web_returns", "inventory"]

def infer_foreign_keys(con):
    cols = con.execute("SELECT table_name, column_name, column_index FROM duckdb_columns() WHERE ends_with(column_name, '_sk')").fetchall()
    keys = {t: c for t, c, i in cols if i == 1 and t not in FACT_TABLES}   # 维表的第一列就是它的键
    suffixes = sorted([(c.split("_", 1)[1], t) for t, c in keys.items()] + [("addr_sk", "customer_address"),
                      ("cdemo_sk", "customer_demographics"), ("hdemo_sk", "household_demographics")], key=lambda s: -len(s[0]))
    return [(t, c, next(d for s, d in suffixes if c.endswith(s))) for t, c, _ in cols if keys.get(t) != c]
24 张表跑出 104 条关系,一条手写的都不用。名字只是线索,作者拿数据核过:80 亿行事实表上做 LEFT JOIN,没有孤儿键,说明每个键都指向真实存在的行。
同一次核对还挖出一个后面每一节都要处理的问题:
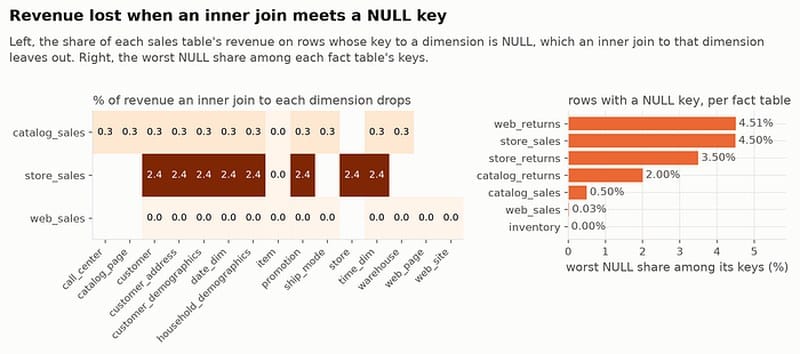
store_sales 的销售键在 4.5% 的行上是 NULL,inner join 把它们无声丢掉,报表少 2.36% 营收,而查询看起来完全正确。
模式也回答不了"数据里有什么":销售覆盖到哪天、哪些州有门店。这些只能从数据本身读出来:
- 销售区间
['1998-01-01', '2003-01-14'],完整年份只有 1998–2002,2003 只有 14 天。 - 门店分布在 9 个州:AL / GA / LA / MI / MO / OH / SC / SD / TN,没有德州。
这两条各改一个答案。不知道 2003 只有 14 天,Agent 会把 2003 报成"营收崩塌";不知道没有德州,"德州门店销售额"这种问题它会硬算出一个数。
先造尺子,再造改法
要判断改动,先得判对错,而判 SQL 答案比比对两张表难:对的答案可能列名不同、行序不同、多一位小数。
比较器先把每个单元格归一(GA 和 ga 同义),再允许半美分误差,然后按值去认列——列名不参与判断:
# ruler.py
def canon(v):
    if v is None or v is pd.NA or v is pd.NaT or v != v:   # 只有 NaN 不等于自己
        return None
    if isinstance(v, (int, float, decimal.Decimal)):
        return float(v)
    s = str(v).strip().lower()
    return None if s == "null" else s

class Comparator:
    def close(self, a, b):
        if isinstance(a, float) and isinstance(b, float):   # 半美分:1 以上给 0.005,1 以下给 5e-5
            return abs(a - b) <= (0.005 if max(abs(a), abs(b)) >= 1 else 5e-5) + 1e-12 * abs(a)
        return a == b
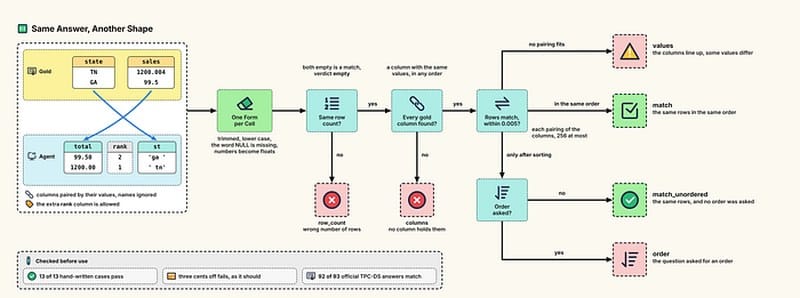
上面三个镜像用例来自 13 条手写测试。手写测试只覆盖想得到的错误,更硬的测试是 TPC-DS 官方的 93 份标准答案(scale 100 公布了 99 条查询中的 93 条):
#### OUTPUT ####
92/93 official answers reproduced on this laptop
total query time 61.6 min, median 6.89s, slowest q67 at 1158.9s
唯一没复现的是 q67:它撞上 900 秒上限,停在 1158.9 秒才被打断——DuckDB 只在步骤之间检查中断,一个长步骤能跑过期限很远。这个行为在后面的实时秒表里又出现了一次。
三道墙:SQL 文本、引擎配置、运行时
让模型对着真实数据写 SQL,等于把每条查询都当成不可信输入。DuckDB 的只读模式只挡写操作,一条普通的 SELECT 照样能读文件、挂别的数据库、装扩展。所以每条 Agent 查询过三道关:
- 语句校验器:只接受一条 SELECT,拒绝文件类函数,读任何行之前先给执行计划估价。
- 锁死的连接:关掉外部文件访问和扩展安装,然后
lock_configuration = true,之后谁都改不回来。 - 运行时上限:30 秒看门狗,最多 10,000 行。
估价这件事有个讽刺的前提:DuckDB 自己的规划器在一张扇出查询上错了 469,796 倍,所以估价得自己算。只有两个事实流相 join 时行数才相乘(左 × 右 ÷ 去重键数),按票号或订单号 join 永远不乘——那是同一次销售的行在配对:
# guard.py
def join_rows(kids, info):
    (left, left_facts, _), (right, right_facts, _) = kids
    conds, kind = info.get("Conditions", []), info.get("Join Type")
    conds = conds if isinstance(conds, list) else [conds]
    if kind in ("SEMI", "ANTI", "MARK"):
        return left
    if left_facts and right_facts and kind in ("INNER", "LEFT", "RIGHT", "OUTER", "FULL") \
            and not re.search(r"ticket_number|order_number", str(conds)):   # 两个事实流相乘
        ndv = lambda c: min([KEY_NDV[k] for k in re.findall(r"\b[a-z]+_[a-z_]*sk\b", c) if k in KEY_NDV]
                            or [max(left, right, 1.0)])
        return left * right / math.prod(map(ndv, conds))
    return max(left, right)
那条骗过规划器的查询,自己算出来 85,927,834,294,703 行,精确数是约 135.3 万亿行——差 1.6 倍,足够分清"便宜的查询"和"跑飞的查询"。预算取最重的官方查询 q82 的 3 倍,99 条官方查询全放行,扇出查询照样挡住。
第二道墙在引擎里,靠设置而不是靠正则:
# guard.py
class LockedWarehouse:
    def __init__(self, con):
        for s in ("enable_external_access", "autoload_known_extensions",
                  "autoinstall_known_extensions", "allow_community_extensions"):
            con.execute(f"SET {s} = false")               # 没有文件,没有新代码
        con.execute("SET lock_configuration = true")      # 单向,之后改不回来
        self.cursor = con.cursor
把同样的 11 个攻击分别打进四种配置,才知道每道墙各自值多少:
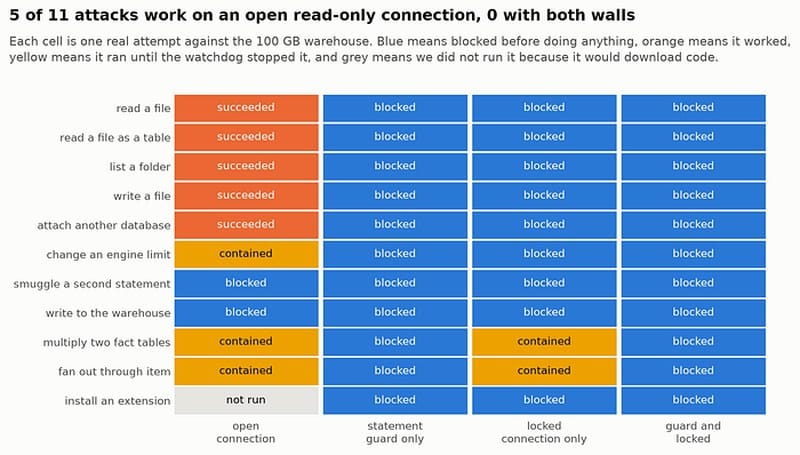
一道墙都不上时,5 个攻击在"只读"连接上得手(读表当文件、列目录、写文件、挂数据库、换引擎参数都能过)。只上校验器,11 个全挡下。两道一起,0 个通过。都留着是因为它们失效的方式不同:校验器读的是 SQL 文本,锁死在引擎内部,不管文本怎么写。
基线:47% 的答案是错的
第一个 Agent 就是教程里那一个,它成为后面一切改动的比较基准。它的提示词只有 schema(一张表一行 CREATE TABLE)、问题,和要求返回 JSON。
打分规则:答对 +1,主动弃答 0,自信地答错 −2。弃答不罚分(不该拿数的时候保持沉默是对的),答错重罚,因为这一条最接近真实代价。
# agent.py
def utility(df):
    # +1 答对,0 弃答,−2 自信地答错
    return np.where(df.correct, 1.0, np.where(df.status == "answered", -2.0, 0.0))
102 道开发题上的成绩:
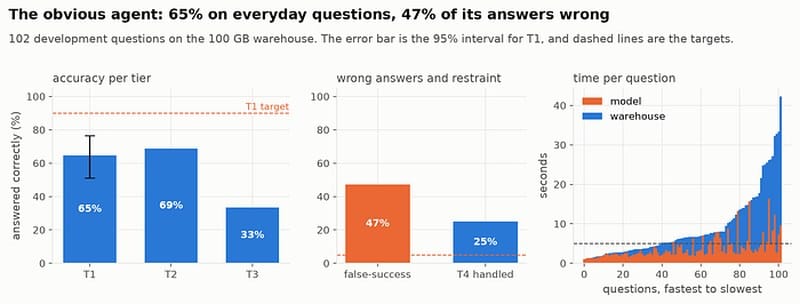
平均每道题亏 0.333 分效用。注意 T4(不该答的题)只处理了 25%——四分之三的"该拒"问题,它给了数字。
一次只改一处,用配对 bootstrap 判定
凭感觉改 Agent 特别容易翻车:每个改动帮一批题、害另一批题。所以 12 次改动,每次跑完 102 道开发题,只有"效用上升,或者效用不变而时间下降"才留下。
判定不是看平均数,而是同一道题在新旧两版上的配对差值,做 2000 次 bootstrap:
# agent.py
def paired_delta(new, old, n=2000):
    # 配对 bootstrap,95% 区间
    diff = new.correct.to_numpy(float) - old.correct.to_numpy(float)
    means = np.random.default_rng(SEED).choice(diff, (n, len(diff))).mean(axis=1)
    return diff.mean(), np.percentile(means, 2.5), np.percentile(means, 97.5)
因为缓存键是对整个请求做哈希,改一次提示词只付被它影响的那些调用的钱,其余全部免费重放。这也是敢跑 12 轮的原因。
第一道门:先判断该不该答
基线答了 15 道不该答的问题。这些可以在写 SQL 之前拦掉:一次短调用(Qwen3.8-27B,max_tokens=150)判断该答、该反问、该弃答还是该拒答。
提示词里带着从数据读出来的销售区间,所以"2016 年的目录销售额"这种问题会撞上"数据只到 2003-01-14"。这道门失败时默认放行:读不懂的返回一律算"答",因为坏掉的门不能把整个系统堵死。
结果:
#### OUTPUT ####
  expected  intake says  question
  answer    answer       Give me the total in-store revenue for Georgia in 1998.
  abstain   abstain      What were catalog sales in January 2016?
  abstain   abstain      What is our average customer satisfaction score?
该拒的题从 25% 处理好到 100%,效用从 −0.333 升到 +0.118。代价是它顺手误拦了 2 道本来能答的题。
业务词典:把"销售额"钉死在一个列上
问"销售额",模型得在一堆价格列里猜。业务词典用几句话把这类问题一次性定死,再补上从数据量出来的事实:
# agent.py
BUSINESS_DEFINITIONS = [
    "Sales is the ext_sales_price column, net profit net_profit, units quantity.",
    "Returns are sr_return_amt, cr_return_amount or wr_return_amt.",
    "Date sales by sold_date_sk and returns by returned_date_sk.",
    "Catalog and web customers are the billed ones.",
    "A basket is one ticket_number, an order one order_number.",
    "Leave out NULL groups. Write percentages from 0 to 100.",
]

def glossary(con, facts):
    # 先定义,再量出来的事实,排序固定所以文本永远一致
    lines = BUSINESS_DEFINITIONS + ["Sales exist only from {} to {}.".format(*facts["sales_date_range"])]
    lines += [f"{y} has only {d} days of sales." for y, d in facts["partial_years"].items()]
    rows = con.execute("SELECT table_name, arg_min(column_name, column_index) FILTER (WHERE ends_with(column_name, "
                       "'_id')) FROM duckdb_columns() WHERE database_name = current_database() GROUP BY 1 "
                       "HAVING bool_or(ends_with(column_name, 'rec_start_date')) ORDER BY 1").fetchall()
    lines += [f"{t} keeps history rows, count entities with count(DISTINCT {i})." for t, i in rows]
    return "\n".join(f"- {line}" for line in lines)
ORDER BY 那一句不是为了好看:词典文本每次运行必须一字不差,否则缓存键变了,所有含它的调用都要重新付钱。
历史表是词典真正救回来的地方。store 表里 201 家门店有 402 行,因为每次改店信息都插新行——没有那句"这张表保留历史行,数实体用 count(DISTINCT)",门店数会翻倍。
加了词典(r02),日常正确率从 62.7% 到 80.4%,效用 +0.382。
两个没奏效的主意
很多 Text-to-SQL 系统还用两招,这里都试了,都回退了:
- 值落地(r03):把问题里出现的词对应的真实数据值塞进提示词。正确率掉 2.0%。原因是写 SQL 的模型本来就知道
'GA'这种码,落地信息是重复的。 - schema 侦察(r04):先用 BM25 选出 5 张表,只给它看这 5 张。正确率掉 13.7%。它在官方查询上只有 27% 的次数选全了需要的表,而查询用不到看不见的表。
这两招解决的是更大的仓库才会有的问题。这里 425 列的 schema 一次塞进提示词毫无压力,全给反而更好。
修一次 + 三道例题:第二大增益
查询报错或返回空,失败本身就说清了哪里不对。修复环节让写 SQL 的模型带着这段描述再试一次;例题环节给它看题库里最相似的几道做过的题:
# agent.py
def repair_reason(qr):
    # 出了什么事;能用就返回 None
    if not qr.ok:
        return f"the query failed: {qr.error}"
    if qr.df.empty or qr.df.isna().all().all():
        return "the query returned no rows, or only NULLs"

def pick_examples(text, k):
    # 有共同词、最接近的已解问题
    index = bm25s.BM25()
    index.index(bm25s.tokenize([q for q, _ in POOL], show_progress=False), show_progress=False)
    docs, scores = index.retrieve(bm25s.tokenize([text], show_progress=False), k=k, show_progress=False)
    return [POOL[i] for i, s in zip(docs[0], scores[0]) if s > 0]
问佐治亚那道题,BM25 从 39 道题池里捞出来的是"田纳西 1999 的门店营收"和"田纳西 2002 的门店总销售"——同结构、换一个州。
单看修复(r05),效用几乎没动;加上 3 道例题(r06),日常正确率到 94.1%,假成功率减半到 11.5%。这是整篇里第二大的一步,而且不花额外的钱:例题只是提示词里多了几十个 token。
第二条路:把自然语言编译成 SQL
就算有例题,一个孤零零的写手也没法自查。于是给它第二条独立通路:语义分析员(Qwen3.8-27B)只干一件事——把问题填成一份 JSON 请求;然后普通的 Python 按规则把请求编译成 SQL,模型在这一步完全不参与。
目录(catalogue)是关键表,它写明每个渠道里每个角色对应哪个键列:
# semantic.py
SALES_FACTS = {   # 渠道 -> 角色 -> 键列
    "store": dict(fact="store_sales", p="ss", date="ss_sold_date_sk", item="ss_item_sk", customer="ss_customer_sk",
                  cdemo="ss_cdemo_sk", addr="ss_addr_sk", store="ss_store_sk", order="ss_ticket_number"),
    "catalog": dict(fact="catalog_sales", p="cs", date="cs_sold_date_sk", item="cs_item_sk",
                    customer="cs_bill_customer_sk", cdemo="cs_bill_cdemo_sk", addr="cs_bill_addr_sk",
                    call_center="cs_call_center_sk", ship_mode="cs_ship_mode_sk", order="cs_order_number"),
    "web": dict(fact="web_sales", p="ws", date="ws_sold_date_sk", item="ws_item_sk", customer="ws_bill_customer_sk",
                cdemo="ws_bill_cdemo_sk", addr="ws_bill_addr_sk", web_site="ws_web_site_sk",
                ship_mode="ws_ship_mode_sk", order="ws_order_number"),
}
编译器只 join 请求真正需要的维表,并且对目录之外的东西直接抛 NotExpressible,不猜:
# semantic.py
def compile_semantic(req, rollup=None):
    metric, channel, groups = req.get("metric"), req.get("channel", "store"), req.get("group_by") or []
    if metric not in METRICS or channel not in SALES_FACTS:
        raise NotExpressible(f"unknown {metric} or {channel}")
    kind, expr = METRICS[metric]
    keys = (SALES_FACTS if kind == "sales" else RETURN_FACTS)[channel]
    joins, alias = "", {}
    for name in groups + [f.get("dimension") for f in req.get("filters") or []]:
        table, role, _, pk = DIMENSIONS.get(name, (None,) * 4)
        if role not in keys:
            raise NotExpressible(f"{name} is not available for {channel} {kind}")
        ...
一正一反两个例子:
#### OUTPUT ####
SELECT d0.i_category AS category, sum(f.ws_net_profit) AS net_profit
FROM web_sales f
JOIN item d0 ON f.ws_item_sk = d0.i_item_sk
JOIN date_dim d1 ON f.ws_sold_date_sk = d1.d_date_sk
WHERE d1.d_year = 2001 AND d0.i_category IS NOT NULL
GROUP BY 1
ORDER BY net_profit DESC
LIMIT 3

  refused: store_state is not available for web sales
只 join 需要的表,意味着 NULL 键再也没机会悄悄吃掉营收。"web 渠道按门店州分组"根本没有意义,所以它被明确拒绝,而不是猜一个出来。
代价是覆盖面:跨渠道、同比环比、占比这三类问题超出目录,只能留给 SQL 写手。能编译的说清能力边界,比硬编出个错数有用。
复式记账:两条路对得上才算答案
会计一笔账记两遍,两边对上才信账本。两条路也是这个用法:A 来自写手,B 来自编译器,两边结果一不一致,就是答案的置信度。
一致时直接用,不一致时请一位裁判(Qwen3.8-Max)读两条 SQL 和各自的前 6 行,判哪条在回答这个问题。三条路线的置信度是固定的:
# semantic.py
def trust_ladder(text, sqls, ok, run):
    # 一致 0.95,裁判选 0.7,只有一条路 0.6
    if not ok:
        return run.answer("abstained", message="no usable result")
    if len(ok) == 1:
        (k, r), = ok.items()
        return run.answer("answered", sql=sqls[k], df=r.df, confidence=0.6)
    if COMPARATOR.compare(ok["A"].df, ok["B"].df).match or COMPARATOR.compare(ok["B"].df, ok["A"].df).match:
        return run.answer("answered", sql=sqls["B"], df=ok["B"].df, confidence=0.95)
    show = "\n\n".join(f"{k}:\n{sqls[k]}\n{ok[k].df.head(6).to_string(index=False)}" for k in "AB")
    r = ask(M_MAX, "critic", f"{text}\n\n{show}", CRITIC_SYSTEM.format(glossary=agent.GLOSSARY), max_tokens=300)
    run.llm(r)
    winner = r.data.get("winner") if isinstance(r.data, dict) else None
    if winner in ("A", "B"):
        return run.answer("answered", sql=sqls[winner], df=ok[winner].df, confidence=0.7)
    return run.answer("abstained", confidence=0.0, message="the routes disagree")
这里没有设置置信度门槛:试过用阈值把单路答案也弃掉,效用反而下降。所以单路回答保留,只是标成 0.6。
r07 的分布:
#### OUTPUT ####
                     questions  answered  correct
both routes agree           40      100%     100%
disagree, critic: A          1      100%     100%
disagree, critic: B          3      100%     100%
no answer                    6        0%       0%
single route only           32      100%      75%
效用只挪到 +0.706,但置信度变得可信了:40 道两路一致的题,全对。代价是时间——每道题两条查询,中位数从原来被拖到 12.27 秒。
按日期排一遍,再做五张汇总表
到 r07,仓库占了每道题 69% 的时间,而绝大多数问题带日期过滤。DuckDB 会记下每个数据块里最小和最大的值,范围对不上就整块跳过——但 store_sales 原来没有日期顺序可利用。
于是花 189.3 分钟建了一份按日期排序的副本:
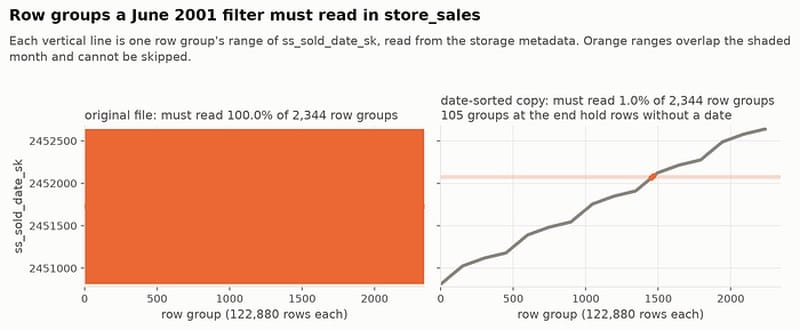
store_sales 从 100% 降到 1.0%,web_sales 从 100% 降到 1.2%。
排序副本之上再建五张按天的汇总表,全部用 LEFT JOIN 建,保证汇总数和事实表对得上。语义通路会自动挑最小的那张:
# speed.py
ROLLUP_GRAIN = {  # 维度、指标、渠道,从小到大
    "rollup_store_day": ({"store_state", "store_city"}, SUMS, {"store"}),
    "rollup_custstate_day": ({"customer_state"}, SUMS, ALL),
    "rollup_demo_day": ({"gender", "marital_status", "education"}, SUMS, ALL),
    "rollup_returns_day": ({"category", "return_reason"}, {"return_amount"}, ALL),
    "rollup_item_day": ({"category", "class", "brand"}, SUMS, ALL),
}

def pick_rollup(req):
    # 装得下这个请求的最小汇总表
    need = set(req.get("group_by") or []) | {f["dimension"] for f in req.get("filters") or []}
    return next((name for name, (dims, metrics, channels) in ROLLUP_GRAIN.items()
                 if need <= dims | set(DATE_COLS) and req["metric"] in metrics
                 and req.get("channel", "store") in channels), None)
抽查的 37 个汇总答案全部和事实表一致。切到排序副本后(r09),中位数从 12.27 秒降到 6.03 秒。
投机执行:三条调用一起发
仓库快了,模型调用成了瓶颈。r09 时一道中位数问题的瀑布是这样的:
#### OUTPUT ####
  intake                         1.27s  ############
  semantic + sql in parallel     5.06s  ##################################################
  execute both                   0.79s  #######
  total                          7.12s
草稿等了 1.27 秒,而绝大多数问题都能过门。CPU 处理这种等待用的是投机执行,这里照搬:三条调用一起发,门说不行就把草稿扔掉。
# speed.py
def make_speculative_agent(cfg):
    # 最终系统:门和草稿一起发
    def answer(text):
        run = Run()
        examples = pick_examples(text, cfg.fewshot) if cfg.fewshot else []
        calls = parallel(lambda: intake_call(text),
                         lambda: ask(M_27B, "semantic_analyst", text, SEMANTIC_SYSTEM, max_tokens=400),
                         lambda: ask(cfg.writer, "sql_writer", writer_prompt(text, cfg, examples), max_tokens=1500))
        run.llm(*calls)                          # 计时只算最慢的那条
        if stop := intake_stop(calls[0], run):   # 草稿已经付钱,然后扔掉
            return stop
        return double_entry_settle(text, cfg, calls[1:], run, compile_b=compile_semantic_fast)
    return answer
同一道题降到 6.64 秒,开发集中位数 5.07 秒,答案完全没变。代价很实在:被门拦下的问题仍然为没人用的草稿付钱,单题成本升到 0.621 信用点。
换模型这一步,排在最后
写手一直是按价格挑的 Qwen3.8-27B,从来没和别的模型比过 SQL 质量。到第 12 次改动才补上这一课:拿最好的系统跑五遍,一遍换一个写手模型,题目是有标准答案的 82 道开发题。
#### OUTPUT ####
writer                   utility     T3  false_success  p50_s  credits_per_q
Qwen/Qwen3.7-Plus          0.793  0.667          0.062  5.036          0.611
Qwen/Qwen3.7-Max           0.756  0.600          0.075  4.669          0.912
Qwen/Qwen3.8-Flash-Next    0.744  0.533          0.076  4.372          0.621
Qwen/Qwen3.8-27B           0.683  0.467          0.100  6.382          0.626
Qwen/Qwen3.8-Max           0.671  0.467          0.101  4.487          0.924
五个模型在日常题上都答对 98%,胜负由硬的官方那一档决定。
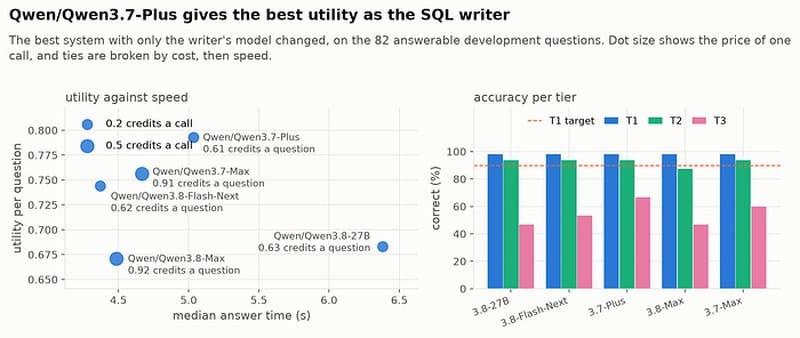
便宜的那个写出的 SQL 更好:0.2 一次的那个效用 0.793,两个 0.5 一次的 Max 是 0.756 和 0.671。换成它(r12)后效用到 +0.833,假成功率压到 6.2%。
再往下试的两个改动都回退了:加第二个写手做交叉核对(r13),两个写手在 2 道错题上达成一致;给每题 15 秒预算(r15),p95 降到 12.09 秒但把一道对的答案变成了错的。
尾部:一条卡死的 SQL 就能毁掉 p95
有一档可选能力:最难的官方查询交给一个"调查员"(Qwen3.8-Max)先去采样看数据,再写最终查询。在 15 道官方开发题上(r11),答对从 6 道到 8 道,代价是每题中位 28.8 秒、2.17 信用点。太慢太贵,所以默认关闭。
另一个反直觉的发现来自跑法本身。为了省时间,所有修订都是一次跑 4 道题;但延迟目标描述的是"一个人问一个问题":
#### OUTPUT ####
view            p50_s  p95_s  answers_over_15s  right_over_15s
four at a time   3.68  15.85                 9            0.67
one at a time    3.57   9.44                 0             NaN
四道并发时,超过 15 秒的那些答案只有 67% 是对的——慢的答案同时更容易错。一次一道跑,p95 从 15.85 秒降到 9.44 秒。
留出测试:日常过 90%,假成功率没到 5%
考试造好时就隔开了 194 道题,任何一次修订都没有在它们身上选过。最后各跑一次:
#### OUTPUT ####
                              obvious agent          final system (r12)
T1 everyday accuracy    66.7% (CI 57 to 76)         90.9% (CI 85 to 96)    target >= 90%
T2 analyst accuracy                   39.0%                       80.5%
T3 official accuracy                  37.5%                       62.5%
false-success rate      47.1% (CI 40 to 55)          9.8% (CI 5 to 15)     target <= 5%
T4 handled                            23.3%                      100.0%
latency p50 / p95            3.33s / 17.08s              3.40s / 12.78s    target 5s / 15s
credits per question                   0.20                        0.62
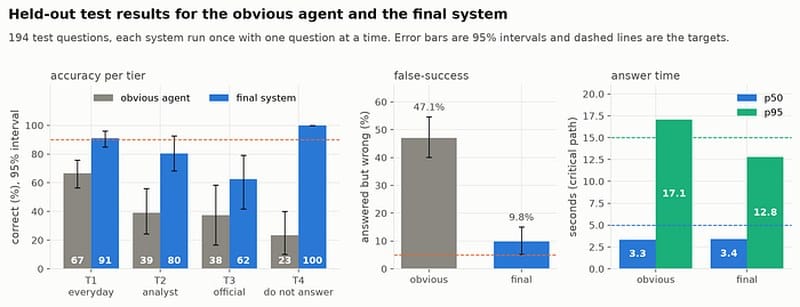
没见过的题上,日常正确率过 90%,每一道"不该答"的题都拒掉了。假成功率没达 5% 的目标,差一半。
不熟悉的模板上准确率明显更低:开发集里从未出现的 12 个模板只有 85%,熟悉的那些 96%。裁判唯一一次判错,是把"How much Children did we sell"读成了件数,而标准答案是销售额。
秒表实测
用户等的是真时钟,包含重试和慢端点。最后一次测量从空缓存开始,20 道测试题各跑 3 遍,60 次全部掐表:
#### OUTPUT ####
60 live answers: 20 test questions x 3 repeats
stopwatch p50   3.82s   target <= 5s    MET
stopwatch p95  24.55s   target <= 15s   MISSED
尾部的锅在一道题身上:
#### OUTPUT ####
t1_sales_by_education#5 (repeat 3): 113.69s, answered, right
    intake + semantic + sql in parallel     1.89s
    execute both                           68.58s  timeout
    execute both                            2.91s  ok
    repair_1                                3.22s
    execute_after_repair_1                 38.36s  timeout
一条查询跑到 68.58 秒才被打断,它的修复又超时一次,而另一条路 2.91 秒就答对了。答案要等两条路都回来,一条卡住的查询就决定了这道题的时间。
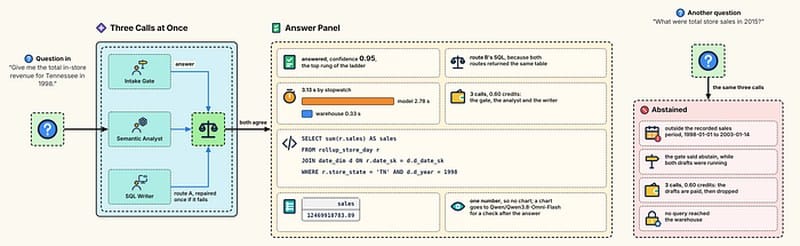
日常第一道题的完整输出长这样:
#### OUTPUT ####
answered, confidence 0.95.
3.13s (model 2.78s, warehouse 0.33s), 3 calls, 0.60 credits
SELECT sum(r.sales) AS sales
FROM rollup_store_day r
JOIN date_dim d ON r.date_sk = d.d_date_sk
WHERE r.store_state = 'TN' AND d.d_year = 1998
         sales
12469910783.89
两路一致,所以显示的是走汇总表那条路的 SQL。把每一步的时间加起来是 3.80 和 24.51 秒,跟秒表很接近。
图表另有一位检查员(Qwen3.8-Omni-Flash)在答案出图后再看一眼:12 张真实图表上没有误报,同时抓住了作者故意埋进去的 71% 错误。
已知边界
两个目标没达成。 测试集上 9.8% 的作答是错的,目标是 5%;15 个错答案里 14 个来自"只有一条路返回了行"的题。实时 p95 是 24.55 秒,目标是 15 秒。
数据只覆盖一种条件。 一个生成的仓库、一台笔记本、一个用户、跑测那几天的 API。这些数字不能拿去和 Text-to-SQL 榜单比。
安全测试只走了 SQL。 11 个攻击都从 SQL 入口进,没有试过"把指令藏在数据值里"这种注入。
流程有个先后问题。 早期的系统也在测试集上跑过,之后才在开发集上修掉两条判错规则。
图表检查员没有公开价格,它的成本没有计入。
我们的整理:要在自己仓库上照做,先做这五件
原文最有价值的地方不是那套代码,而是顺序:先造尺子和墙,再调提示词和模型。 如果只能搬五件事:
| 先做 | 解决什么 | 判断做对了没有 |
|---|---|---|
| 一把能判对错的尺子 | 没有它,后面每一次改动都是感觉 | 拿官方标准答案跑一遍,看复现率(这里 92/93) |
| 假成功率和作答率一起报 | 只看准确率,会奖励"什么都不答" | 两个数字同时出现在报表同一行 |
| 三道墙(文本校验 + 引擎锁 + 运行时) | 只读模式挡不住读文件、挂库、装扩展 | 11 个攻击逐个过一遍,看哪道墙拦下的 |
| 业务词典 + 3 道例题 | 最便宜的一步,而且不花额外调用 | 门店数是否翻倍、日期区间是否写进提示词 |
| 按题配对 bootstrap | 否则分辨不出真提升和噪声 | 每次改动给出 95% 区间,而不是一个平均数 |
再加三条这次踩出来的判据:
- 换模型放最后。先做门、词典、例题、双路核对,模型横评放到第 12 步——两个更贵的 Max 反而更低,便宜的那个赢了。
- 数据事实要进提示词。销售截止日、部分年份、缺的州、保留历史行的维表,这四类事实各能改掉一批答案,而它们只能从数据里读,模式里没有。
- 延迟目标要用"一次一个"来测。四道并发跑出来的 p95 好看,但那不是用户的处境,而且慢的答案更容易错。
原文没覆盖到的两件事,落地时得自己补:一是同一批题反复用会过拟合,这里的 102 道开发题被跑了 12 轮,作者只能用 194 道题兜底——工程上更稳的做法是准备三轮互不重叠的题;二是"只有一条路返回行"这类题(15 个错答案里 14 个)值得单独做一类处理,比如强制第二路重写一次再比,而不是直接按 0.6 置信度交出去。
相关阅读:
- 智能体说“搞定了”,数据库不同意:用终态和重复 20 次给 Agent 打分——同一套“先造尺子”的思路,只是评分对象换成了终态。
- Agentic 分析 ≠ Text-to-SQL——为什么直接 NL2SQL 不够。
- 搭建 agentic 数据科学团队——把数据分析拆给多个 Agent 的另一种组织方式。
原文:Engineering Multi-Agent AI for a 100 GB Data Warehouse(Fareed Khan,Level Up Coding,2026-10-26,38 分钟)。作者开源了完整代码:FareedKhan-dev/agentic-warehouse-analyst。
原文中标注 #### OUTPUT #### 的代码块是作者的实测输出,其余代码块为原文节选(完整实现见仓库)。本文由汇智网编译整理,转载请注明出处。
这是「Agent / MCP」专题的一部分。完整地图见:Agent / MCP / 自动化完全指南