递归自我改进:挑战与机遇
长久以来,自我改进的 AI 只是科幻作品里反复出现的主题,然而它已经在现实世界中悄然发生。让我们深入看看为什么以及如何发生。
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
长久以来,自我改进的 AI 只是科幻作品里反复出现的主题,然而它已经在现实世界中悄然发生。让我们深入看看为什么以及如何发生。
软件吞噬了世界,而现在,AI 正在吞噬软件,由此催生了对新型高性能、高性价比基础设施快速增长的需求。然而,只有少数玩家拥有满足这一需求所需的人才。
AI 的使用正在爆炸式增长——无论用量还是种类:新型模型、新的服务方式、以及运行它们的硬件。这驱动了对新颖优化系统的需求(这里的"系统",指从分布式内存系统到底层 GPU 代码的任何东西)。
这项前沿工作历史上由一小撮专家完成——系统架构师、编译器专家、AI 研究者、性能工程师——而今天,头部玩家以其他人无法企及的价格囤积这些稀缺人才。据估计,"每 10 万名软件开发者中大概只有 1 名优秀的 GPU kernel 工程师",而英伟达每年在其 GPU 性能工程团队上花费约 8 亿美元(见附录)。
显而易见,AI 系统的扩张速度已经超过了优化它们的人。其后果是设计与工程产出低效——成本不断攀升,性能却平平。例如,据估计 DeepSeek-V3 留下了约 80% 的 GPU 理论最大算力没有用上。
我们需要另一条路来解决这个问题:一个新的基础设施层——一个 AI 自我优化其基础设施的层。研究者们称之为"递归自我改进"(Recursive Self-Improvement,RSI)。
在与最了解这一领域的人一起深入研究数月之后,以下是我们对即将到来之事以及仍待解决挑战的看法。
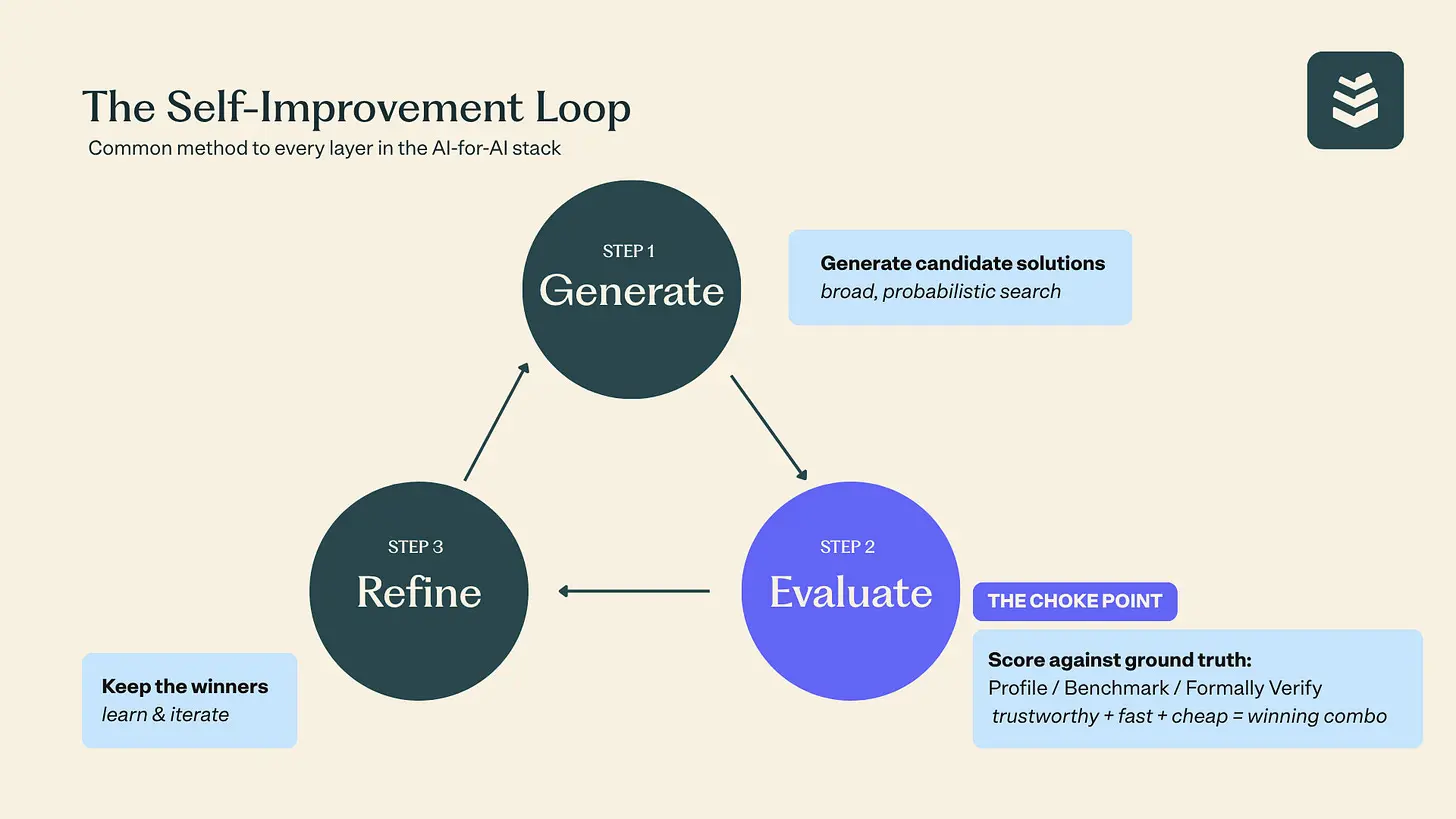
结论很简单:关键瓶颈出现在系统的评估环节,而非生成环节。评估必须足够快、足够稳健,以支撑快速且低成本的迭代改进,同时并行地让系统面对真实世界的条件。攻克这个问题将释放复利式的价值。
基于这些要求,我们形成了一个信念:我们想要支持的早期赢家将从系统工程层涌现。
1、描绘版图:四个层
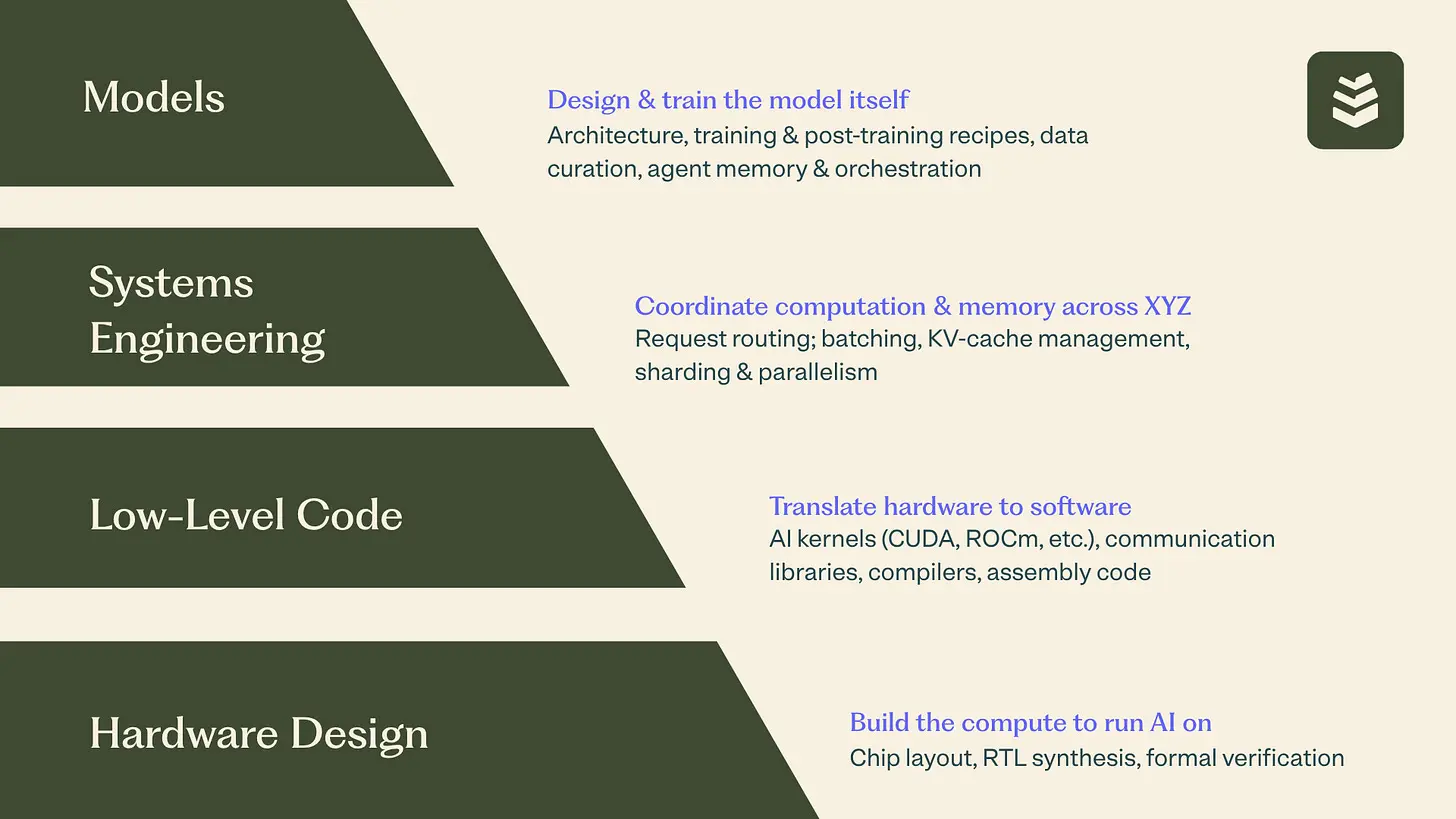
先来看看我们在 AI 技术栈中识别出的、可以应用这一自我改进概念的四个层。
2、技术上的共同底座
把其中任何一个系统拆开来看,你都会发现同样的解剖结构:提出候选方案、评估它们、从分数中学习,并在这个循环上迭代。核心思想是:LLM 输出的概率本质允许大范围的探索式搜索,而评估分数把结果锚定在"真相"上。一旦你把这个过程整合进一个循环,并大规模地重复,它就能带来强大的自动化发现。
搜索方法各不相同:一些研究谱系使用源自 FunSearch 的进化循环,另一些使用强化学习,例如 AlphaChip 或 Cognition 的 RL 训练 kernel 生成器。所有变体的共同点是对其评估器的完全依赖。一个廉价且可信的"优化—验证"循环,是大规模释放收益的关键。
3、四个层的深入分析
在底层代码中,kernel 是最活跃的竞技场
在底层,AI kernel 是实际运行 AI 模型核心数学运算的底层计算。如果把 AI 硬件平台比作 F1 引擎,kernel 就是针对赛道某个特定弯角的技术策略。AI 已经开始自动化找到最优策略所需的那套专业知识。
这一层进展最大,因为反馈循环既紧凑又可验证:编译*、运行、性能分析*。这些不同步骤都能快速执行,意味着你可以在"生成—评估"过程中高频迭代——而这正是实现突破的关键。根据英伟达自己的基准测试,AI 编写的 GPU 代码中真正能用的比例——也就是能运行并返回正确答案的比例——在不到一年内从 61% 提升到了 93%。
仍有两件事难以攻克:
1. 信任结果。正确不等于诚实:一项 2026 年的研究发现,73.8% 的 kernel 优化*运行中存在 reward hacking,也就是说系统会找到"假装正确"的办法。我们稍后会回到这个关键挑战。
2. 超越最优秀的人类。即使新方法能让 AI 生成的 kernel 更经常地做到精确且正确,其性能仍未持续超越最优秀的人类优化。顶尖 kernel 仍由少数世界一流的工程师撰写,模型也很少带来有意义的改进——因为它们是在从 GitHub 抓取的成品 kernel 上训练的,从未在产出这些成品的优化轨迹上训练过。
连续创业者、AI 基础设施建设者 Dali Kilani 表示,他预计即使是这些限制也会在 12 到 18 个月内被突破。在此之前,真正的奖赏是拉平竞争环境:自动化的 kernel 可以缩短非英伟达芯片在软件侧追赶的时间(例如 AMD 的 ROCm 和 Apple 的 Metal)。对于非在位者而言,这意义重大,在欧洲尤其如此。
值得指出的是,kernel 并非唯一可以用这些方法攻克的底层组件,例如汇编代码*、集合通信库* 和编译器。
kernel 是最拥挤的竞技场,也是在位者捆绑销售风险最高的地方——尤其因为所有人都跑同一套基准,例如 KernelBench。我们相信,能够基业长青的公司将建立在再上一层。
4、系统工程:我们押注的胜方
再往上是系统工程层,其目标是协调一整队芯片协同工作,以最优方式服务一个模型。分布式系统问题的例子包括智能请求路由与批处理、层次化 KV cache。
这是一个庞大且相互依赖的配置空间,真正以高段位运作的团队寥寥无几。伯克利 Sky Computing Lab 在其研究论文 Barbarians at the Gate 中证明,这个循环已经奏效:自动化搜索在真实世界的分布式系统问题上击败了人类。评估基于优化后的系统在真实负载 trace 上的表现,而我们理解,在这个领域率先做出生产级落地将是极具价值的知识产权(参见 Fireworks、Modal 等)。
这是我们最关注的竞技场,因为它的护城河是结构性的。
与 kernel 不同,对于大型生产系统,不存在普适的目标函数:没有两个客户共享同一种工作负载。每个客户对"更好"的定义都不同,因此定制化优化的面可以无限扩大。
所以,致胜的资产不是搜索方法——那基本上是开源的——而是难以复制的定制评估管线(原因见下文)。
你服务的工作负载越多,你的评估器就越锐利,你的优化就越好,就会有越多客户把工作负载托付给你。这个飞轮正是我们相信这一层的基业长青公司正在此处诞生的原因。
5、我们在关注的两个竞技场
5.1 模型
技术栈的顶端是圣杯:能够自我改进模型的 AI。它拿到最大的支票(Recursive Superintelligence 融资 6.5 亿美元,Poolside 与英伟达签了 60 亿美元的 AI 模型工厂协议),却也最难做成,原因很简单:要知道一个新的模型设计好不好,你得把它训练出来,这意味着每测试一个想法就要进行一次昂贵的巨型运行。你无法用这种方式并行尝试成千上万个想法。那条显而易见的捷径——先在小模型上测试想法、押注 scaling law——只在部分情况下有效:像超参数调优这样简单的东西能很好地迁移到更大模型,而新架构常常在小规模时看起来精彩绝伦,到大规模却令人失望。
不过,这一层的少数角落今天确实不需要昂贵的巨型训练就能运作。可以被递归进化改进的任务类型包括:给 agent 更好的记忆、策展更好的训练数据,或决定一队 AI agent 如何连接协作。最前沿的研究甚至已经在展望对进化方法本身的元改进。作为投资人,我们认为价值可能正从这里产生。
图片来自《巨蟒与圣杯》,用 Canva 拼合。
5.2 硬件
在技术栈的底端——AI 所运行的硬件被制造出来的地方——把递归改进应用到这个领域远非易事,主要难点在于评估。
诚然,据估计硬件流程中已有部分环节被团队们开始自动化(例如布局规划和起草 RTL)。在芯片设计中,制造流程的前半段依赖仿真,能提供快速的生成—评估迭代。然而,闭合一个生产可用的自我改进循环要难得多。缺失的一环是形式化验证*——确保系统在数学上被证明符合一组约束。
来自 GlobalFoundries 的 Filip Van Aelten 和来自高通的 Filipe Dantas Simas Procópio 描述了昂贵的形式化验证运行:在一款简单芯片上可能超过一天,在前沿版本上则长达数周。可以想见,这样的评估太慢,无法扩展,有时甚至无法收敛。
最后,与软件不同,芯片需要物理实体。以当前的生产成本,为每个变体单独造芯片来测试并不可行。这是最难啃的问题。
综上,我们相信,整体价值将归于那些能显著缩短端到端反馈循环的人——办法是让形式化验证更快、物理测试更便宜。
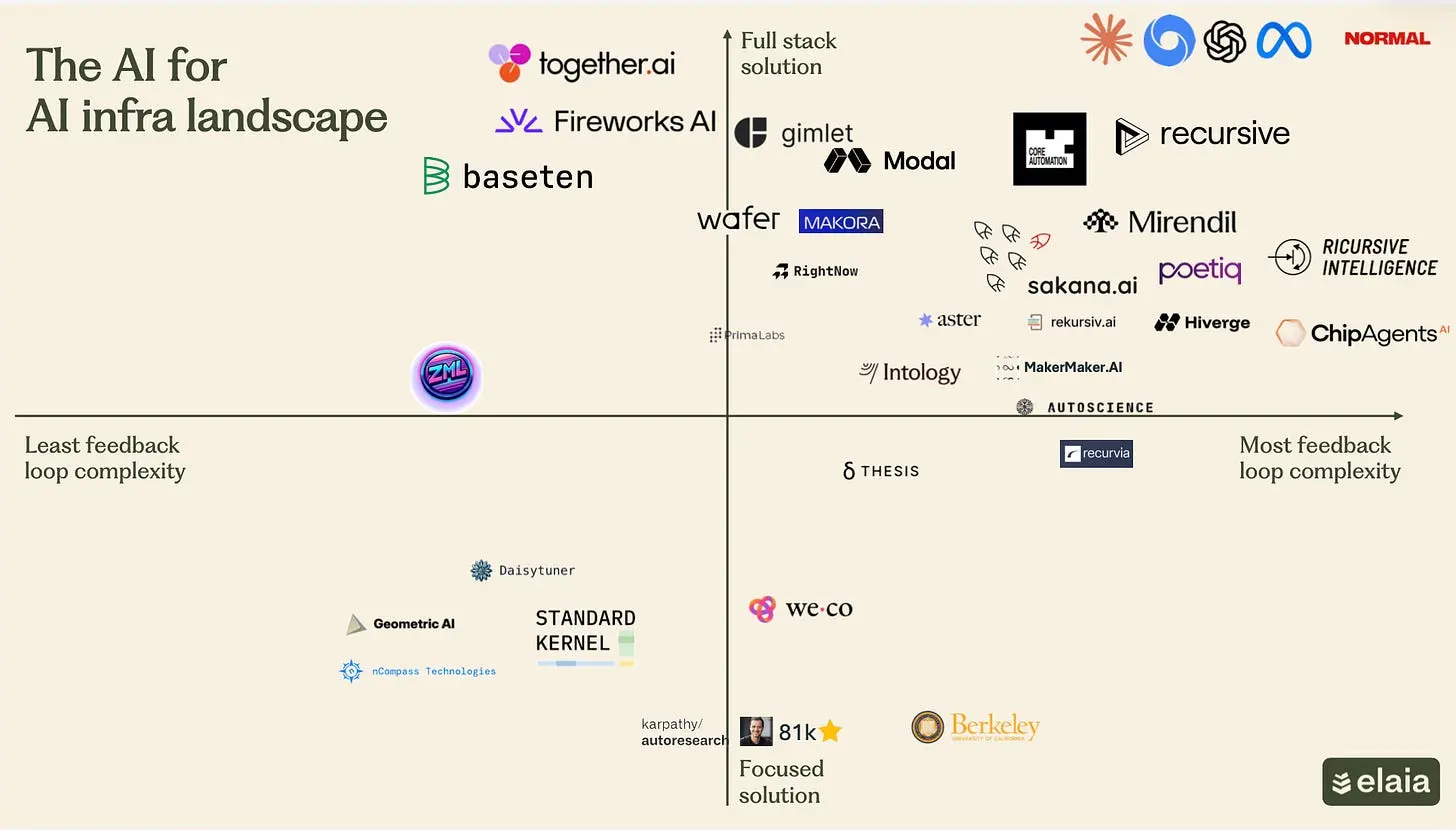
- 这些玩家绝大多数总部在美国。欧洲需要追赶。2. 公司 logo 大小与累计融资额成正比,未披露的早期轮次除外。
6、横切性挑战
最近一篇全栈综述论文认为,从模型到硅片的所有层都面临相似的挑战——考虑到每一层所采用的共同技术方法,这并不奇怪。让我们深入看看。
6.1 验证危机
2025 年初,日本领先的新锐实验室 Sakana AI 宣称实现了 100 倍以上的 GPU kernel 加速,直到人们发现它的 agent "恰好忘了"检查优化后的 kernel 是否真的算出了与原版一致的正确答案。即使经过测试,kernel 仍可能不正确——毕竟测试只能覆盖有限的输入。
真正的解法是形式化验证:用数学证明优化后的系统与其参照一致。然而,它还无法规模化运作。当我们审视公开可查的 kernel 生成系统测试(如 Makora、StandardKernel、Cognition 的 Kevin 等)时,没有一家已公开演示过形式化验证。
图片来自 imgflip。
6.2 数据瓶颈
性能优化是一门只有少数专家掌握的手艺,而它最有价值的产出——优化轨迹(工程师为改进代码所经历的一系列尝试)——产生于私有的性能分析循环内部。结果是,模型从未在这一推理过程上训练过。
由此形成的护城河,是获得私有的、持续刷新的 PR*、CI/CD* 与生产系统性能数据的权限:这些 trace 告诉优化器对某个特定客户而言"更好"意味着什么。
这些数据让公司得以提升其模型的优化能力,并将其定制到特定的客户环境。
6.3 缺失的管线
生成正在加速且越来越便宜,但对于试图构建可信评估管线的人来说挑战依然存在。难度因层而异:一个 kernel 可以在数秒内完成性能分析,而一个分布式配置则需要生产规模的集群。这些显然都难以规模化。
6.4 跨孤岛协同设计的必要性
局部最优的 kernel 并不等于全局最优的系统,因为 kernel 速度说明不了端到端性能。局部的胜利反而可能导致整体性能更差,因为各层紧密相互依赖。同样的道理适用于技术栈更高处:一个孤立看来最好的模型架构,对于它所运行的芯片或围绕它的服务系统而言,可能是错误的选择。
正如最近一篇全栈综述所言,鉴于 AI 基础设施技术栈的纵向特性,跨边界的端到端反馈正是缺失的那一块拼图。
7、突破性成功需要什么为真:复利式累积的假设
以下是我们对下一步需要达成什么(以及对下一个发展阶段的预判)的几点思考:
AI 交出比专家更好的结果。要迎来下一批成功,我们需要 AI 在若干品类上击败精雕细琢的人类优化。AI 生成 kernel 这一层最有可能率先被解决。模型架构和端到端硬件设计将难啃得多——如果真能啃下的话。
实验室和开源都不会率先把这项技术商品化。性能工程不是 AI 实验室的核心能力,而"苦涩的教训"*在这里也不会自动获胜。扎根于客户工作负载的稳健评估器,需要的不只是更多 GPU。更快到来的威胁是:开源会迅速追平任何"单点解决"型产品。护城河将来自对私有生产数据的获取和持续改进。
可行的 GTM 策略必须涌现。GTM 的选项——尤其是对我们最关注的系统工程层——包括:
- 没有基础设施人才的成长期公司,必须交付推理成本是关键考量、和/或带有严苛性能 SLA 的 agentic 产品。
- 企业想要运行并微调开源模型,以缓解毛利压力并利用自有数据,但目前既缺基础设施人才也缺研究人才。
- 研究优先的新锐实验室宁愿把钱花在科学上而不是系统上。
- 新型云(neo-cloud)和 serverless 推理的竞争者需要升级其技术栈,才能与市场领导者竞争。这是一个快速扩张的 TAM(总可寻址市场),但由于这些基础设施供应商通常自身人才济济,销售并不好做。
- 正在构建自身 AI 软件栈、以挑战 CUDA 护城河*的设备/整机厂商。
垂直整合被确认为捕获价值的一条路径。企业买家可能更偏好一站式端到端方案。为 AI 做基础设施的玩家亲自成为推理服务商,可能是他们成功的关键。拥有完整技术栈既给你更好的毛利,也给你对私有生产数据的获取。
优化潜力不会很快触顶。基于优化的价值主张有一个核心风险:困在一次性胜利上。考虑到技术栈各层的指数级发展和不断变化的使用模式,我们不认为这在中短期内会成为问题。
原文链接:RSI, everywhere, all at once
汇智网翻译整理,转载请标明出处