软件即模型:重新理解软件开发
如果把软件看作一种模型,那么软件开发是不是也可以被看作一种模型优化过程?
梯形图转SCL | 需求文本转SCL | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI | ElevenLabs | KlingAI | ArtSpace
最近在想一个比较简单的事情:
如果把软件看作一种模型,那么软件开发是不是也可以被看作一种模型优化过程?
我暂时把这种思路称为:
软件即模型(Software as a Model)
这里的“模型”并不是特指机器学习模型,而是更一般意义上的模型:一个能够根据输入产生行为和输出的系统。
1、软件本身就是一种模型
通常我们把软件理解成一组代码。
但从行为的角度看,软件也可以抽象成:
flowchart LR
    A[输入] --> B[软件模型]
    B --> C[输出]
给软件输入一组状态、数据或者事件,它会产生相应的输出和行为。
例如:
- 给计算器输入
1 + 2,得到3 - 给 Web 服务发送 HTTP 请求,得到响应
- 给编译器输入源代码,得到目标程序
- 给控制系统输入传感器数据,得到控制输出
从这个角度看,代码只是模型的一种表达形式。
真正重要的是:
这个软件在各种输入和状态下表现出了什么行为。
这其实和机器学习模型的抽象非常接近。
2、如果软件是模型,那么测试就是模型评价
机器学习模型通常可以表示为:

软件也可以用类似的方式理解:

一个测试用例实际上就是一个行为样本:
Input
Expected Output
软件运行之后得到:
Actual Output然后比较:
Actual Output ≠ Expected Output于是产生了一个行为错误。
如果从这个角度重新看待测试,那么测试就不只是传统意义上的“验证代码有没有 Bug”。
它实际上是在回答:
当前软件模型与目标行为之间还有多大差距?
3、软件开发可以看成一个优化循环
传统的软件开发大致是:
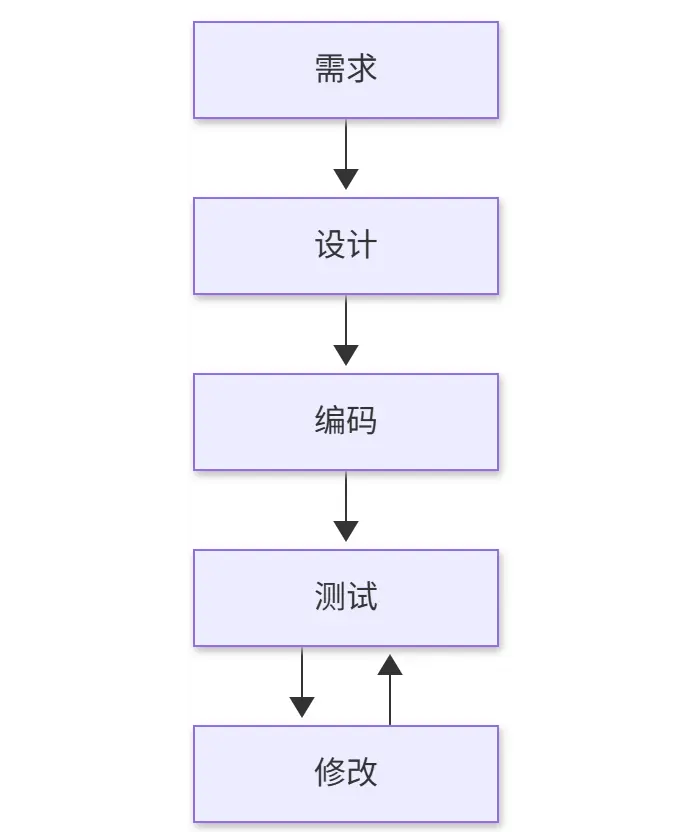
如果采用“软件即模型”的视角,可以把它抽象成:
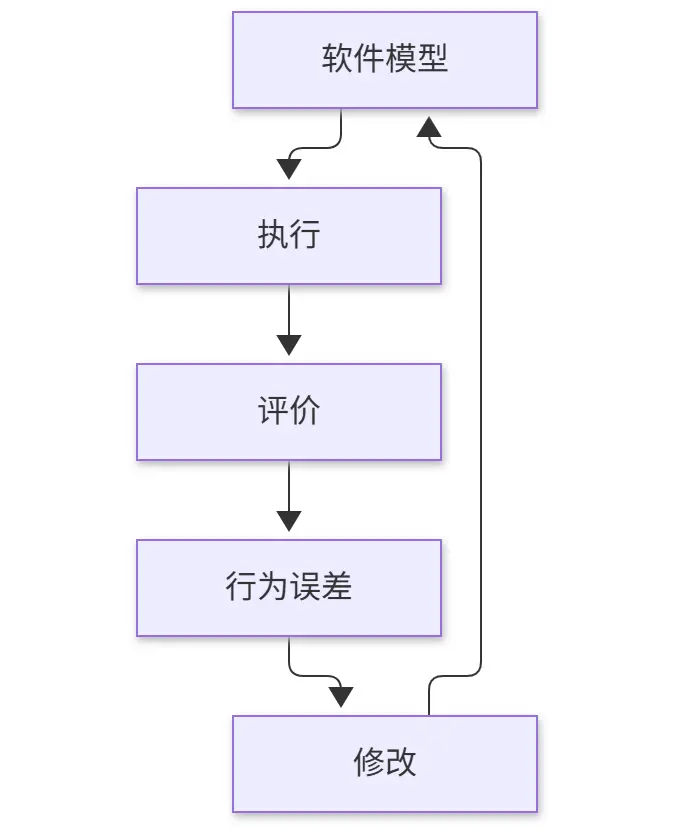
这时候,软件开发就很像一个持续优化的问题:
找到一个软件模型,使它在尽可能多的输入和环境下表现出期望的行为。
这和机器学习的目标在抽象层面上非常接近。
4、其实已经有人在研究类似的问题
这个想法并不是凭空出现的。
计算机科学中已经有很多方向在研究“根据行为要求产生或者修改程序”。
4.1 Program Synthesis
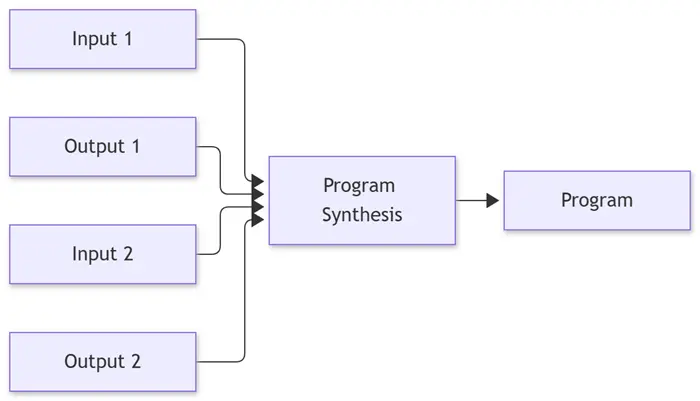
程序综合(Program Synthesis)研究的是:
根据规格、示例或者约束,自动生成满足要求的程序。
例如给出:
Input 1 → Output 1
Input 2 → Output 2
Input 3 → Output 3
让系统寻找一个能够满足这些行为约束的程序。
4.2 Programming by Example
Programming by Example(PBE)则更加直接:
用户不一定告诉计算机“应该怎么写”,而是给出几个例子,让系统推断程序应该做什么。
这实际上已经非常接近“软件是一个可以根据输入输出样本推断出来的模型”这个观点。
4.3 Test-Driven Synthesis
还有一类研究直接把测试用例作为程序综合的约束。
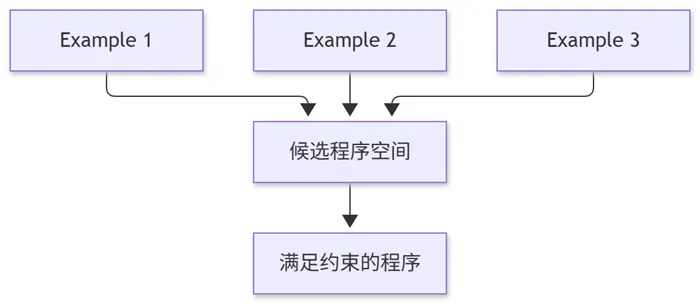
测试不再只是程序生成之后的检查,而成为程序生成过程本身的约束条件。
5、Software 2.0 提供了另一个方向
Andrej Karpathy 在 2017 年提出过一个很有影响力的概念:
Software 2.0
传统软件主要是:
flowchart LR
    A[需求] --> B[程序员]
    B --> C[代码]
    C --> D[行为]
而机器学习系统则可以是:
flowchart LR
    A[数据] --> B[训练]
    B --> C[模型参数]
    C --> D[行为]
这实际上已经改变了“软件是什么”的定义。
在传统软件中,人直接编写程序逻辑。
在机器学习软件中,人提供数据、目标和训练方法,由训练过程产生模型参数。
“软件即模型”与 Software 2.0 有相似之处,但范围更广。
它并不要求软件一定是神经网络。
一个传统的 Python 程序、C++ 程序、PLC 程序,只要它可以被看作一个产生行为的系统,同样可以被看成模型。
6、软件模型和机器学习模型的区别
当然,软件优化并不等于机器学习训练。
机器学习模型通常具有连续的参数空间:
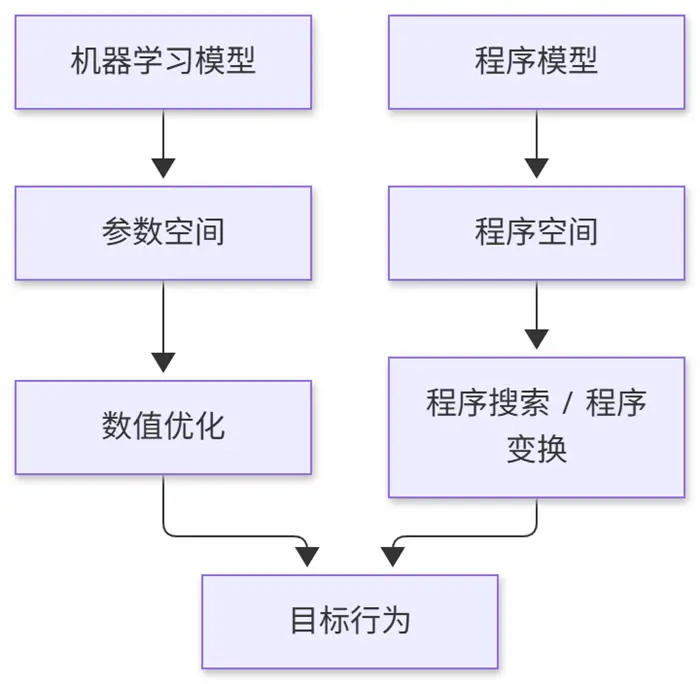
神经网络可能通过梯度下降调整参数。
而程序通常不能简单地通过“调整几个参数”得到下一个更好的程序。
程序的变化往往是:
- 增加一个条件
- 删除一个分支
- 修改一个算法
- 更换一个数据结构
- 调整程序结构
- 修改状态机
- 增加异常处理
因此,更准确地说:
软件开发可以被看成程序空间中的搜索与优化。
它与机器学习训练在形式上不同,但在更高层次上有一个共同点:
根据反馈不断改变模型,使模型的行为越来越接近目标。
7、测试数据可以变成“软件训练数据”
如果接受这个观点,那么测试用例的意义也会发生变化。
传统测试通常是:
开发 → 测试 → 发现 Bug → 修复而在“软件即模型”的视角下:
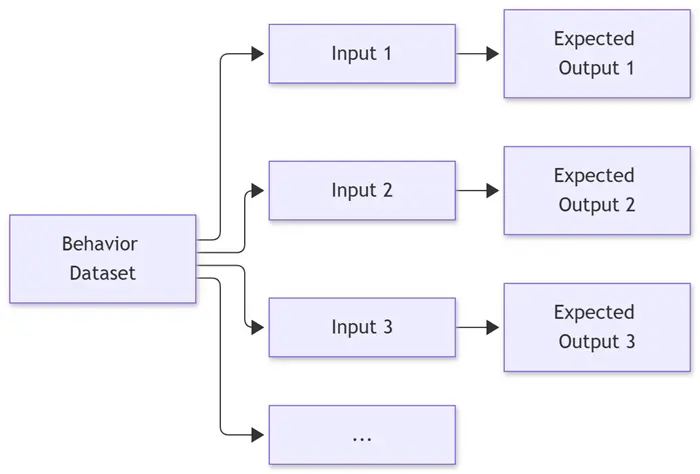
这些数据实际上描述了软件应该具有什么样的行为。
于是可以进一步产生一个想法:
软件的测试集,也可以看成软件行为的数据集。
软件每增加一个重要行为,就增加一个样本。
每发现一个 Bug,就可以增加一个回归样本。
如果一个 Bug 在真实环境中发生:
flowchart LR
    A[真实运行] --> B[发现 Bug]
    B --> C[记录输入与状态]
    C --> D[记录正确行为]
    D --> E[新的测试样本]
    E --> F[回归测试]
那么这个 Bug 就不只是一次事故。
它还可以成为软件模型下一轮优化的数据。
8、仿真环境可能成为软件模型的训练环境
如果真实环境太昂贵、太危险或者速度太慢,就可以使用仿真环境产生大量行为数据。
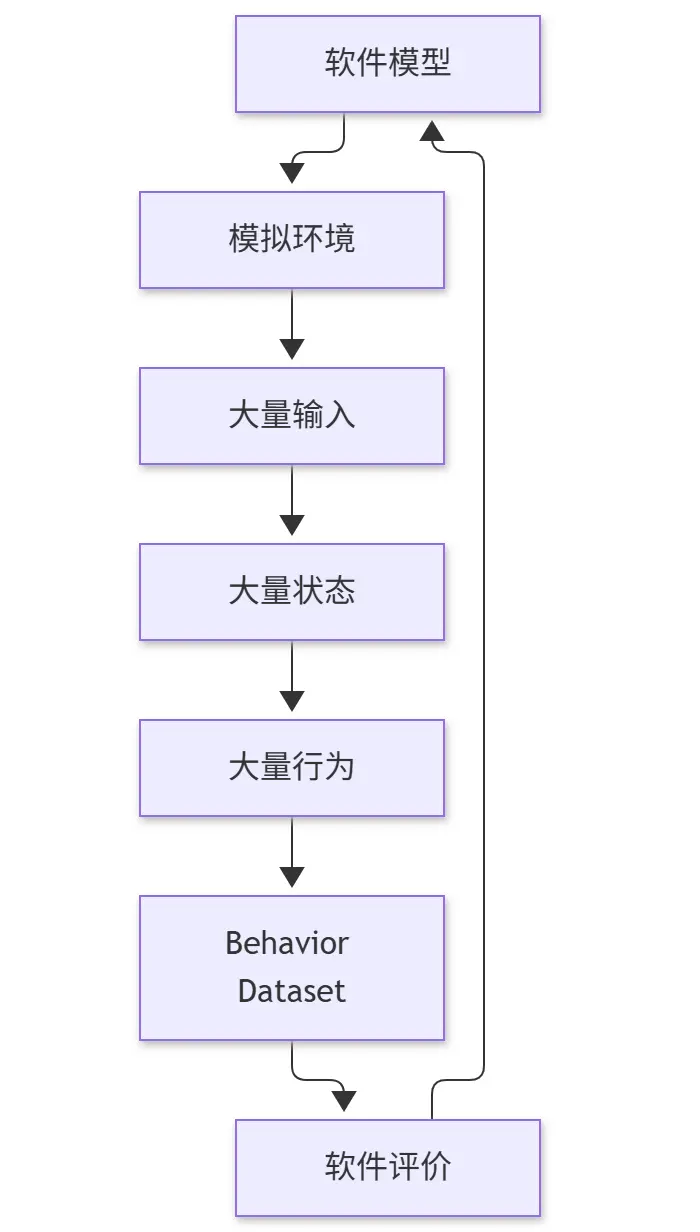
这时候,仿真器不再只是开发工具。
它可以成为:
软件模型的训练和评价环境。
这与机器人、自动驾驶等领域使用模拟环境训练模型的思路也有相似之处。
9、真正困难的是:如何定义“误差”
如果软件可以优化,那么一个自然的问题就是:
软件的 Loss 是什么?
机器学习里可以定义:
Loss = Prediction - Target软件却复杂得多。
一个程序可能同时需要满足:
- 功能正确
- 性能达标
- 安全
- 资源占用合理
- 接口兼容
- 可维护
- 不破坏已有行为
因此软件的评价可能是多维度的:
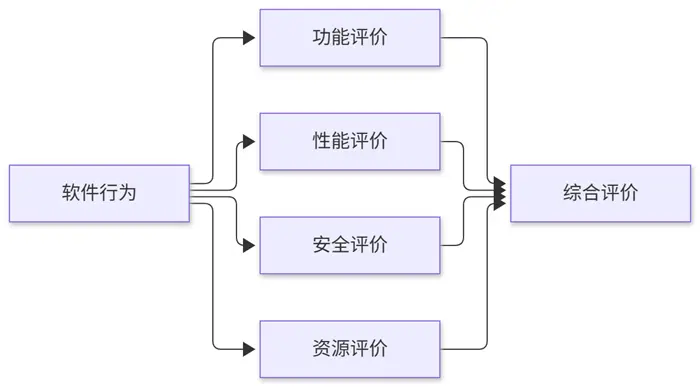
所以软件模型的“训练”可能不是简单地最小化一个数字。
更可能是:
在一组行为、约束和评价指标下寻找满足要求的软件模型。
10、Coding Agent 可能改变这个过程
如果软件真的可以被看作模型,那么 Coding Agent 的意义可能就不只是“帮助程序员写代码”。
传统的软件开发中,人参与整个优化闭环:

而 Coding Agent 可以逐渐进入这个闭环:
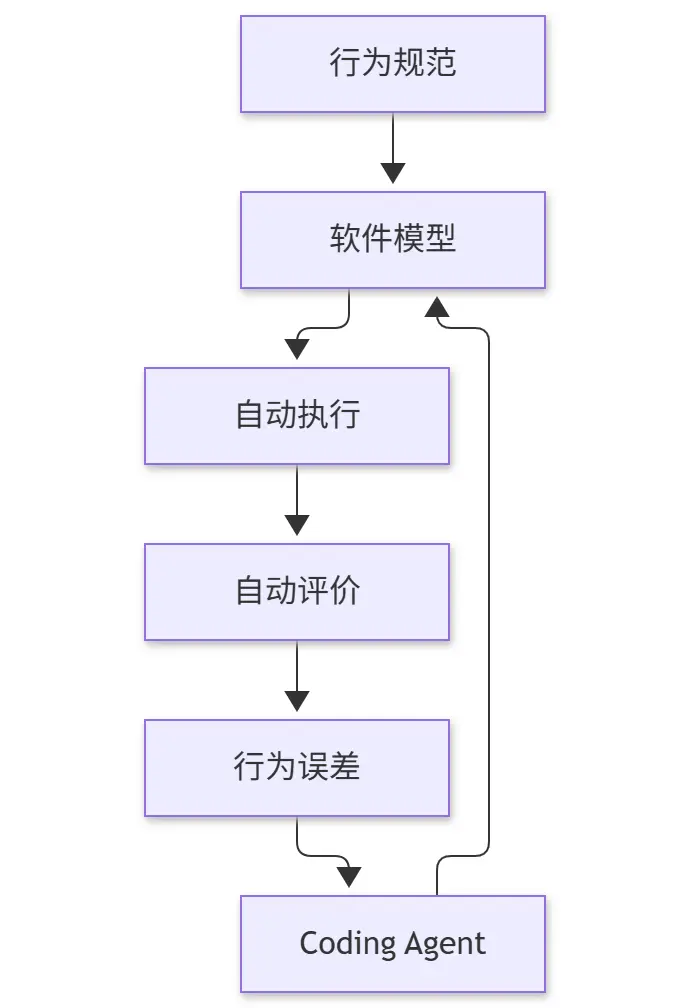
Agent 可以:
- 根据需求生成程序
- 执行程序
- 运行测试
- 分析失败案例
- 定位错误
- 修改程序
- 再次执行
- 判断是否达到要求
于是 Agent 的工作对象就不再是“某一个函数”。
它优化的是:
整个软件模型的行为。
这可能是 Coding Agent 更值得关注的地方。
它不只是提高程序员写代码的速度,而可能逐渐把原本依赖人工完成的软件优化闭环自动化。
11、从“人写代码”到“人定义行为”
如果这种趋势继续发展,人的角色可能发生变化。
传统方式是:
人 → 设计程序 → 编写代码 → 测试 → 修改而另一种可能的方式是:
人 → 定义行为和约束

Agent → 生成程序
      → 执行
      → 测试
      → 分析误差
      → 修改
      → 重复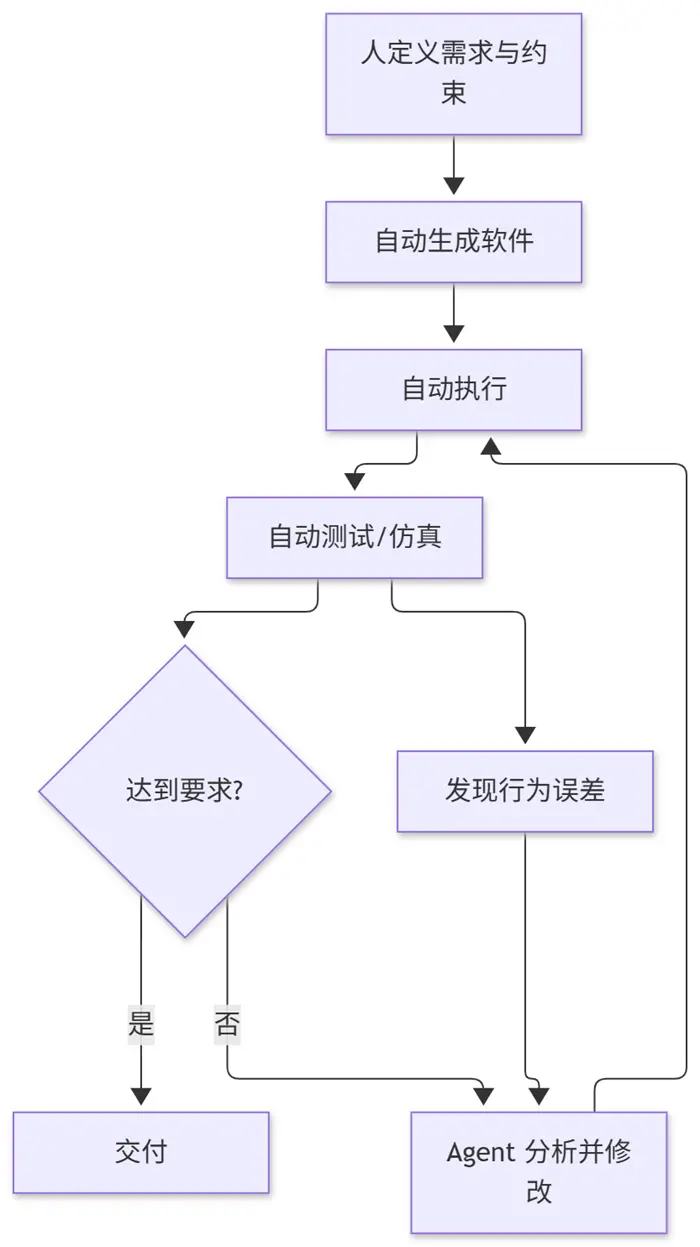
这并不意味着所有软件都可以立即采用这种方式。
很多软件需求仍然很难形式化,测试覆盖也不可能天然完整,安全性、架构质量和长期维护等问题也很难完全自动评价。
但如果越来越多的软件可以被描述为:
输入 + 状态 + 期望行为 + 约束 + 评价标准
那么软件开发中越来越多的环节就有可能进入自动优化循环。
12、软件工厂可能因此发生变化
传统的软件工厂,本质上还是人在生产软件。
如果“软件即模型”的思路进一步发展,那么软件生产可以逐渐变成:

这里真正需要人的,可能越来越集中在:
- 定义需求
- 定义正确行为
- 定义约束
- 提供测试数据
- 判断哪些结果是可以接受的
而生成和优化软件模型的过程,则可以越来越自动化。
最终甚至可以想象这样一种软件工厂:
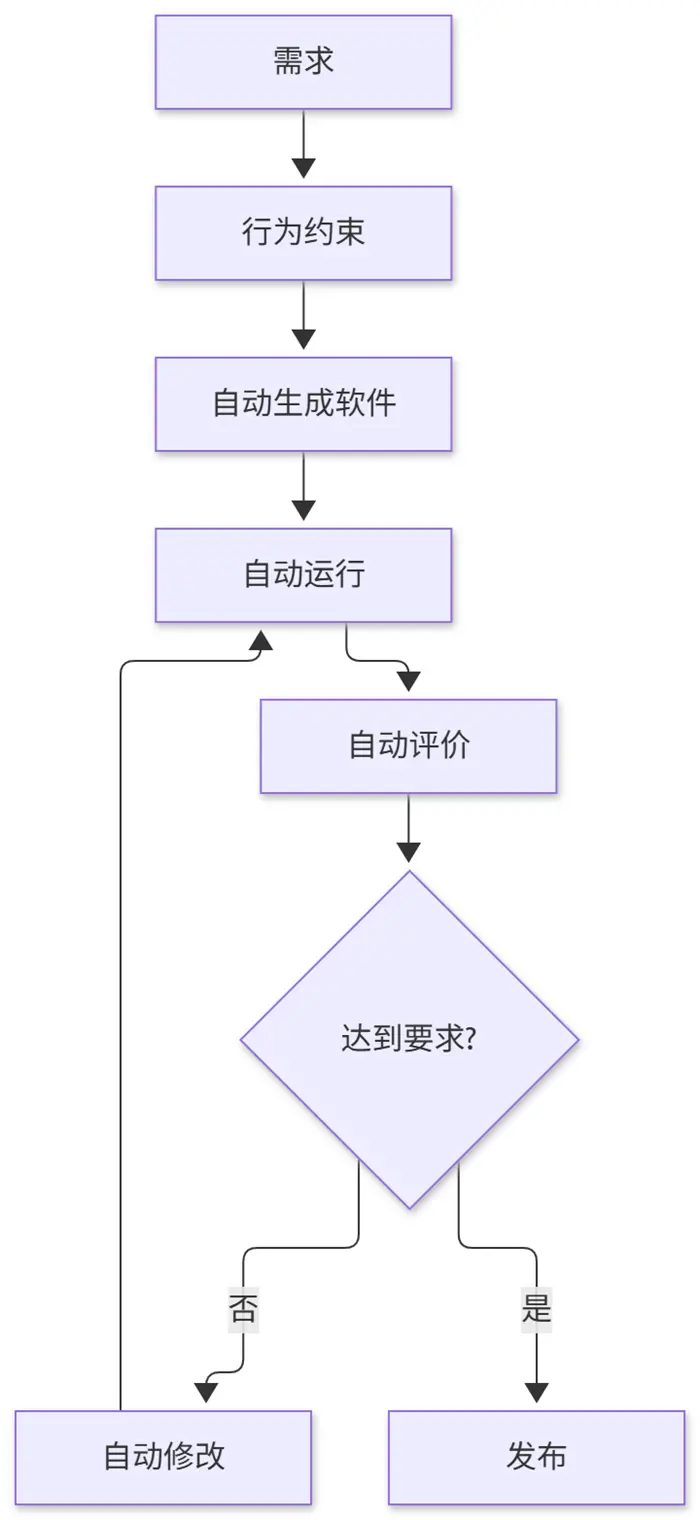
这时候,“程序员”这个角色本身也可能发生变化。
未必是简单地从“程序员”变成“没有程序员”,而可能是:
软件生产中需要人工参与的部分不断减少,而机器负责的搜索、生成、测试和优化部分不断增加。
13、一个更简单的抽象
如果把整件事情压缩成一句话,可以得到:
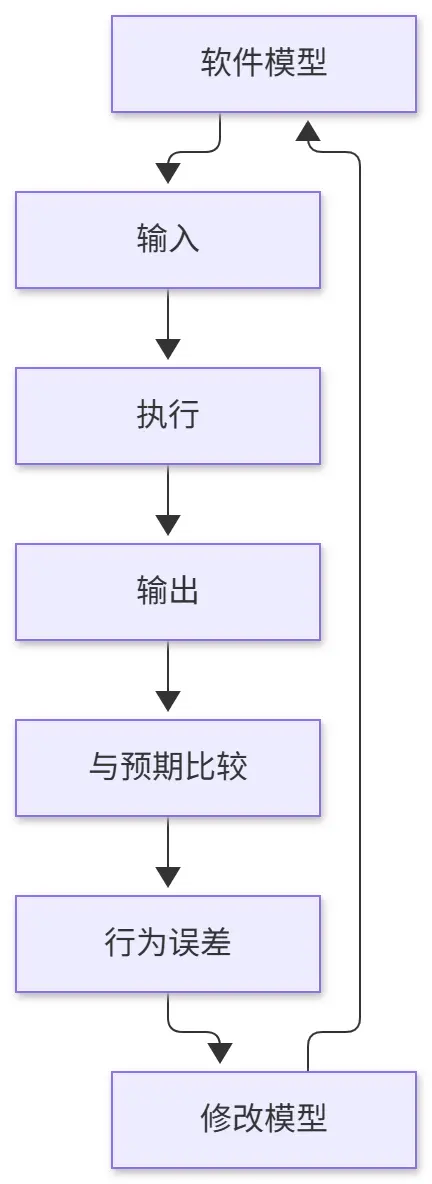
这其实就是一个反馈系统。
软件开发可以被看成:
不断减少软件模型与目标行为之间的差距。
从这个角度看:
- 代码是模型的一种表示
- 测试是行为数据
- Bug是行为误差
- 回归测试是历史行为约束
- 仿真器是模型评价环境
- Coding Agent是模型优化器
- 软件开发是模型优化过程
14、还有一些值得继续思考的问题
如果把软件真正当成模型,还有很多问题值得研究:
14.1 什么是软件的完整输入?
对于一个简单函数,输入很容易定义。
但对于操作系统、Web 服务、控制系统,一个软件的输入可能包括:
- 用户输入
- 网络数据
- 时间
- 外部设备
- 系统状态
- 历史状态
- 并发事件
因此,“输入”本身就是一个需要定义的问题。
14.2 什么是正确输出?
很多软件并不存在唯一正确答案。
例如搜索引擎、推荐系统、编译器优化器,都可能存在多个合理结果。
14.3 如何定义软件的 Loss?
功能、性能、安全、资源、可维护性之间可能互相冲突。
14.4 如何从错误直接得到修改方向?
发现错误比较容易。
但:
“哪里错了”如何自动转换成“应该怎样修改程序”?
这可能是 Coding Agent 最重要的问题之一。
14.5 如何避免过拟合?
如果软件只针对测试集优化,可能出现“测试通过,但真实环境失败”。
这意味着软件同样存在某种意义上的:
行为泛化问题。
15、Software as a Model
所以,目前我更愿意把“软件即模型”看成一个观察软件的新角度,而不是一个已经完整建立的理论。
Program Synthesis、Programming by Example、Program Repair、Test-Driven Synthesis、Software 2.0 等研究,都已经从不同方向触及了其中的一部分。
但把这些现象放到一起,可以得到一个比较简单的抽象:
软件是一种产生行为的模型。
那么:
软件开发就是构建和优化这个模型的过程。
而当 Coding Agent 能够自己完成:
生成 → 执行 → 评价 → 找到行为误差 → 修改 → 再执行
软件生产就可能逐渐从一种高度依赖人工的活动,变成一种持续的自动优化过程。
这也许是“Software as a Model”最值得继续思考的地方。
不是代码会不会被 AI 写出来。
而是:
当软件可以被描述、执行、评价和持续优化之后,软件生产本身是否也会像模型训练一样,变成一个可以不断自动运行的过程。
汇智网原创,转载请标明出处