APPLICATION
TurboOCR:优化杰作
设置并不容易。但当这个工具是对的工具时,它会以 10 倍的优势碾压竞争对手
APPLICATION
设置并不容易。但当这个工具是对的工具时,它会以 10 倍的优势碾压竞争对手
OCR
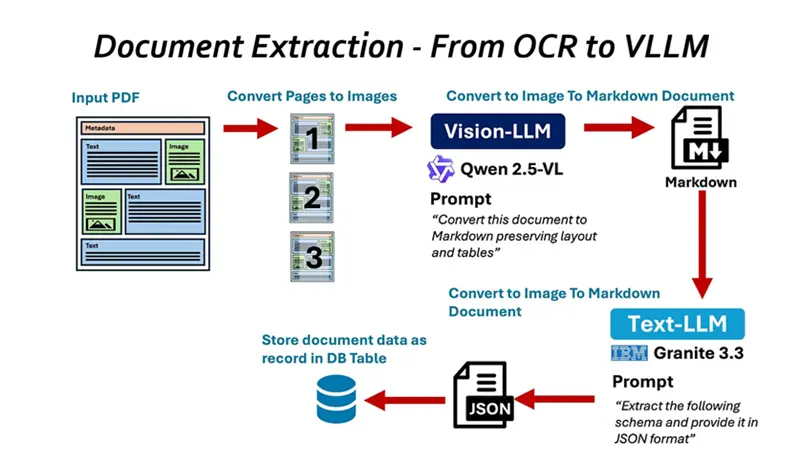
从构建医疗结果传真处理系统PoC中学到的经验教训,用视觉-LLM和Markdown转换替换OCR 背景

MODEL-ZOO
有四个开源项目脱颖而出:DeepSeek-OCR、Olmo-OCR 2、Qwen3-VL 和 Dots.OCR。它们的作用相同(读取文档),但方式却截然不同。

MODEL-ZOO
与其他模型使用YOLO风格的检测器加上语言模型不同,dots.ocr只使用一个VLM来处理布局检测、文本解析、阅读顺序,甚至公式。

MODEL-ZOO
MonkeyOCR是一个视觉语言模型,能够智能地解析收据、发票、表格和其他无结构的文档图像,将其转换为干净的结构化数据。

LIBRARY
SmolDocling用一种更智能、更具布局意识的方法取代了传统的OCR,这种方法能够理解文档。

LIBRARY
你是否曾经花数小时手动将数据从PDF复制到电子表格中?或者尝试从扫描文件中提取表格,结果却得到一个格式混乱得让你怀疑人生的职业选择?

MODEL-ZOO
olmOCR在250,000页的数据集上微调了Qwen2-VL-7B-Instruct模型,旨在将PDF和文档图像转换为干净且结构化的纯文本。

LIBRARY
我探索了各种 OCR 工具和服务,并根据它们的特点(例如价格、准确性和实施工作量)将它们分为三个不同的类别:生成式AI、视觉AI和开源库。

MODEL-ZOO
你使用的 OCR 可能无法满足你的特定需求。在这种情况下,微调 OCR 引擎是可行的方法。在本教程中,我将向你展示如何微调 EasyOCR。
MODEL-ZOO
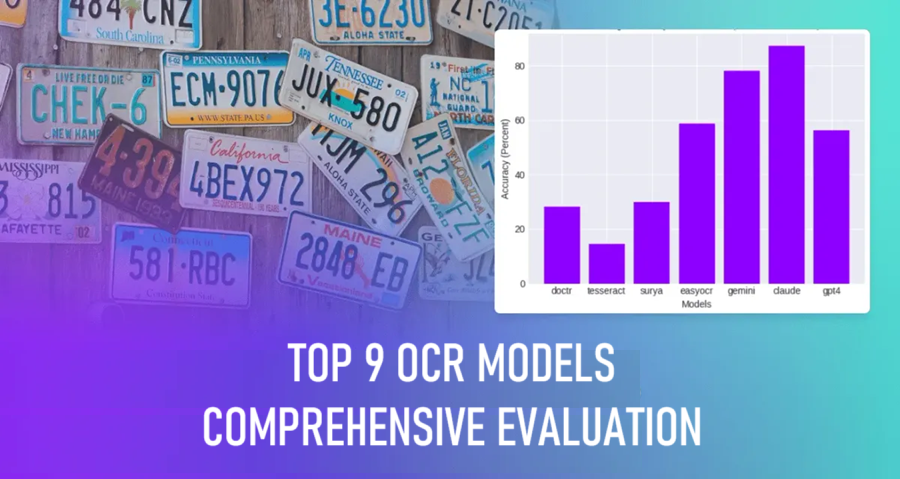
在这篇博文中,我们比较了9种不同的 OCR 解决方案,并比较了它们在工业 OCR 应用的10个不同领域的功效。

MODEL-ZOO
通过使用自定义数据集(例如知名的 VQA)对 PalliGema2 进行微调,可以在高度特定的任务上实现最先进的性能,以连续且可扩展的方式弥合文本和视觉理解之间的差距。