物理 AI 技术栈 (2026)
物理AI技术栈包含四层——感知层、世界模型层、策略网络层和动作执行层——每一层都需要根本不同的训练数据。
梯形图转SCL | 博途AI辅助编程文档 | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI | ElevenLabs | KlingAI | ArtSpace | Phot.AI | InVideo
一个机器人拿起杯子并将其放在架子上时,同时执行四个不同的计算层。每一层都有自己的架构、自己的训练数据需求和自己的故障模式。本文将介绍完整的技术栈。
核心要点:
- 物理AI技术栈包含四层——感知层、世界模型层、策略网络层和动作执行层——每一层都需要根本不同的训练数据。
- 感知模型(Depth Anything V2、SAM 2、ViTPose)需要标记的感官数据;它们可以在大型公共数据集上预训练,并使用较小的领域特定数据集进行微调。
- 策略网络(OpenVLA、Octo、GR00T N1)需要通过机器人遥操作收集的观察-动作-指令三元组——这是技术栈中最难且最昂贵的数据。
- 世界模型需要大规模多样化视频来学习物理先验;跨不同环境的自我中心视频提供了互联网视频在操作场景中缺乏的分布广度。
0、技术栈概述:四层架构
当机械臂伸向咖啡杯时,它执行的管道从光子击中相机传感器到电流流过伺服电机——在100毫秒内完成。该管道涉及四个不同的计算层,每一层都有自己的训练范式和数据要求。
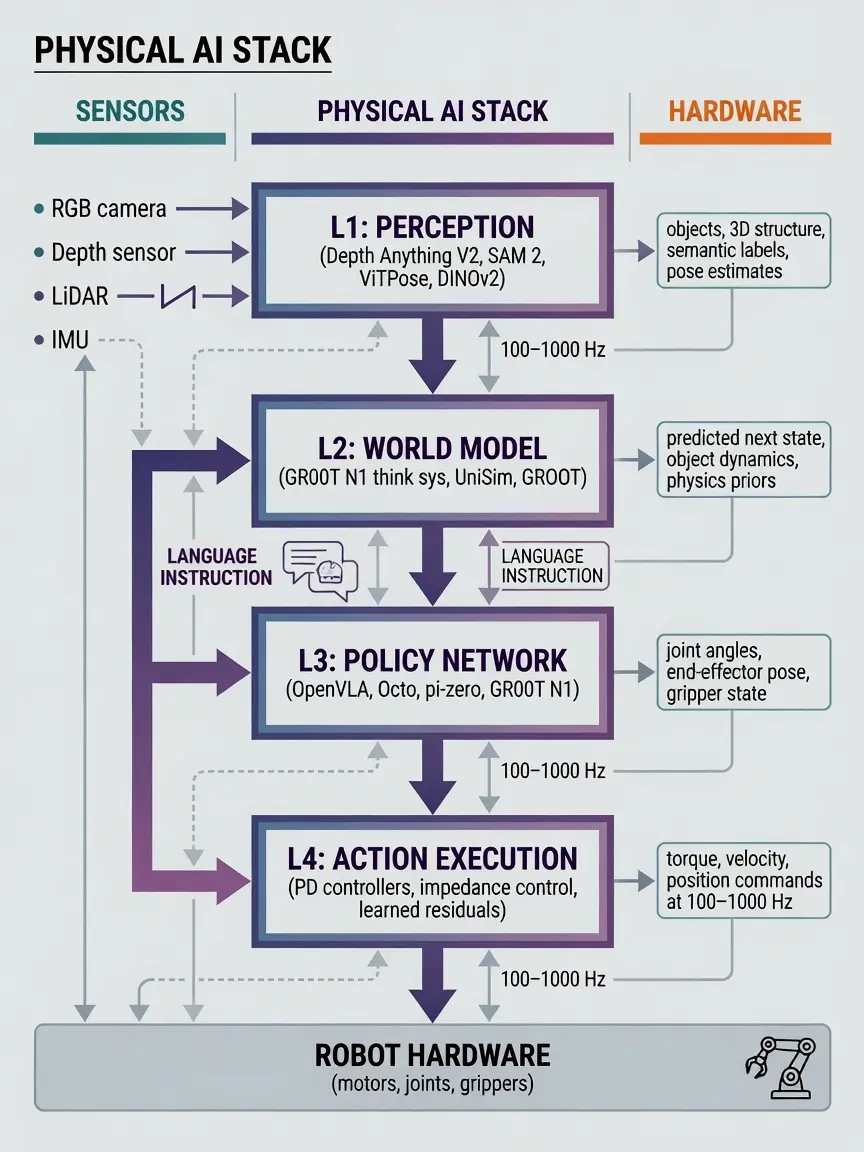
这种分层结构并非任何单一机器人架构独有——它描述了从自动驾驶汽车到人形机器人等几乎所有物理AI系统如何组织其计算。各层可以分别训练并组合,也可以端到端联合训练。2026年的大多数生产系统使用混合方法:感知层在大型公共数据集上预训练,世界模型在大型视频语料库上训练,策略在特定任务的机器人轨迹数据上微调。
1、第1层:感知层
感知层接收原始传感器输入——RGB图像、深度帧、LiDAR点云、IMU读数——并将它们转换为技术栈其余部分可以推理的结构化表示:物体位置、3D场景几何、语义标签和智能体姿态。
感知层是在大型公共数据集上预训练最可行的层,因为训练信号(真值标签)可以使用应用于现有图像的自动生成工具生成。
1.1 Depth Anything V2 — 单目深度估计
Depth Anything V2(香港大学,2024)从单个RGB图像生成逐像素深度估计。它在高质量标记深度数据和62M未标记图像(由教师模型伪标记)的混合数据上训练。结果是一个深度估计器,无需深度传感器硬件即可跨环境泛化,使其对仅使用RGB相机的机器人很有价值。对于训练数据:基础模型需要逐像素深度注释(来自LiDAR、结构光或立体相机);伪标记管道将覆盖范围扩展到任何RGB图像。
1.2 SAM 2 — 分割与跟踪
SAM 2(Meta AI,2024)通过单个提示(点击、边界框或掩码)跨视频帧分割和跟踪对象。对于机器人技术,这实现了跨操作序列的零样本对象跟踪,无需特定对象训练。SAM 2在SA-1B(1B+掩码)和SA-V(50K+带时空掩码的视频)上训练。训练数据要求是大规模掩码注释——而非动作标签——使其收集成本远低于策略训练数据。
1.3 ViTPose — 人体与手部姿态估计
ViTPose(微软研究院,2022)是基于Vision Transformer的姿态估计模型,在人体和手部关键点检测上都取得了强劲性能。对于机器人技术,手部姿态估计对于从自我中心视频理解操作特别重要——它 enables 将人手轨迹重定向到机器人夹爪姿态。ViTPose需要具有2D和3D关节注释的数据集:COCO-WholeBody、MPII、Human3.6M和InterHand2.6M是主要的训练来源。
该层的训练数据要求: 具有真值结构注释的标记感官数据。关键挑战是视觉多样性——在实验室图像上训练的感知模型在具有不同光照和对象类型的新部署环境中表现不佳。
2、第2层:世界模型
世界模型学习环境动态的内部表示:给定当前状态和提议的动作,接下来会发生什么?对于机器人,这意味着理解对象在操作下的行为——杯子如何在桌面上滑动,布料被抓取时如何变形,堆叠对象如何响应接触。
世界模型支持规划:机器人不是对每个观察做出反应,而是可以在心理上模拟候选动作序列并选择预测成功的序列。这是反应式策略和深思熟虑智能体之间的计算差异。
为物理AI训练世界模型的主要方法是视频预测:在大型视频语料库上训练,根据过去的帧和(可选的)动作输入预测未来的帧。模型必须学习类似物理的动力学才能做出准确的预测,发展出对物体恒存性、重力、接触和刚性的隐式表示。
2.1 GR00T N1的双系统架构
GR00T N1(NVIDIA,2025)使用双系统架构:基于Eagle2 VLM的"思考"系统用于高级场景理解和任务规划(作为任务级推理的世界模型),以及基于扩散Transformer的"行动"系统用于生成运动轨迹。思考系统在NVIDIA的视频语料库上预训练——包括EgoScale自我中心视频计划——为其提供了关于物理世界行为的广泛先验。
该层的训练数据要求: 大规模多样化视频,偏好显示物理交互的内容:被拿起、放置、推动、丢弃和操作的对象。互联网视频是一个合理的起点,但存在重要差距——它以拍摄内容而非第一人称操作为主,并且低估了对机器人技术最重要的近距离手-物交互。来自人类执行日常操作任务的自我中心视频填补了这一空白。
3、第3层:策略网络
策略网络是物理AI技术栈中数据最饥渴的层,也是最难收集的数据。它接收来自感知层的结构化状态表示、世界模型的预测和自然语言指令,并生成机器人应执行的动作序列。
策略训练数据必须采用观察-动作-指令三元组的形式:在每个时间步,机器人观察到什么、遵循什么指令以及采取了什么动作。这需要物理收集演示——通过机器人遥操作或人类演示重定向到机器人的动作空间。
策略网络的标准公共训练语料库是Open X-Embodiment数据集:来自21个研究机构的22个机器人实现的1M+轨迹。OpenVLA在970K轨迹子集上预训练。Octo使用相同的数据。对于特定任务的微调,大多数团队使用其特定机器人硬件在其部署环境中收集额外的演示。
2026年该层的关键模型:
- OpenVLA(7B参数): 在970K Open X-Embodiment轨迹上预训练的开源VLA。微调实验的最佳开源选择。
- Octo(93M参数): 来自伯克利的更小、更快的VLA。以20+ Hz运行;实时控制实验的良好基线。
- pi-zero(Physical Intelligence): PaliGemma主干 + 用于灵巧双臂任务的流匹配动作专家。专有权重。
- GR00T N1(NVIDIA): 人形机器人的基础模型,具有Eagle2 VLM思考系统和扩散Transformer动作专家。
4、第4层:动作执行层
动作执行层将来自策略的高级动作目标(末端执行器姿态目标、期望关节配置、夹爪命令)转换为在硬件上以100-1000 Hz运行的低级电机命令——远快于策略网络的运行速度。
该层在学习策略和物理现实之间的接口处运行。即使来自策略的完美指定的末端执行器姿态目标也必须通过逆运动学转换为关节扭矩,然后由考虑电机动力学、齿轮比和关节限制的伺服控制器跟踪。
大多数当前的物理AI系统在该层使用经典控制——PD控制器、阻抗控制器或针对特定硬件调优的模型预测控制器。该层学习的作用小于L1-L3:它主要用于残差学习(纠正经典控制器中的系统误差)和特定硬件的校准。
该层的训练数据要求: 特定硬件的校准数据:电机特性、关节编码器校准、摩擦力识别。这些数据不会跨机器人平台转移,必须为每次部署重新收集。数量很少(数百到数千次校准运行),但特定性要求是绝对的。
5、技术栈总结表
| 层级 | 输出 | 训练数据 | 关键模型 |
|---|---|---|---|
| L1:感知层 | 结构化场景表示(对象图、3D结构、语义标签) | 标记的感官数据:图像 + 深度/分割/姿态注释;10K-1M+标记帧 | Depth Anything V2, SAM 2, ViTPose, DINOv2, R3M |
| L2:世界模型层 | 预测的下一状态、对象动力学、物理先验 | 带可选动作标签的大型视频语料库;多样化多环境视频;数百万视频片段 | GR00T N1(世界模型组件), UniSim, GROOT |
| L3:策略网络层 | 动作序列(关节角度、末端执行器姿态、夹爪状态) | 机器人轨迹数据:观察-动作-指令三元组;50K-1M+轨迹 | OpenVLA, pi-zero, Octo, GR00T N1(策略组件) |
| L4:动作执行层 | 硬件频率的低级电机命令(扭矩、速度、位置) | 特定硬件的校准数据、传感器特性;因硬件而异(数百到数千次校准运行) | PD控制器、阻抗控制器、学习的残差动力学 |
6、各层训练数据:差距在哪里
四层技术栈的数据供应并不均匀。一些层有丰富的公共训练数据;其他层面临真正的稀缺。了解差距在哪里有助于团队优先考虑收集工作。
L1:感知数据 — 相对充足
存在大型公共数据集:NYU-Depth V2、SUN RGB-D、COCO-Panoptic、KITTI等。差距在于部署环境的视觉多样性——生产机器人遇到学术数据集未涵盖的光照、对象和杂乱。特定领域的丰富视频无需团队从头收集和注释即可填补这一空白。
L2:世界模型数据 — 中等差距
互联网视频大规模存在,但低估了第一人称操作:对学习操作物理重要的近距离手-物交互。Ego4D(3,670小时)和EPIC-Kitchens部分解决了这个问题,但对多样化环境、工业任务和户外操作的覆盖很薄。
L3:策略数据 — 显著差距
这是关键瓶颈。Open X-Embodiment提供1M+轨迹,但覆盖的任务类型、环境和机器人实现有限。DROID在564个环境中添加了76K轨迹以实现更好的泛化,但可用的策略训练数据总量与生产部署所需相比仍然很小。每个构建生产物理AI系统的团队都必须为他们的特定任务收集额外的演示。
L4:动作执行数据 — 特定硬件,不共享
校准数据不会跨平台转移。每个团队为自己硬件收集这些数据。数量很少;差距不在于数量而在于系统性努力——许多团队跳过严格的硬件校准,遇到实际上归因于L3的L4问题导致的下游策略故障。
7、关键要点
- 物理AI技术栈有四层(感知层、世界模型层、策略网络层、动作执行层),每一层都有不同的架构、训练数据要求和故障模式。
- 感知数据(标记的感官输入)通过公共数据集相对充足;差距在于部署环境的视觉多样性,丰富的现实世界视频可以填补。
- 世界模型数据需要多样化的第一人称操作视频——互联网视频低估了近距离手-物交互;大规模自我中心视频填补了这一空白。
- 策略数据(观察-动作-指令三元组)是关键瓶颈:Open X-Embodiment提供1M+轨迹作为基础,但生产部署仍需收集特定任务和特定环境的演示。
- 动作执行依赖于特定硬件且不可转移的校准数据——系统校准经常被忽视,是未解释的部署失败的常见原因。
- 实际意义:构建物理AI系统的团队需要将数据收集策略映射到特定的技术栈层,而不是将"机器人训练数据"视为单一的未分化类别。
原文链接: The Physical AI Stack: From Raw Sensor Data to Robot Action (2026)
汇智网翻译整理,转载请标明出处