3D 高斯泼溅转纹理网格
Python 教程:把训练好的森林小屋 3D 高斯泼溅转成坚固、带纹理的 .glb,可以在 Blender 中打开、测量、编辑和 3D 打印。每一步都在 CPU 上运行,约 93 秒完成——包括过滤成点云、网格化和烘焙真实纹理。无需云服务,无需专有导出,无需 GPU。
先来一段引子:
曾经生活过的一切,几乎都消失得无影无踪。
我们真正知道的那些生物——博物馆里的那些——是极少数恰好在正确时刻被掩埋的。矿物质一点一点渗进它们的软组织,逐个细胞地把有机物替换成了石头(这是简化说法,但你懂我的意思)。
仔细想想:脆弱的原体腐烂了,但是石头复制品存活了 6600 万年。
这个过程有个名字:化石化(fossilization)。
而这正是你即将对一个 3D 高斯泼溅做的事情。
因为我想让我们直面一个关于你训练出的那个漂亮泼溅的残酷事实:
它是软组织。
它只存在于高斯光栅化器内部;一旦你想在 Blender、游戏引擎或 3D 打印机里用到它,就需要各种变通手段。
"如果它只存在于渲染器里,你就还没有真正拥有它。"
这是我反复念叨的一句话。
泼溅是一次租来的体验,壮观却不可触碰(暂时还不行 ;) )。带纹理的网格则是一块化石:坚固、可移植,而且在任何工具里永远属于你。
所以本教程用 Python 从头到尾完成这次掩埋和矿化。
我们会拿一个真实训练好的森林小屋泼溅——21 MB 文件里有 84,528 个高斯——把它变成 6.59 MB 的带纹理 .glb。全程在 CPU 上运行,每个数字都是实测的,不是宣称的。
它也属于更大的图景。这是我"本地拥有你的 3D 流水线"系列的第四篇教程,填补了前几篇留下的空白:
当你的起点不是视频或照片集,而是一个你已经训练好的泼溅时,该怎么办。
1、如何最大化利用本教程
这是一份实战教程,不是综述。你看到的每个函数都来自同一个脚本,它在真实的小屋泼溅上端到端运行,文中打印出的数字就是它为我打印出来的数字。
我会这样使用它:
慢慢读代码块,因为所有的判断都藏在那里:为什么不透明度要用 sigmoid,为什么四元数必须跟着位置一起旋转,为什么我们采样椭球体而不是保留中心。
然后今晚就运行脚本,看着同样的数字出现。
还要对问题的形态有心理准备:把泼溅变成网格不是什么灵光一现的技巧,而是一连串扎实的小步骤,结果的质量取决于你对每一步的尊重。
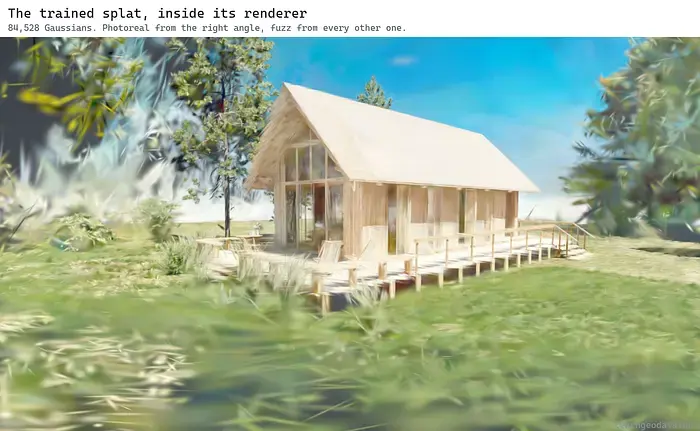
你将带走的是完整的策略:泼溅的解剖结构、人人都会遇到的上下颠倒修正、不透明度与尺度过滤、球谐解码为 RGB、椭球体致密化、网格化,以及带 UV 展开的正规纹理烘焙。
代码和数据链接在文末。
2、从 3D 高斯泼溅到 3D 网格
先讲为什么,因为只有"为什么"讲通了,"怎么做"才有意义。
泼溅赢下了"看起来惊艳"的比赛。但看看你实际能用它做什么:
你可以绕着它转。很不错!清单到此(为止)。
不用些巧办法,你没法(可靠地)在里测量一面墙。你没法切割它、打印它,或把它扔进 Unreal 当碰撞面。甚至明年你可能都打不开它——如果你依赖的查看器停止维护的话。泼溅与它的渲染器同生共死。
带纹理的网格则是另一种物体。它能在过去 25 年里制造的每一种 3D 工具中打开。
它把颜色携带在同一个文件里。这是"到访的场景"和"拥有的场景"之间的区别。
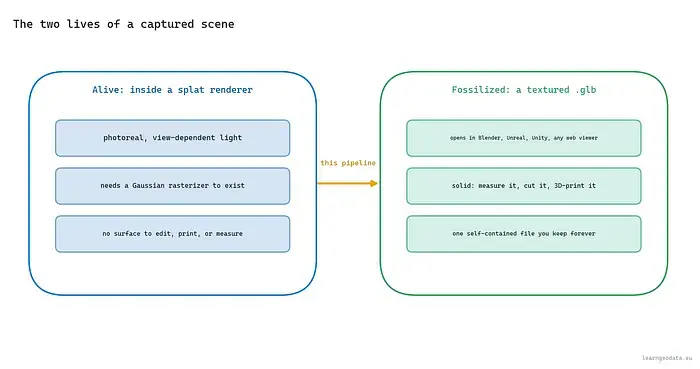
有一整类网络服务会收费替你做这个转换,同时在他们的服务器上保留一份你场景的副本。而它们每一个跑的都是下面这套流水线的某个版本。
那为什么要租?数学已经有几十年历史,库是免费的,你的笔记本就够了。
因为一旦流水线属于你,它就会产生复利。你训练的每一个泼溅——一个家、一处工地、一座雕塑、一段回忆——都会免费得到一块耐久的化石。
3、任务:把小屋变成化石
想象一下。多年前你在森林里的一间小屋度过了一个夏天,去年春天你拿着手机绕着它走了一圈,用素材训练了一个高斯泼溅。
结果很美:草地、白桦树,还有那座木板屋顶的小木屋,一切都漂浮在柔和的泼溅光线里。
但它被困住了。小屋下个月就要被卖掉,而你对这个地方唯一的 3D 记录是一个 21 MB 的 .ply——只有一类软件能显示它。
你的任务是把它化石化。把这个泼溅变成带纹理的网格,十年后还能在 Blender 中打开,在游戏引擎里走进去,或者按任意尺寸 3D 打印成纪念品。
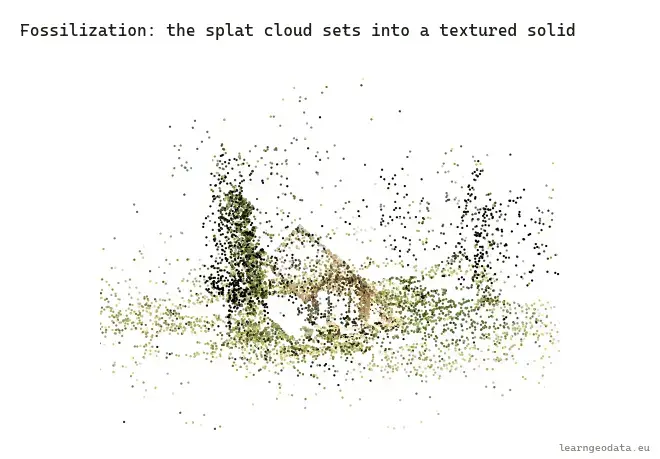
这些数据毫不虚构:这是一个真实训练好的泼溅,下面是它全部 84,528 个高斯画成的点。
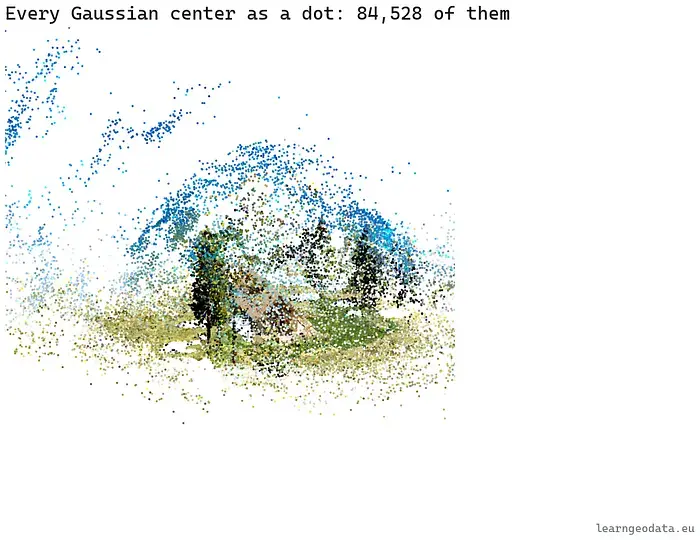
那么,从这团模糊到干净的带纹理实体,这条路到底长什么样?
4、工作流:从模糊到化石的八步
我喜欢能在脑子里装下的流水线,所以在写第一行代码之前,先把全貌放在一张图里。
读取泼溅并理解其解剖结构。把它扶正。把高斯过滤成可信的点并解码颜色。通过采样每个高斯的椭球体来致密化。清理点云并定向法线。求解泊松曲面并裁剪。把颜色转移到网格上。展开 UV、烘焙纹理、导出 .glb。
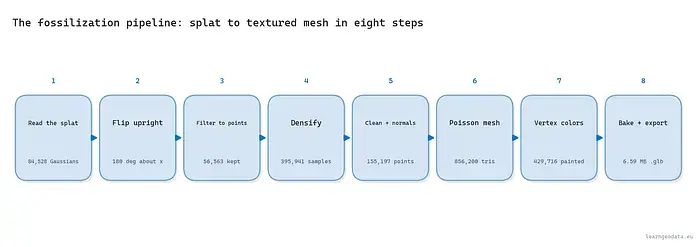
八步听起来很多。其实不多。我机器上纯 CPU 的总运行时间是 93 秒,其中大部分是纹理烘焙。
🪐 系统思维笔记: 这条流水线最深的想法,是把泼溅当作概率分布而不是点集。每个高斯都是一句小小的陈述:"这附近有表面质量,朝这个方向拉伸。"第 4 步对这些分布做采样,每个抽 6 次,把 56,563 句陈述变成 395,941 个点。这是应用于几何的蒙特卡洛思维,凡是你的数据描述密度而非位置的问题,它都适用。
贯穿一切的关键问题:每一步,文件到底给了我们什么,我们必须修正什么,下一步才能接受它?先搭好环境,然后一探究竟。
5、数据、代码与环境
在写第一个函数之前要搞定三件事:环境、数据集,以及我们将要解剖的文件的形状。
环境是 Python 3.10 或更新版本和六个库。Open3D 扛几何计算的重活,trimesh 写出最终的 .glb,plyfile 解析泼溅,SciPy 提供颜色转移用的 KD-tree,xatlas 负责 UV 展开。NumPy 把一切粘在一起,Matplotlib 贡献一个色彩空间辅助函数。
conda create -n splatmesh python=3.10
conda activate splatmesh
pip install open3d==0.19.0 trimesh==4.11.2 plyfile scipy xatlas numpy matplotlib
数据集就是训练好的小屋泼溅,一个 21 MB 的二进制 .ply。
如果你有自己从任何标准 3DGS 流水线训练的泼溅,它会完全一样地工作,因为格式处处相同:原始的 3D Gaussian Splatting 论文(Kerbl 等人)定义了它,之后每个训练器都沿用了它。
在解析之前,这个格式值得一张示意图,因为泼溅 .ply 不是点云——尽管它顶着同样的文件扩展名。每个"顶点"携带 62 个浮点数。
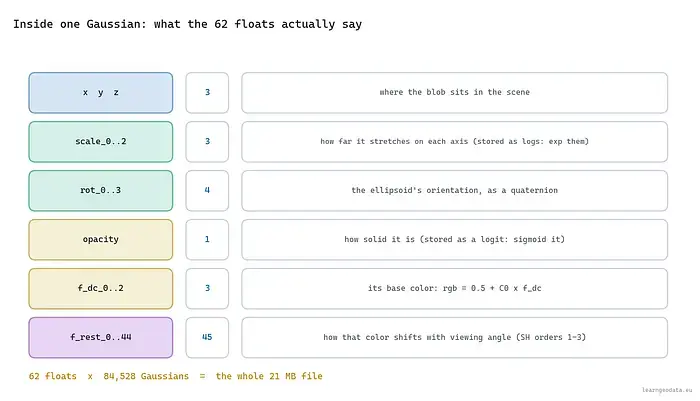
路上给一条排障提示。如果你的泼溅在普通查看器里打开是一团灰色点云,这是预期的:标准工具只读取 x, y, z,忽略其余部分,而且找不到 red, green, blue 属性。如果 open3d 干脆拒绝这个文件,就用 plyfile 按下面的方式解析。如果一切都渲染成上下颠倒——恭喜,你遇到了第 2 步存在的意义。
🦥 极客笔记: 用文件大小对照解剖结构做一次合理性检查:84,528 个高斯 × 62 个浮点数 × 4 字节 = 20.96 MB,磁盘上的文件是 21.0 MB。差值来自文件头。当格式如此原始时,算术就是你的第一个解析器:如果数字对不上,我会先怀疑存在额外元素或双精度,而不是直接读取数据。
字段映射到手了,现在真正读取它。
5.1 读取泼溅,认识它的 62 个浮点数
后面每一个决策都取决于理解这个文件存储了什么,所以第一个函数只做解析和报告。我们用 plyfile 而不是 Open3D,因为我们需要全部属性,而不只是位置。
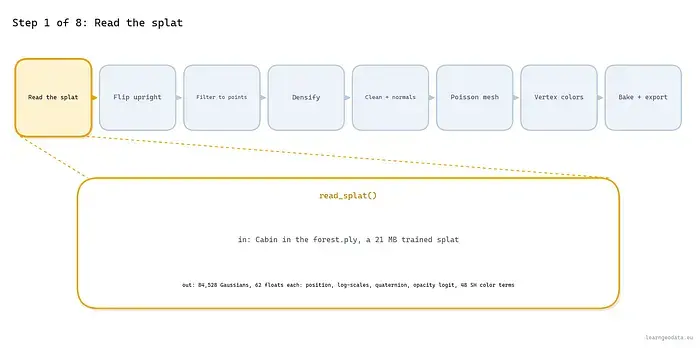
我们加载的结构与解剖图一一对应。位置出来是一个 (N, 3) 数组。三个尺度暂时保持对数空间,与存储时完全一致。四个四元数分量描述每个椭球体的旋转。不透明度是原始 logit。48 个球谐值中,我们保留三个 DC 项(基础色),跳过 45 个与视角相关的项。
def read_splat(path=SPLAT_FILE):
    el = PlyData.read(path).elements[0]
    d = el.data
    n = el.count
    names = d.dtype.names
    n_rest = sum(1 for k in names if k.startswith("f_rest_"))
    splat = {
        "xyz": np.column_stack([d["x"], d["y"], d["z"]]).astype(np.float64),
        "scales_log": np.column_stack([d["scale_0"], d["scale_1"],
                                       d["scale_2"]]).astype(np.float64),
        "quat": np.column_stack([d["rot_0"], d["rot_1"], d["rot_2"],
                                 d["rot_3"]]).astype(np.float64),
        "opacity_logit": np.asarray(d["opacity"], dtype=np.float64),
        "f_dc": np.column_stack([d["f_dc_0"], d["f_dc_1"],
                                 d["f_dc_2"]]).astype(np.float64),
    }
    ext = splat["xyz"].max(0) - splat["xyz"].min(0)
    _say("Step 1", f"{n} Gaussians, {len(names)} floats each "
                   f"(3 pos + 3 log-scale + 4 quat + 1 opacity + 3 SH DC + {n_rest} SH rest)")
    _say("Step 1", f"scene extent {np.round(ext, 2)} units, "
                   f"file {os.path.getsize(path)/1e6:.1f} MB")
    return splat
在小屋上它打印:84,528 个高斯,每个 62 个浮点数,场景范围 34.12 × 11.96 × 17.48 单位。注意"单位"这个词。泼溅根本不知道世界有多大;这些数字继承了相机求解器选定的任意尺度。本系列第一篇教程讲过如何恢复真实度量尺度,这里我们专注于泼溅特有的问题。
而第一个问题在你渲染刚加载的数据那一刻就出现了:为什么森林倒挂在天上?
5.2 把场景扶正,因为它颠倒了
这一步之所以存在,是因为几乎每个读者都会撞上它,而几乎没有教程教它。你的泼溅是颠倒的。这不是偶发 bug:几乎所有来自标准训练流水线的泼溅都是如此。
原因有历史渊源。COLMAP——为大多数泼溅训练提供种子的相机求解器——使用的约定是 y 轴朝下。泼溅训练器继承了它,导出的 .ply 保留了它,于是每一个 y 朝上的查看器(也就是大多数)、Blender,以及 glTF 本身,都会把你的场景显示成挂在天花板上。
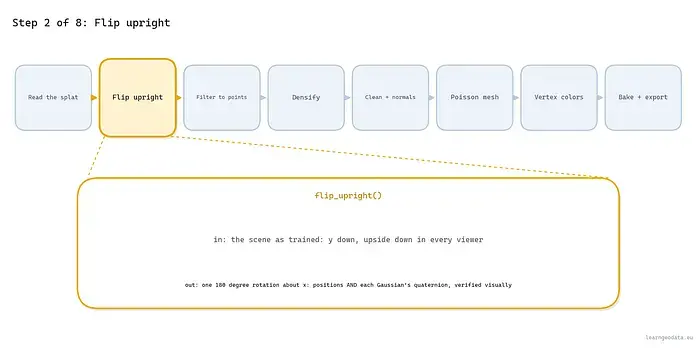
修复方式是绕 x 轴做一次 180 度旋转,也就是对 y 和 z 取反。但有个细节决定了修复是正确还是碰巧:每个高斯还携带自己的朝向四元数,如果你只旋转位置而不旋转四元数,每个小椭球在翻转后的场景里仍保持着原来的倾斜。对下面的点提取来说,这种损害很细微;但对之后任何渲染泼溅的场景,它会显现出来。两者都要旋转。
def flip_upright(splat):
    s = {k: v.copy() for k, v in splat.items()}
    s["xyz"][:, 1] *= -1.0
    s["xyz"][:, 2] *= -1.0
    # 180-degree rotation about x as a quaternion is (w=0, x=1, y=0, z=0).
    # Premultiply: q' = r * q  with Hamilton product, r = (0, 1, 0, 0).
    w, x, y, z = (s["quat"][:, 0], s["quat"][:, 1],
                  s["quat"][:, 2], s["quat"][:, 3])
    s["quat"] = np.column_stack([-x, w, z, -y])
    lo, hi = s["xyz"].min(0), s["xyz"].max(0)
    _say("Step 2", f"rotated 180 deg about x; y now spans "
                   f"{lo[1]:.2f} to {hi[1]:.2f} (ground low, canopy high)")
    return s
那行四元数代码像戏法,来拆穿它。把任意四元数 q = (w, x, y, z) 左乘绕 x 轴 180 度旋转 (0, 1, 0, 0),经 Hamilton 积展开后恰好是 (-x, w, z, -y)。就一行,不需要任何库。
还有一条比数学更重要的规则:用肉眼验证翻转。永远不要相信你没渲染过的变换。我用同一台相机在翻转前后各渲染了一次。
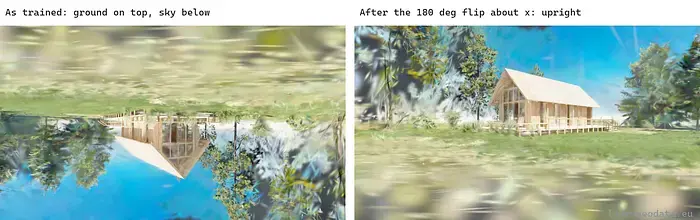
翻转后,y 的范围是 -0.93 到 11.03:地面在下,树冠在十一个单位之上。现在世界正过来了,我们怎么决定这 84,528 个高斯中哪些配得上成为点?
🦚 Florent 的笔记: 我把这次翻转看作一种成年礼。根据我的教学经验,颠倒的导出是初学者耗时最多的地方,因为它看起来像流水线坏了,其实只是两次符号翻转。所以在我自己的流水线里,面对任何新的 3D 格式,第一动作永远是"渲染出来看看",在做任何数值操作之前。在这个场景上,这个习惯只花 3 秒,却能一次性抓住朝向、镜像和单位灾难。
5.3 从高斯到可信的点
泼溅靠一些会毒害网格化的花招换来照片级效果,所以这一步是分诊。三个过滤器,再加一次颜色解码,每个过滤器的原因你都能在数据里看到。
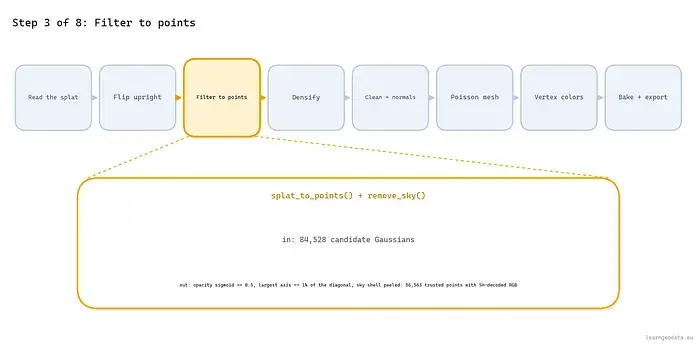
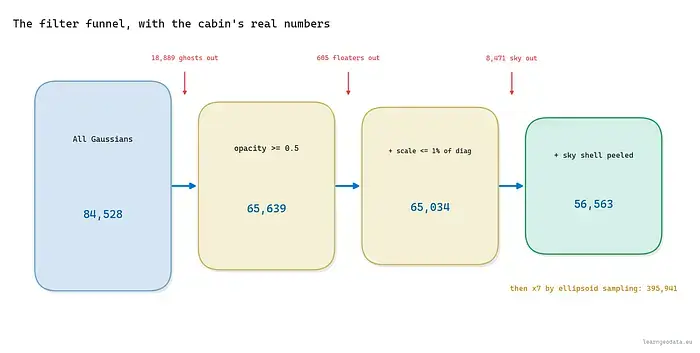
第一,不透明度。文件以 logit 形式存储它——网络输出的原始数字——所以用 sigmoid 拉回 0..1,丢掉低于 0.5 的。那些是幽灵:训练器用来伪造柔和光照和深度雾的半透明团块。在小屋上,84,528 个中保留了 65,639 个。
第二,尺度。存储的三个尺度是对数,所以 exp 一下得到每个椭球的真实轴长,然后丢掉最大轴超过场景对角线 1% 的高斯——这里是 0.40 单位。那些巨人是雾和天空的填充物,不是几何。仅此过滤器就保留 83,700 个,与不透明度合并后剩 65,034 个。
第三,颜色。SH DC 项不是 RGB,但零阶球谐只是常数 C0 = 0.2821,所以一个高斯从任何方向显示的基础色就是 0.5 + C0 * f_dc。一行代码,把 45 个视角相关项所代表的复杂度换算成一个诚实的漫反射色。
def splat_to_points(splat, opacity_min=OPACITY_MIN, scale_max_frac=SCALE_MAX_FRAC):
    n = len(splat["xyz"])
    opacity = 1.0 / (1.0 + np.exp(-splat["opacity_logit"]))
    keep_op = opacity >= opacity_min
    sigma = np.exp(splat["scales_log"])
    diag = np.linalg.norm(splat["xyz"].max(0) - splat["xyz"].min(0))
    keep_sc = sigma.max(axis=1) <= scale_max_frac * diag
    keep = keep_op & keep_sc
    rgb = np.clip(0.5 + SH_C0 * splat["f_dc"], 0.0, 1.0)
    _say("Step 3", f"opacity >= {opacity_min}: {keep_op.sum()} / {n} survive; "
                   f"scale <= {scale_max_frac:.0%} of diag ({scale_max_frac*diag:.2f} u): "
                   f"{keep_sc.sum()} / {n} survive; both: {keep.sum()}")
    return keep, rgb, sigma, opacity
我说了三个过滤器,目前你只看到两个。第三个是在这个场景上让我措手不及的。实际上,与其描述,不如直接给你看失败的样子:我给这个小屋建的第一个网格戴着一层蓝色外壳——一个牢牢熔在树冠上的实心天空穹顶。户外泼溅靠用蓝白色高斯包裹场景来"解释"天空,而其中许多完全不透明,所以不透明度过滤器会把它们直接放行。
修复方法读起来像天气预报。如果一个点高于场景的中位高度,且它的颜色说明"是天空"——饱和的蓝色色调,或者很亮但几乎无饱和度(那就是云)——那它就是天空。室内场景完全跳过这一步。
def remove_sky(splat, keep, rgb):
    from matplotlib.colors import rgb_to_hsv
    y = splat["xyz"][:, 1]
    high = y > np.median(y[keep])
    hsv = rgb_to_hsv(rgb)
    blue = (hsv[:, 0] > 0.45) & (hsv[:, 0] < 0.75) & (hsv[:, 2] > 0.45)
    cloud = (hsv[:, 1] < 0.18) & (hsv[:, 2] > 0.75)
    sky = keep & high & (blue | cloud)
    _say("Step 3b", f"sky shell: {sky.sum()} opaque sky/cloud Gaussians removed "
                    f"-> {(keep & ~sky).sum()} remain")
    return keep & ~sky
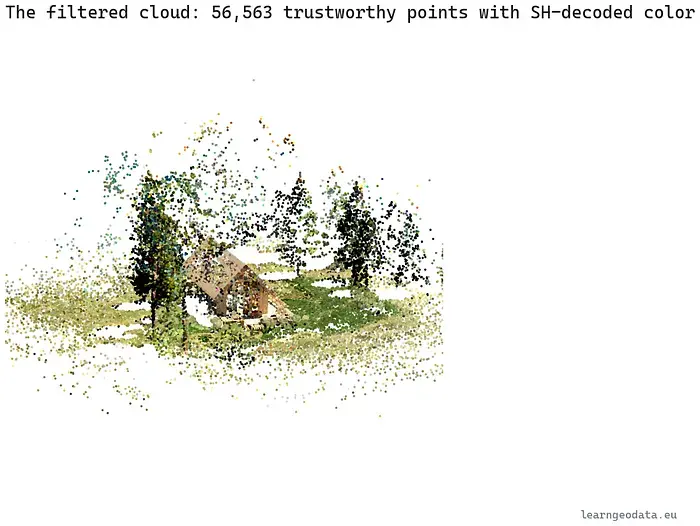
完整的漏斗,用小屋的真实数字:84,528 个候选,不透明度过后 65,639 个,尺度过后 65,034 个,剥掉顶部 8,471 个天空高斯后剩 56,563 个。
存活下来的是流水线第一个真正有用的产物:一个彩色点云,你已经可以导出它并在任何地方查看。
🦥 极客笔记: 0.5 的不透明度阈值是一个值得理解的判断。小屋的不透明度分布中位数是 0.88,所以大多数高斯要么是确凿的表面,要么是明显的雾。把阈值降到 0.3 会多放进 10,034 个高斯,主要是树缘绒毛,它们会在下游让树冠团块变厚。提高到 0.7 会再删掉 11,536 个,那就开始吃掉真实表面了。当一个阈值如此关键时,先打印直方图再决定。
不过,56,563 个点对这个尺寸的场景来说覆盖太薄。泊松重建能挺过去,但数据稀疏处表面会疙疙瘩瘩。泼溅本身提供了更好的交易。如果我们让每个高斯描述自己那一小块表面呢?
5.4 通过采样高斯椭球体致密化
这是大多数泼溅转网格转换器跳过的洞见:高斯不是一个带装饰的点。它是一个小小的密度椭球,被四元数旋转、被尺度拉伸,训练器优化这个椭球去贴合真实表面。只保留中心,等于把形状信息全扔了。
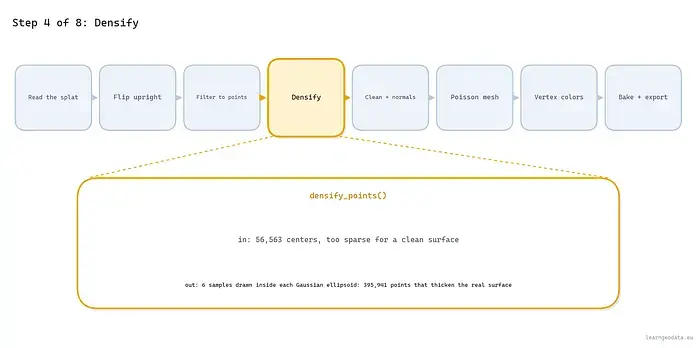
所以我们采样。对每个存活的高斯,从它真实的分布里抽 6 个点:标准正态样本,在 1.5 sigma 处截断(这样我们让表面变厚而不是变糊),用椭球的轴缩放,旋转到位,再平移到中心。样本继承父级的颜色。
def densify_points(splat, keep, rgb, sigma, per_splat=SAMPLES_PER_SPLAT):
    xyz = splat["xyz"][keep]
    q = splat["quat"][keep]
    q = q / np.maximum(np.linalg.norm(q, axis=1, keepdims=True), 1e-9)
    sig = sigma[keep]
    col = rgb[keep]
    n = len(xyz)
    # quaternion -> rotation matrices, vectorised
    w, x, y, z = q[:, 0], q[:, 1], q[:, 2], q[:, 3]
    R = np.empty((n, 3, 3))
    R[:, 0, 0] = 1 - 2 * (y * y + z * z); R[:, 0, 1] = 2 * (x * y - w * z); R[:, 0, 2] = 2 * (x * z + w * y)
    R[:, 1, 0] = 2 * (x * y + w * z); R[:, 1, 1] = 1 - 2 * (x * x + z * z); R[:, 1, 2] = 2 * (y * z - w * x)
    R[:, 2, 0] = 2 * (x * z - w * y); R[:, 2, 1] = 2 * (y * z + w * x); R[:, 2, 2] = 1 - 2 * (x * x + y * y)
    # samples in the Gaussian's own frame, clipped to 1.5 sigma
    local = np.clip(RNG.normal(0, 1, (n, per_splat, 3)), -1.5, 1.5) * sig[:, None, :]
    world = xyz[:, None, :] + np.einsum("nij,nkj->nki", R, local)
    pts = np.concatenate([xyz, world.reshape(-1, 3)], axis=0)
    cols = np.concatenate([col, np.repeat(col, per_splat, axis=0)], axis=0)
    _say("Step 4", f"{n} centers + {per_splat} samples each -> {len(pts)} points")
    return pts, cols
einsum 那行就是全部诀窍:它在一次向量化调用里把 56,563 个不同的旋转矩阵应用到 56,563 组不同的样本上,没有 Python 循环。输出是 395,941 个点,而这正是第 2 步四元数用心的地方得到回报的地方,因为这些旋转就是翻转过的那些。
也让数学变得直观而不是神秘。每个泼溅是一个小小的模糊椭球:三个尺度说绒毛在每个轴上伸多远,四元数说它朝哪边倾斜。所以我们采样绒毛,而不是只留中心。R 重建每个高斯的旋转,sig 把单位球噪声拉伸成正确的椭球,1.5 sigma 处的截断让每次抽样都落在分布的可信范围内。
参数是选出来的,不是猜的。K 是每个高斯 6 个样本,这是我实测的表面覆盖与下一步清理成本之间的平衡点。截断是 1.5 sigma,这样我们让表面变厚而不是变糊。而那些会炸成点雾的巨大天空高斯根本到不了这个函数,因为第 3 步的尺度上限已经丢掉了任何宽于 0.40 单位的东西。
并排看比任何论证都更能说明问题。同一块场景区域,左边是中心点,右边是采样出的"皮肤"。
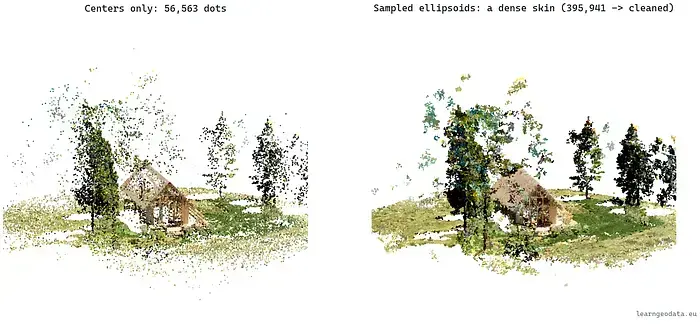
这层致密的皮肤真的值回它多出来的点吗,还是只是散点图看起来更好看?先记住这个问题。唯一诚实的回答方式是给两个点云都建网格、对比小屋,而这正是我们在第 6 步要做的。首先,我们怎么把 395,941 个略微毛糙的点整理成曲面求解器会喜欢的样子?
5.5 清理点云,赋予定向法线
采样分布有一个诚实的副作用:有些抽样落在表面之外,尤其是树缘那些半模糊的高斯。网格化之前我们做三个标准动作,在这份数据上每个动作都能在数字里看到。
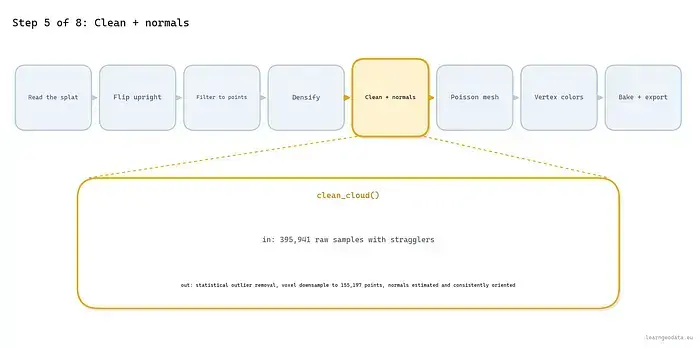
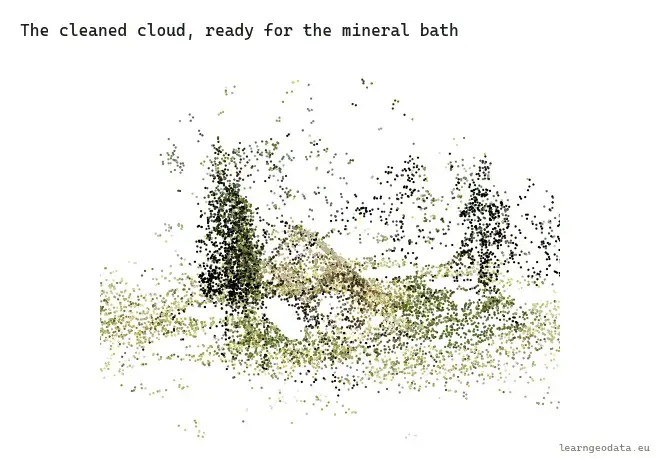
统计离群点移除测量每个点到其 20 个最近邻的平均距离,丢掉偏离人群超过 2 个标准差的点。这削掉 14,248 个落单者,把我们从 395,941 带到 381,693。然后体素下采样把密度均匀到 0.034 单位的网格上,落在 155,197 个点,这很重要,因为泊松更喜欢均匀间距而非原始数量。最后我们从局部邻域估计法线并使它们方向一致,让求解器能分清小屋的外面和里面。
def clean_cloud(pts, cols, target=VOXEL_TARGET):
    pcd = o3d.geometry.PointCloud()
    pcd.points = o3d.utility.Vector3dVector(pts)
    pcd.colors = o3d.utility.Vector3dVector(cols)
    n0 = len(pcd.points)
    pcd, _ = pcd.remove_statistical_outlier(nb_neighbors=SOR_NEIGHBORS,
                                            std_ratio=SOR_STD)
    n1 = len(pcd.points)
    diag = np.linalg.norm(pcd.get_axis_aligned_bounding_box().get_extent())
    voxel = diag / 900.0
    while len(pcd.points) > target:
        down = pcd.voxel_down_sample(voxel)
        if len(down.points) <= target:
            pcd = down
            break
        voxel *= 1.2
    radius = diag * 0.008
    pcd.estimate_normals(o3d.geometry.KDTreeSearchParamHybrid(radius=radius, max_nn=30))
    pcd.orient_normals_consistent_tangent_plane(20)
    _say("Step 5", f"outliers: {n0} -> {n1}; voxel {voxel:.3f} u -> "
                   f"{len(pcd.points)} points with oriented normals (radius {radius:.3f})")
    return pcd
法线搜索半径随场景缩放,为包围盒对角线的 0.008,这里算下来是 0.246 单位。这种自适应意味着同一个函数不用重新调参就能用于小雕像泼溅或建筑泼溅。定向那一遍——orient_normals_consistent_tangent_plane——是函数里最慢的一行,也是你不能跳过的一行:泊松读的是向量场,不是点集。
🌱 成长笔记: 这一步跑通之后值得做的升级:把第 4 步的样本数改成自适应,而不是固定 6 个。给每个高斯一个与其表面积成正比的预算,大致是它两个最大轴的乘积,这样一块宽墙板能挣到十几次抽样,而一根松针碎片只挣到一次。尺度分布证明了其合理性:在这个场景上,中位高斯的最大轴是 0.05 单位,而最大的存活者伸到 0.40,面积相差 64 倍,固定预算完全无视这一点。
现在点云具备了曲面求解器想要的一切:致密、均匀、定向、诚实。是时候进矿化浴了。
5.6 泊松网格化,以及诚实的备选方案
这是全矿化(permineralization)的时刻:一个连续的实体像矿物生长进埋藏的组织一样,生长过整个点云。工具是 screened 泊松重建,出自经典的 Kazhdan 与 Hoppe 论文,它求解一个全局方程,得到一个梯度跟随我们定向法线的水密曲面。
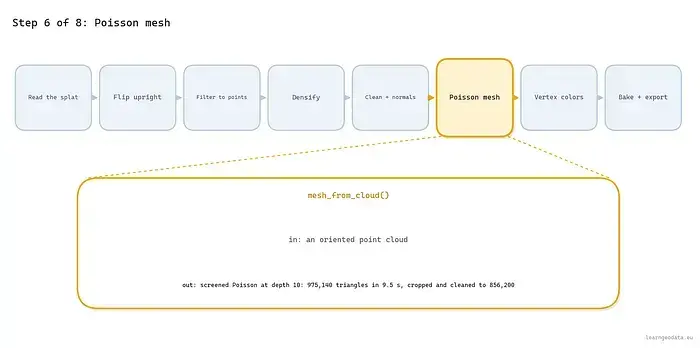
深度是关键参数:它设定求解器工作的八叉树分辨率。这个点云在深度 10 下,CPU 上 9.5 秒产出 488,731 个顶点和 975,140 个三角形。因为泊松坚持封闭曲面,它也会在无数据区域吹起一层薄气球,而它的密度输出准确告诉我们哪些三角形属于这种情况。我们裁掉密度最低的 5.5%,保留最大连通分量,丢掉退化的残渣:剩下 429,716 个顶点、856,200 个有数据支撑的三角形。
def mesh_from_cloud(pcd, depth=POISSON_DEPTH, quantile=DENSITY_QUANTILE):
    t0 = time.time()
    mesh, dens = o3d.geometry.TriangleMesh.create_from_point_cloud_poisson(
        pcd, depth=depth)
    dens = np.asarray(dens)
    raw = (len(mesh.vertices), len(mesh.triangles))
    keep = dens >= np.quantile(dens, quantile)
    mesh.remove_vertices_by_mask(~keep)
    cl, ntri, _ = mesh.cluster_connected_triangles()
    cl = np.asarray(cl); ntri = np.asarray(ntri)
    if len(ntri) > 0:
        mesh.remove_triangles_by_mask(cl != int(ntri.argmax()))
        mesh.remove_unreferenced_vertices()
    mesh.remove_degenerate_triangles()
    mesh.remove_duplicated_triangles()
    mesh.remove_duplicated_vertices()
    mesh.remove_non_manifold_edges()
    mesh.compute_vertex_normals()
    _say("Step 6", f"Poisson depth={depth}: {raw[0]} verts / {raw[1]} tris "
                   f"in {time.time()-t0:.1f}s -> cleaned to {len(mesh.vertices)} "
                   f"verts / {len(mesh.triangles)} tris (q={quantile})")
    return mesh
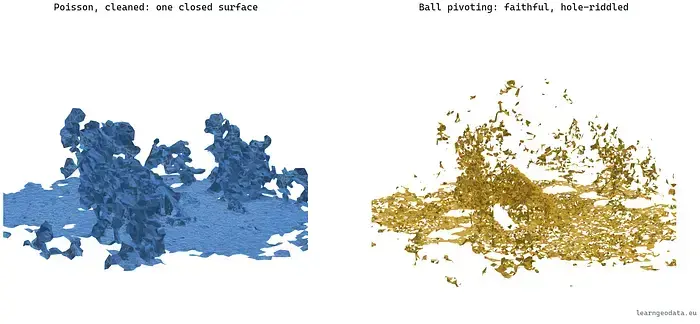
泊松是唯一选择吗?不是,而且备选方案值得一次公平、有测量的试验,而不是一句打发。球轴法(ball pivoting)让一个虚拟球滚过点,只连接真实的点,所以它从不凭空发明表面。我在完全相同的点云上跑了它。
def ball_pivot_reference(pcd):
    """Measured, not asserted: how ball pivoting behaves on the same cloud."""
    d = np.mean(pcd.compute_nearest_neighbor_distance())
    radii = [d * 1.5, d * 3.0, d * 6.0]
    t0 = time.time()
    m = o3d.geometry.TriangleMesh.create_from_point_cloud_ball_pivoting(
        pcd, o3d.utility.DoubleVector(radii))
    _say("Step 6b", f"ball pivoting: {len(m.vertices)} verts / "
                    f"{len(m.triangles)} tris in {time.time()-t0:.1f}s")
    return m
在泼溅数据上,判决是决定性的。球轴法 3.4 秒产出 153,514 个三角形,泊松是 975,140 个——差别不在于抽稀,而在于缺席:在泼溅提供的模糊、采样不均的"皮肤"上,滚动的球在停不下来的地方留下遍地窟窿。这么疏松的曲面没法贴纹理,也没法打印。在清晰的 LiDAR 扫描上,球轴法能保住泊松会抹圆的边缘;在泼溅点云上,泊松毫无悬念地赢了。
现在是我在第 4 步承诺的试验。椭球采样到底值不值,还是光用中心就够了?一个函数就能定案:完全相同的"清理+网格化"链条,只喂给它 56,563 个高斯中心。这正是多数快速泼溅转换器实际网格化的点云。
def centers_only_reference(splat, keep, rgb):
    """Measured, not asserted: what Step 4 buys us. This runs the IDENTICAL
    clean + Poisson chain, but fed only the 56,563 Gaussian centers (no
    ellipsoid sampling). The mesh it produces is the one most quick splat
    converters ship, so meshing both clouds lets the cabin cast the verdict."""
    t0 = time.time()
    pcd = clean_cloud(splat["xyz"][keep], rgb[keep])
    mesh = mesh_from_cloud(pcd)
    _say("Step 6c", f"centers-only reference: {keep.sum()} centers -> "
                    f"{len(pcd.points)} cleaned points -> "
                    f"{len(mesh.triangles)} tris in {time.time()-t0:.1f}s total")
    return mesh
先看数字。仅中心:56,563 个点清理后剩 54,614 个,泊松后 338,342 个三角形,耗时 5.2 秒。椭球采样:395,941 个点变成 155,197 个,再变成 856,200 个三角形,整条"致密化-清理-泊松"分支耗时 15.2 秒。所以采样路径用 10 秒额外 CPU 买到了 2.5 倍的有支撑表面。
但三角形计数是抽象的。看小屋。
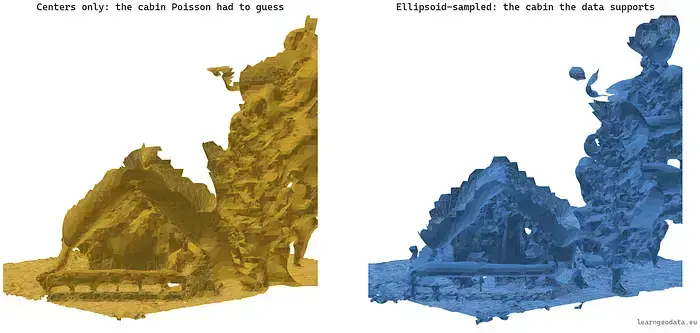
这就是判决,也是为什么椭球采样是本流水线的推荐路径,而不是可选的点缀。仅用中心的小屋不是同一栋房子的粗糙版本;它是求解器不得不凭七分之一的证据发明出来的房子——墙是它猜的,屋顶是它吹瘪的。本文中每一个下游产物——顶点色、纹理、最终的 .glb——都来自采样分支。
🦚 Florent 的笔记: 深度 10 是我处理场景级泼溅的默认值,实验我替你做了:同一片点云上,深度 11 耗时 45.5 秒产出 1,003,446 个三角形,而深度 10 耗时 9.5 秒产出 975,140 个。将近五倍的算力换来多 2.9% 的三角形——瓶颈不是求解器,是输入。泼溅里从来没有深度 11 能恢复的更细细节。
我们现在有了一块小屋场景的坚固、水密、朝向正确的化石。有一个问题:它是石膏的颜色。颜色去哪了?
5.7 把颜色还给表面
泊松在求解过程中凭空造出顶点,所以它们都不带颜色。但我们求解所用的点云携带着全部颜色,而且两个物体占据同一空间。修复方法是查找:对每个网格顶点,找到最近的带色点云点并混合。
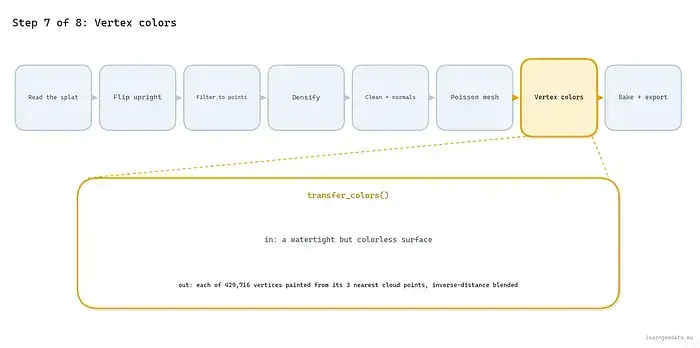
单个最近邻可行,但在点云颜色逐点变化的地方会产生斑点——在植被上到处都是。用三个邻居按反距离加权混合,能平滑掉斑点而不冲淡真实边缘,SciPy 的 KD-tree 让整个查询几乎瞬间完成。
def transfer_colors(mesh, pcd, k=3):
    cloud = np.asarray(pcd.points)
    ccol = np.asarray(pcd.colors)
    v = np.asarray(mesh.vertices)
    dist, idx = cKDTree(cloud).query(v, k=k, workers=-1)
    w = 1.0 / np.maximum(dist, 1e-9)
    w = w / w.sum(axis=1, keepdims=True)
    vc = (ccol[idx] * w[..., None]).sum(axis=1)
    mesh.vertex_colors = o3d.utility.Vector3dVector(np.clip(vc, 0, 1))
    _say("Step 7", f"colors blended onto {len(v)} vertices "
                   f"(k={k} nearest, inverse-distance weights)")
    return mesh
workers=-1 参数把查询并行到每个核心,这就是为什么从 155,197 个点的点云给 429,716 个顶点上色只需要 0.31 秒。视觉回报是立竿见影的:石膏模型又变回了小屋。
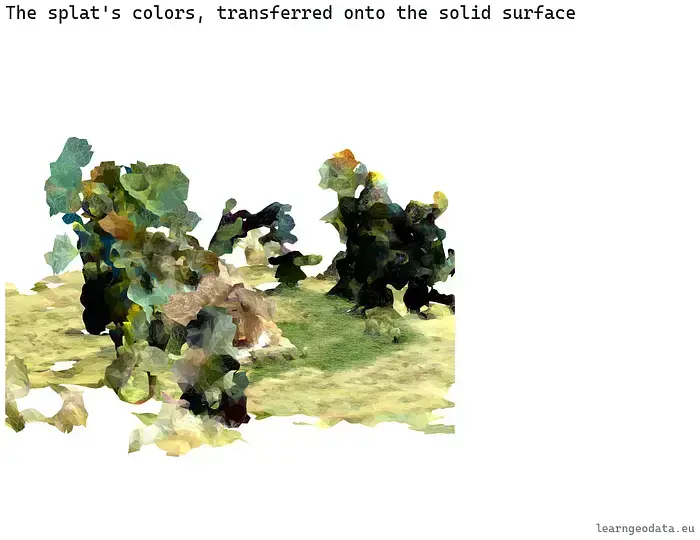
所以我们可以到此为止,导出一个带顶点色的网格。不少教程就这么做。但顶点色是一种脆弱的外观载体:它们活在几何上,所以任何人对你的化石做抽稀、重网格或重拓扑,颜色就会扭曲或消失。游戏引擎和渲染器期望外观活在纹理里。要正确烘焙一张纹理需要什么?
5.8 烘焙真实纹理并导出 .glb
这一步把演示和资产区分开来,分两半:展开与烘焙。展开把 3D 表面切成平面岛屿并打包进方形 UV 空间,我们把这活交给 xatlas——与生产级游戏流水线用的同一个库。烘焙则把顶点色画进由这些 UV 布局的实际图像里。
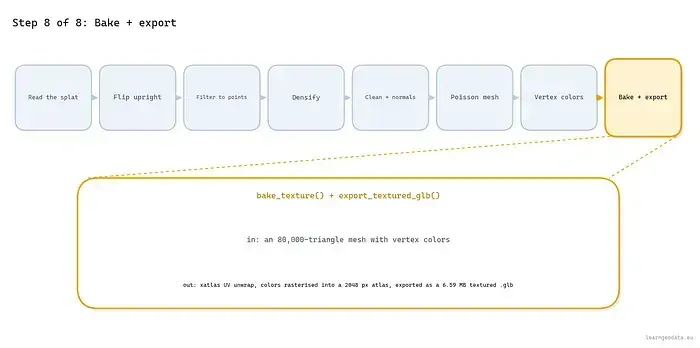
先做一项诚实的准备:我们在展开前抽稀到 80,000 个三角形——不是因为烘焙要求,而是因为一旦颜色住进纹理,856,200 个三角形的展开要花好几分钟却毫无视觉收益。这正是纹理允许、而顶点色禁止的那种取舍。
烘焙本身值得细读,因为它揭开了引擎通常隐藏的东西。对每个 UV 三角形,我们光栅化它的像素足迹,按重心插值三个角点颜色,然后写进图像。之后一道膨胀处理把每个岛屿的边缘颜色向外渗进空白的沟槽,这样纹理过滤就永远不会采样到黑色接缝。
def bake_texture(mesh, max_tris=BAKE_TRIANGLES, tex_size=TEXTURE_SIZE):
    import xatlas
    if len(mesh.triangles) > max_tris:
        mesh = mesh.simplify_quadric_decimation(max_tris)
        mesh.compute_vertex_normals()
    v = np.asarray(mesh.vertices)
    f = np.asarray(mesh.triangles).astype(np.uint32)
    vc = np.asarray(mesh.vertex_colors)
    vmap, faces, uvs = xatlas.parametrize(v.astype(np.float32), f)
    v2, c2 = v[vmap], vc[vmap]
    img = np.zeros((tex_size, tex_size, 3), dtype=np.float32)
    hit = np.zeros((tex_size, tex_size), dtype=bool)
    px = uvs * (tex_size - 1)
    for tri in faces:
        p, c = px[tri], c2[tri]
        x0, y0 = np.floor(p.min(0)).astype(int)
        x1, y1 = np.ceil(p.max(0)).astype(int) + 1
        xs, ys = np.meshgrid(np.arange(x0, x1), np.arange(y0, y1))
        d = (p[1,0]-p[0,0])*(p[2,1]-p[0,1]) - (p[2,0]-p[0,0])*(p[1,1]-p[0,1])
        if abs(d) < 1e-12:
            continue
        w1 = ((xs-p[0,0])*(p[2,1]-p[0,1]) - (p[2,0]-p[0,0])*(ys-p[0,1])) / d
        w2 = ((p[1,0]-p[0,0])*(ys-p[0,1]) - (xs-p[0,0])*(p[1,1]-p[0,1])) / d
        w0 = 1.0 - w1 - w2
        inside = (w0 >= -1e-4) & (w1 >= -1e-4) & (w2 >= -1e-4)
        col = w0[...,None]*c[0] + w1[...,None]*c[1] + w2[...,None]*c[2]
        img[ys[inside], xs[inside]] = col[inside]
        hit[ys[inside], xs[inside]] = True
    for _ in range(8):                       # bleed island edges into gutters
        empty = ~hit
        for dy, dx in ((0,1), (0,-1), (1,0), (-1,0)):
            src_h = np.roll(hit, (dy, dx), axis=(0, 1))
            src_i = np.roll(img, (dy, dx), axis=(0, 1))
            fill = empty & src_h
            img[fill] = src_i[fill]
            hit |= fill
            empty = ~hit
    tex = Image.fromarray((np.clip(img, 0, 1) * 255).astype(np.uint8)[::-1])
    return v2, np.asarray(faces, dtype=np.int64), uvs, tex
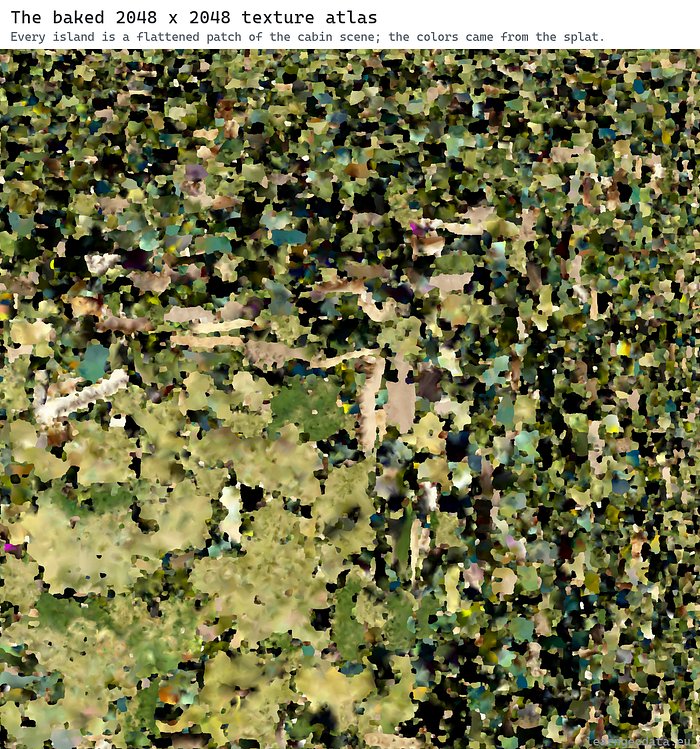
在小屋上,xatlas 把 40,520 个顶点变成了 73,925 个——因为展开会在接缝切割处复制顶点——整个展开耗时 53.1 秒,是流水线里单个最耗时的操作。烘焙在 8 轮膨胀后填满了 100% 的图集纹素。图集本身是个奇特而美丽的物件:整片森林,被切成平整的岛屿。
导出是一圈轻松的胜利巡游。我们把几何、UV 和纹理打包进一个 glTF PBR 材质——金属度为 0、粗糙度全满,一个哑光的照片纹理表面——写出一个自包含的二进制文件。
def export_textured_glb(v, f, uvs, tex, out_glb):
    material = trimesh.visual.material.PBRMaterial(
        baseColorTexture=tex, metallicFactor=0.0, roughnessFactor=1.0)
    visual = trimesh.visual.TextureVisuals(uv=uvs, material=material)
    tm = trimesh.Trimesh(vertices=v, faces=f, visual=visual, process=False)
    tm.export(out_glb)
    _say("Step 9", f"exported {os.path.basename(out_glb)} "
                   f"({len(f)} tris, {os.path.getsize(out_glb)/1e6:.2f} MB, "
                   f"{tex.size[0]}x{tex.size[1]} texture inside)")
    return out_glb
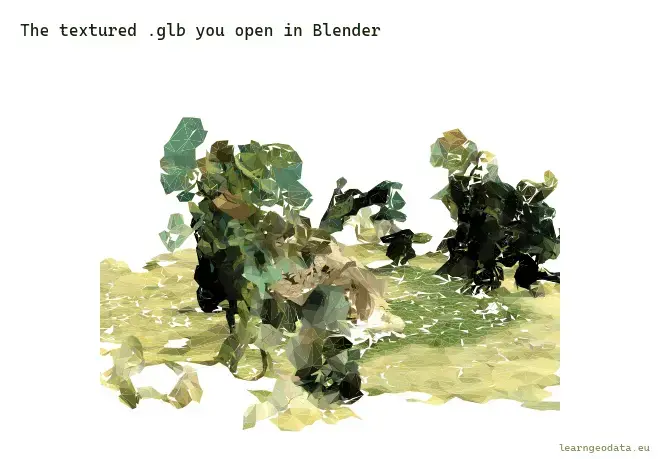
结果是 cabin_textured.glb:79,999 个三角形、6.59 MB,内含完整的 2048 像素纹理。把它拖进 Blender,导入器不用你吩咐就把一切做对了:glTF 的 y 朝上与我们在第 2 步做的翻转一致,所以场景正着到达;纹理落在 Principled BSDF 的 Base Color 插槽里,已经接好线。到 Shading 选项卡检查:一个材质,一个图像节点,完事。
🦥 极客笔记: 为什么是 2048 像素?这是预算算术。图集为 80,000 个三角形承载约 420 万纹素,每三角形约 52 纹素,正好匹配 155,197 点的点云实际能提供的颜色细节。4096 图集会让文件翻两番,去承载数据里不存在的细节;1024 图集掉到每三角形 13 纹素,低于点云的供给。让纹理分辨率匹配源头密度,而不是习惯。
这就是整块化石。但磁盘上的脚本和手里的产品是两回事,所以聊聊这道鸿沟。
6、用 AI 把流水线变成产品
这里有一个我希望你说清楚的分工,因为很容易搞反。你刚读完的一切是难的部分,它需要人。不透明度上的 sigmoid、四元数左乘、天空启发式、泊松优于球轴法的实测选择:那是领域判断,现在它归你了。
AI 编程助手真正擅长的是包裹在判断外面的外壳。把你那九个能跑的函数交给它,再加一段话:给我做一个小桌面应用,我拖进一个泼溅 .ply,能看到高斯数量和不透明度直方图,拖两个滑块调过滤器,预览点云,点一个按钮完成翻转、网格化、烘焙并导出 .glb。那是一天的 UI 管线活,你可以放心委托,因为它产出的每个输出你都能验证。
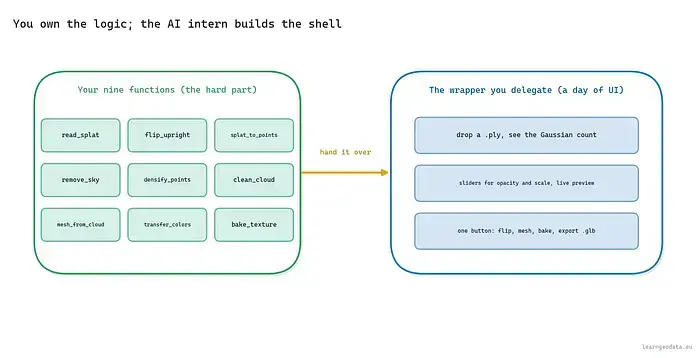
这也是学习流水线而不是租用转换的诚实理由:不是骄傲,而是判断的杠杆。理解第 3 步的人,三十秒就能分辨一个能用的转换器和一个坏的。不理解的人,只能任由工具输出摆布。
🍉 商业点子: 泼溅转资产转换今天是按次扫描的云服务在卖,而每个这样的服务都留着你场景的副本。相反的产品有空间:一个本地、一次买断的桌面工具,离线把泼溅转成带纹理的 .glb,每次导出都附带质量报告(各过滤器的存活数、孔洞数、纹素覆盖率)。这条流水线自动抓住的 8,471 个天空高斯会是招牌功能——去问问任何和蓝色外壳问题搏斗过的人。
流水线建好了,产品可以想象了。是时候退后一步,看看我们到底做出了什么。
7、完整成果:一个比渲染器活得更久的场景
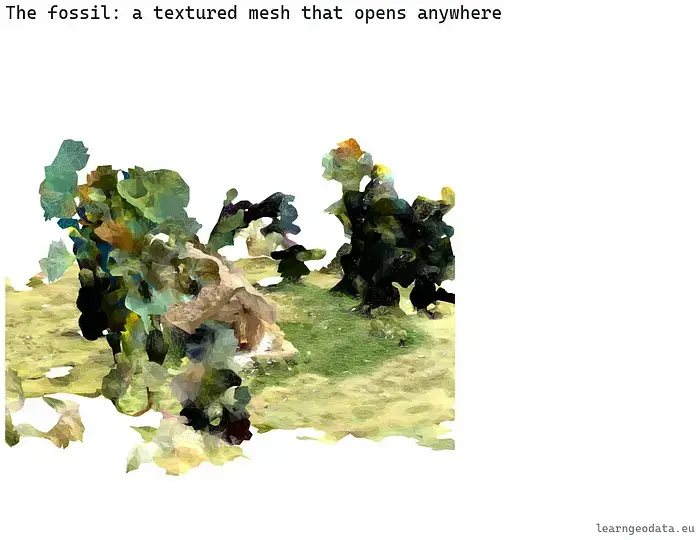
回到小屋。在本文开头,它只以一种形式存在:84,528 个只有泼溅光栅化器才能显示的高斯。现在它以 6.59 MB 带纹理 .glb 的形式存在:坚固、关键处水密、披着自己的颜色,采用一种过去十年每种 3D 工具都不用插件就能打开的标准格式。
这就是它,特写——和本文顶部泼溅渲染器给你看的同一栋房子,如今把烘焙好的纹理披在坚固的三角形上。
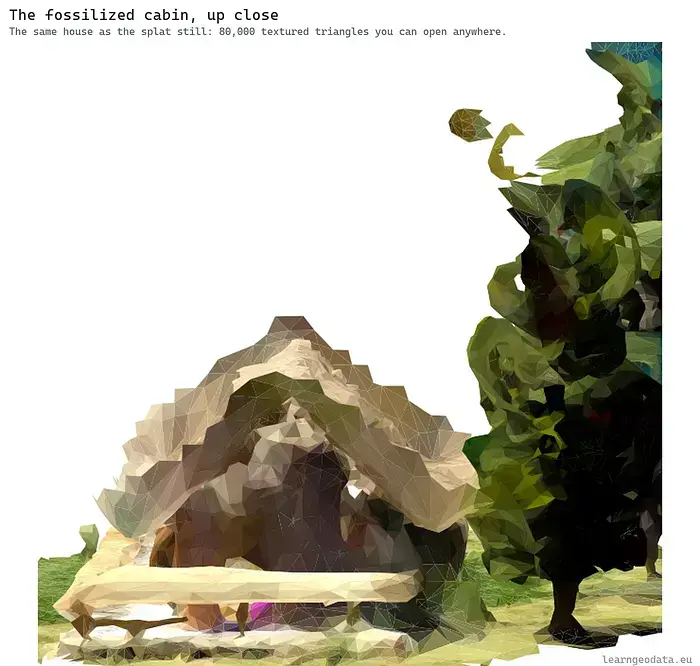
化石化的隐喻把我们带到了这里,那就逐阶段地把它闭环合上。
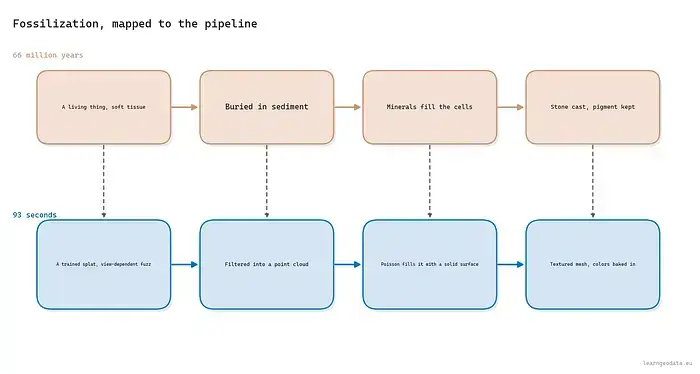
一个活物变成化石,要先被过滤到它耐久的结构,注入新的材料,并保留刚好足够的表面化学信息,好告诉我们它生前是什么颜色。你的泼溅以同样的方式变成了网格:过滤到 56,563 个可信点,注入一个泊松曲面,最后把自己的颜色烘焙进石头——嗯,烘焙进 .glb 里的一张 PNG 图集。
这些技能可以完全迁移。解剖解析适用于任何用标准格式训练过的泼溅。翻转修复你将遇到的每一个 COLMAP 血统的导出。过滤-致密化-网格化-烘焙链条在你的下一个场景上原样可用。把它跑在你自己街道的泼溅上,同样九个函数会打印出它们自己的诚实数字。
局限,以及如何突破
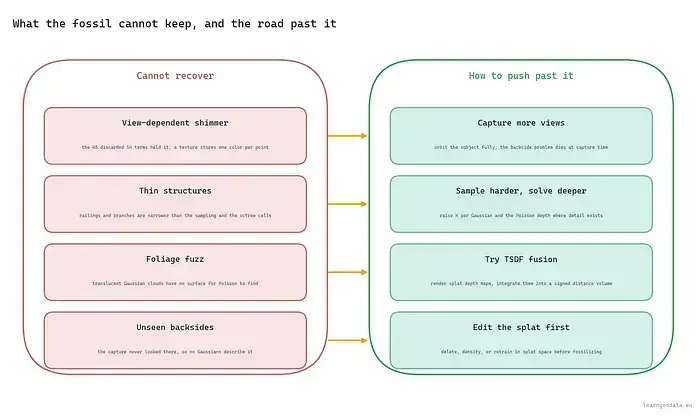
没有一种方法与真实数据碰撞后不带淤青,你应该确切知道这一种会在哪里流血,再信任它。所以这是一份诚实的清单:这条流水线无法恢复的四样东西,每样一行讲清原因,然后是通往每一条出路的路。
视角相关的闪烁没了。 我们在第 1 步丢掉的 45 个 SH 系数承载着它,而烘焙纹理对每个表面点只存一个颜色。你绕着泼溅转动时那扇窗户的闪光,是化石给不了的表演。
细结构会融化。 栏杆板条或白桦细枝比采样间距和深度 10 的八叉树单元都窄,泊松会把它融进邻居,或干脆丢掉。
树叶绒毛会变成团块。 泼溅里的树冠是一团重叠的半透明高斯,里面没有真正的表面,而曲面求解器被要求给出表面时,只会用蜡烛油来交卷。诚实地看着对比。
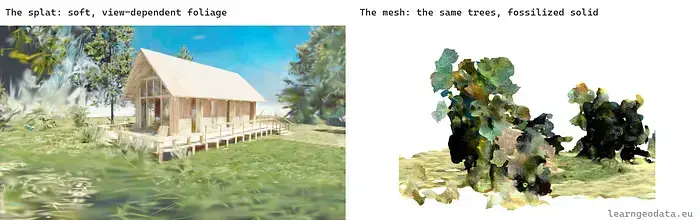
没拍到的背面是虚构的。 拍摄只绕小屋走了一段弧线,所以没有高斯描述屋顶的另一侧,泊松用凭空发明的皮肤补上这个缺口,随后被密度裁剪戳破。
还有两处较小的淤青该列在同一张清单上。
.glb 继承了泼溅的任意单位,所以在任何真实用途之前,先量一个已知长度做缩放——这个技巧我在本系列的视频转网格教程里讲过。
还有,我的天空启发式终究是启发式:屋顶上的蓝色防水布会成为附带损伤,如果你的场景把天空色几何留在高处,就把高度闸门收紧。
那么从这里怎么改进?上面每条局限都有一条通路,值得精确地命名。
拍摄时多拍视角,能在问题出现之前杀死背面问题:完整环绕主体,泼溅就会带上这个场景所缺的证据。当拍摄确实包含更细的结构时,更密的采样和更深的求解能把它们恢复出来:把 K 提到 6 以上、泊松深度提到 10 以上要一起调,因为只动一个只会撞上另一个的天花板。
TSDF 融合是另一个值得了解的网格化家族:从泼溅渲染深度图,把它们积分进一个带符号距离体,细结构比单次全局泊松求解存活得更好。而泼溅原生编辑把修复移到上游:在化石化任何东西之前,删掉绒毛、加厚墙壁,或用更多视角重训。
如果你更想正经学会这些路,而不是把它们当冷知识收集,我的课程恰好从本文停下的地方接手。我们讲拍摄与训练一侧:更好的输入、更干净的泼溅,以及对你喂给这条流水线的场景的真正控制。然后我们深入重建一侧,从原始拍摄一路到此处对比过的各种网格化策略。等项目值得时再学;你刚搭好的流水线已经是你的了。
8、租用转换与拥有转换的区别
从小屋上镜头拉远一分钟,因为这个模式比单个场景更大。
3D 历史上每一个脆弱、绑定渲染器的格式,最终都需要一个逃生舱,而获得它一直只有两条路:每次付钱给别人,或者自己拥有逃生舱。泼溅让这个旧选择显得又新了,因为格式还年轻,"上传你的场景"类服务先到了。
但跑一遍本文实测的数字:转换在 CPU 上花了 93 秒。库是自由开源的。
输出属于一个人人都能读的标准。唯一稀缺的原料是知道那九步,而你现在知道了。
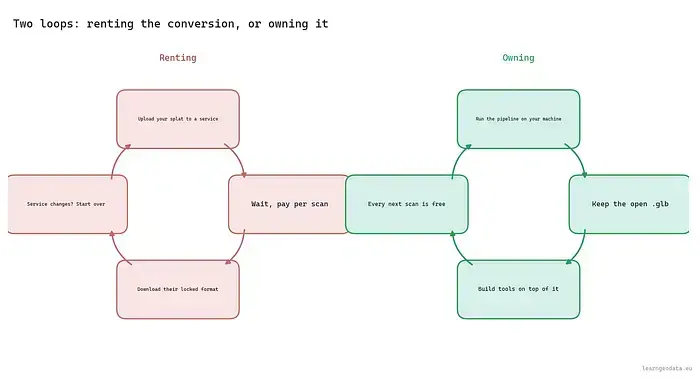
我诚实的赌注是:对经常拍摄的人来说,本地优先的转换会成为常态,就像本地照片编辑熬过了照相馆柜台。重建模型会在上游持续改进。
格式会持续更迭。而拥有自己转换层的人用一行代码修改就能吸收每次变化,租用的人只能等供应商的路线图。
化石记录留住的是被埋进合适沉积物里的东西。你的存档会留住你转成自己掌控的格式的东西。
9、结束语
别把它留在理论里。
你某处有一个泼溅,或者这个周末就能训一个,而与这条流水线相处一小时,会改变你对待之后每一次拍摄的方式。
挑一个对你有意义的场景。在它上面跑那九个函数。看漏斗打印它的存活数,在天空给你的树结壳之前抓住它,然后在 Blender 里打开完成的 .glb,发现颜色已经接好了线。
第一次在你自己的数据上跑通时,会有东西"咔哒"一声:你的泼溅不再是屏保,而开始成为素材。
所以这是我的问题给你:你的拍摄文件夹里,哪一个场景配得上比它的渲染器活得更久?
原文链接: Turn 3D Gaussian Splatting into a textured mesh (Python, no GPU)
汇智网翻译整理,转载请标明出处