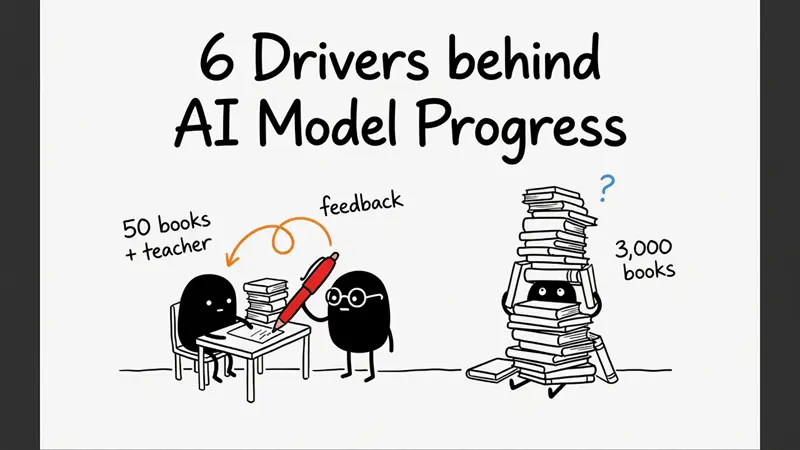
AI模型进步的6个杠杆
数据、架构、算力、反馈、上下文和推理如何协同作用,使每一代模型都更加强大。
梯形图转SCL | 需求文本转SCL | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI | ElevenLabs | KlingAI | ArtSpace
有一段时间,我对为什么更新的AI模型会比前一代更好有一个相当简单的理论。我认为进步主要来自于给模型更多数据、增加参数数量以及在训练上投入更多算力。在我脑海中,模型基本上就是一个桶,改进取决于你能往里面倒多少东西。
当我回顾早期的扩展竞赛时,这个解释似乎很有道理。OpenAI的GPT-3拥有1750亿参数,而Google的PaLM后来达到了5400亿。从表面上看,这个模式似乎简单明了,我几乎没有质疑过。公司们正在构建更大的模型,用海量文本训练它们,并获得更强大的系统作为回报,因此很容易想象这种模式会无限期地持续下去。
然而,随着新一代模型的出现,参数数量变得越来越不实用,无法理解改进了什么。一些实验室完全停止发布参数数量,较小的模型有时表现得令人惊讶地好,甚至超越了大得多的模型,新模型开始在指令跟随、编码、长上下文处理和推理等方面取得进步,而这些进步单靠模型规模是无法很好解释的。
我最终意识到,我把模型开发的一个重要部分当成了整个过程。
1、玛雅、利奥和我最初理论的问题
帮助我理解这一点的例子是两个学生准备同一场考试。
假设玛雅有50本好书和一位定期检查她作业的老师。每当玛雅答错时,老师会查看发生了什么,解释错误从何而来,并给她另一次机会来解决这类问题。随着时间的推移,她的准备变得越来越有针对性,因为每一轮都揭示了她理解得好或仍需努力的具体方面。
利奥可以访问一个包含3000本书的图书馆。他可以阅读比玛雅多得多的材料,而且他的图书馆很可能包含玛雅从未遇到过的信息。然而,他的准备有一个不同的弱点:没有人定期评估他理解了什么,哪些错误在重复,或者他在哪些材料的应用上做得不好。
我最初思考AI的方式会让利奥成为明显的 favorites,因为他有更多可用的材料。一旦我在例子中加入纠正,这个结论就变得难以辩护了。玛雅的书更少,但她的学习过程不断发现差距并将注意力引向它们。
这个类比有一个限度,因为AI模型的预训练已经包含了一个学习信号。在训练过程中,模型进行预测、测量误差并反复调整其参数。因此,利奥不应该被想象成一个简单的预训练语言模型,只阅读成千上万本书而不从错误中学习。
当类比进入模型开发的后期阶段时,老师变得更加有用,因为训练可以变得更加有针对性。模型产生答案,这些答案以某种方式被评估,由此产生的信号可以用来改进开发者关心的行为。
一旦我理解了这种区别,玛雅和利奥的例子就开始帮助我思考AI训练的几个方面,而不仅仅是一个方面。
2、Chinchilla改变了什么关于扩展
对我最初理论的第一个主要修正实际上在老师进入画面之前就出现了。它涉及学习者的大小和可学习材料数量之间的关系。
2022年,DeepMind发表了关于后来被称为Chinchilla扩展定律的研究。研究人员研究了当总训练计算量有限时,如何平衡模型大小和训练数据。其中一个结论是,那个时期的几个大型模型拥有的参数数量远超计算最优平衡所建议的数量。
DeepMind随后训练了Chinchilla,一个拥有700亿参数的模型,使用了大约1.3万亿个token。Gopher,一个更早的DeepMind模型,拥有2800亿参数。在大致相同的训练计算量下,Chinchilla在DeepMind测量的几乎所有任务上都超越了Gopher。
这个结果改变了我对模型大小的看法,因为它表明单独看参数数字会多么误导。更大的模型创造了额外的容量,而将这种容量转化为有用的能力取决于提供适当数量的训练数据和计算。
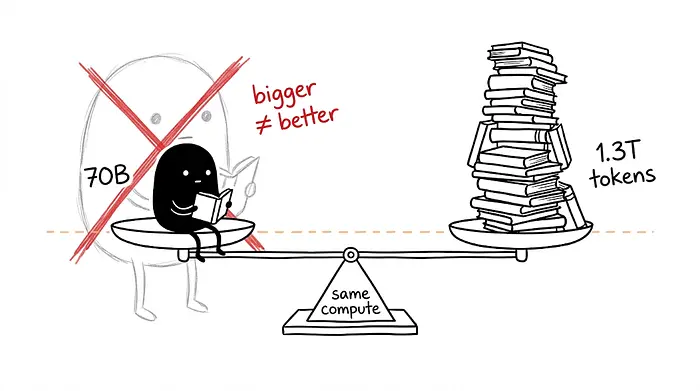
我从Chinchilla学到的教训因此是关于平衡。模型大小、训练数据和计算相互影响,训练运行可以很好地或很糟糕地分配这些资源。一旦我开始用这些术语思考,仅仅询问模型有多少参数就开始感觉有点像根据教室座位数来评判一所大学。
这种转变在当今发布的模型中仍然可见。Anthropic当前的2026年产品线包括Claude Fable 5.1、Opus 5和Sonnet 5,其中Fable 5.1被Anthropic描述为其在编码和知识工作方面最强大的模型。该公司的公开材料非常强调能力、用例、上下文、智能体工作、定价和安全特性,这讲述的故事比单独的参数数字所能提供的要丰富得多。
同样的广泛模式也可以在其他实验室看到。即使外界对参数数量的变化知之甚少或一无所知,新一代模型也能显著改进,这意味着理解模型进展需要更多地关注训练过程。
那就是我开始提出更有用问题的时刻:当人们说新模型训练得更好时,实际上改变了什么?
3、模型学习的数据
第一个杠杆是材料本身,它从一开始就在玛雅和利奥的图书馆中。
模型可以训练在大量的token上,尽管这些token的有用性很大程度上取决于它们包含什么。训练数据可以包括高质量的解释、重复的页面、不正确的信息、代码、数学、对话、科学材料、低质量的生成文本和许多其他类型的内容。因此,实验室需要决定数据来源、如何过滤、哪些类型的材料应该获得更高权重以及如何处理重复或低质量的材料。
想象一下,发现利奥的3000本书中有很大一部分重复相同的几个想法,而另一大部分则错误地解释重要概念。图书馆令人印象深刻的规模仍然能告诉我们他可以访问多少材料,但它告诉我们关于他的学习会议将有多大用处的信息却少得多。
同样的想法适用于训练数据。增加有用数据的数量为模型提供了更多学习模式、事实、推理风格、语言、代码结构和概念之间关系的机会。增加重复或不可靠材料的数量可能会产生非常不同的效果。
这也是为什么现在当我看到“在更多数据上训练”这句话被用来解释模型改进时,我认为它不完整。我想知道改变了什么类型的数据、如何选择的、重要领域是否得到更好的代表,以及训练混合本身是否变得更加有意识。
图书馆的规模仍然重要。填充书架的内容同样重要。
4、进行学习的架构
架构是我最初在类比中放错位置的另一个概念。
我曾经认为架构类似于学习技巧,一个学生重读一章,而另一个学生画图表或将想法组织成笔记。这种描述混淆了学习者的设计和用于教导他们的方法。
架构位于系统更深的层面。它包括关于模型如何处理信息、注意力如何工作、层如何组织、信息如何路由和表示以及模型如何有效使用可用计算的结构性决策。不同的模型家族也可以使用诸如专家混合之类的架构思想,其中只有网络的一部分被特定token激活,允许开发者改变总参数和推理期间使用的计算量之间的关系。
学生类比如果我过于字面地推敲会变得有点奇怪,尽管底层仍然有一个有用的直觉。两个学生可以得到相同的书、相同的老师和相同的学习时间,同时在识别关系、组织信息或将所学应用到不熟悉的问题方面具有非常不同的能力。
架构影响进行学习的机器。它塑造了什么类型的模式可以被高效学习以及学习变得多么昂贵。
这个杠杆也很难从实验室外部观察,因为公司很少披露其前沿模型的每个架构细节。我们可以更容易地看到完成系统的能力,而不是看到其下的所有工程决策。
这种不确定性是我对通过单个可见数字解释模型改进变得谨慎的另一个原因。一些最重要的变化可能隐藏在公司从不发布的系统部分中。
5、算力决定了多少训练是可行的
我也一直以过于狭隘的方式思考算力。
我最初的心理图像是更多的GPU时间只是给模型更多时间来吸收其训练数据,大致就像给玛雅多一个月来学习她的书。这个图像有一些道理,尽管算力在开发过程中发挥着更广泛的作用。
训练更大的模型需要算力。运行不同架构的实验需要算力。测试不同的数据混合需要算力。后训练需要算力。生成合成训练数据可能需要算力。运行大型评估套件和比较模型变体也会消耗资源。
回到玛雅,给她三个月时间,用她的50本书,定期测试,并且可以访问她的老师。她有足够的时间发现薄弱领域,回到困难章节,尝试不同类型的问题,并应用她收到的反馈。将同样的准备压缩到三天,书和老师的质量仍然很重要,而她实际可以完成的学习量会受到严重限制。
算力在我现在设想的模型开发中扮演着类似的角色。它围绕实验能有多大、可以处理多少token、可以测试多少变体以及在初始训练运行之后可以进行多少额外优化创造了一个预算。
当然,真正的AI开发还依赖于金钱、硬件可用性、电力、数据基础设施、研究人员和工程时间。因此,算力是更大资源约束的一部分。它仍然是一个特别重要的部分,因为许多其他训练决策最终都会转化为额外的计算。
这也改变了我对六个杠杆之间关系的思考。算力并不像其他孤立成分那样整齐地位于其他杠杆旁边。它影响着一个实验室能同时推进多个杠杆的程度。
6、反馈在预训练后塑造模型
这是玛雅的老师变得特别有用的地方。
在广泛的预训练之后,现代语言模型通常会经历额外的阶段,旨在塑造其能力的表达方式。这些阶段可以包括监督微调、基于偏好的训练、来自人类反馈的强化学习、AI生成的反馈、使用奖励模型的训练以及在可以自动检查答案的任务上的强化学习。
确切的配方在不同公司和模型代之间有所不同,而且许多前沿训练过程仍然是私有的。从外部更容易看到一般思想:模型产生某种行为,评估过程提供有关该行为质量的信息,训练使用该信号使期望的反应更有可能发生。
玛雅的老师可以做类似的事情。如果玛雅理解底层数学但持续误读某种类型的考试题目,老师可以直接针对这种失败。如果她通过不可靠的推理给出正确答案,老师可以在它成为习惯之前暴露弱点。因此,每一轮评估都可以比简单地给她另一堆书更有针对性。
对于语言模型,后训练可以影响指令跟随、编码行为、工具使用、安全行为、响应风格和特定类别任务的表现。它还可以教模型识别当直接的第一次尝试失败时,哪些类型的方法往往有效。
我最初在这个过程的解释中给了这部分太多责任。我认为反馈可能是新模型更好地遵循指令和更少产生幻觉的主要原因。我越研究,就越发现这些改进与其他杠杆交织在一起。例如,幻觉率可能受到训练数据、后训练、检索系统、工具使用、验证方法、提示和评估的影响。
反馈仍然是玛雅和利奥例子中最有用的补充之一,因为它使针对性改进变得容易看到。它只是作为更大训练图景的一部分效果最好。
7、上下文包含两个不同的问题
上下文是我一直在结合两个相关想法的另一个地方。
我最初将上下文描述为模型能否在到达问题106时记住问题1。这仍然是对该问题的日常描述,尽管它隐藏了一个重要区别:模型可以接收多少信息以及它能多有效地使用这些信息。
第一部分是上下文窗口。这决定了在模型交互中可以提供多少文本、代码、对话历史、检索材料或其他信息。支持的大小取决于架构和训练选择,现代模型可以接受比早期代大得多的上下文。
第二部分是所有这些信息进入窗口后会发生什么。模型可能技术上接受一个很长的文档,但仍然难以找到埋在中间的一个相关句子,连接相隔数千个token的细节,或在整个长交互过程中保持对任务的相同理解。
这就是为什么我现在用开卷考试来思考长上下文。
想象一下,允许玛雅将数百页笔记带入考场。额外的材料让她能够访问更多的信息,但她的结果仍然取决于她能否在问题出现时找到有用的页面,识别哪个细节重要,并将其与问题的其余部分联系起来。
更大的上下文窗口创造了空间。训练和评估有助于确定模型学会使用该空间的程度。
这种区别变得越来越重要,因为上下文窗口数字很容易做广告。一个大数字可以使两个模型看起来相似,即使它们在长文档中推理、从对话早期跟随指令或检索隐藏信息的能力存在很大差异。
所以当我看到一个模型被描述为支持非常大的上下文窗口时,我将该数字视为问题的开始。我还想知道模型在整个窗口长度上工作的可靠性如何。
8、推理已成为自己的训练问题
推理是第六个杠杆,这是现代模型开发中最近改变我心理模型的部分。
早期的语言模型已经可以解决多步骤问题,尤其是随着它们变得更大和更有能力。最近专注于推理的系统更加强调训练模型在困难问题上花费计算、探索中间方法、从错误中恢复并在产生答案之前改进其解决方案。
OpenAI早期对其o1推理模型的工作描述了强化学习,教会模型使用富有成效的内部问题解决过程。该公司还报告说,随着它在训练期间增加强化学习计算以及模型在推理时获得更多计算用于推理,性能有所提高。
这给了我一个更好的考试类比版本。
假设玛雅花了几个月时间在困难的数学问题上接受评估,其中训练过程奖励成功的解题方法。随着时间的推移,她可以学习有用的习惯,比如将问题分解成部分、检查中间结果、注意到某种方法正在失败并尝试另一条路线。在实际考试中,给她足够的时间来使用这些习惯可以提高她在需要几个阶段工作的问题上的机会。
这里有一个重要的区别,我在最初的描述中忽略了。我曾经谈论推理,好像新模型被训练来“展示他们的工作”。内部推理过程和向用户展示的解释是分开的。模型可以使用扩展的内部过程,然后提供有用结果的更简短解释。例如,OpenAI明确描述了保持其推理模型的原始思维链隐藏,同时训练它们在答案中传达解决方案的有用部分。
这意味着有趣的能力是问题解决过程本身的质量。模型可能会花费额外的计算来检查困难任务、测试方法或检查结果,即使最终响应看起来很简洁。
这也为计算增加了另一个维度。在文章的早些时候,我主要谈论训练计算,这是在模型开发期间花费的。推理模型使推理时间计算更加可见,因为一些困难问题可以在用户已经提问后从花费额外计算中受益。
我们从模型体验到的智能量因此部分取决于训练几个月中发生的事情,部分取决于系统为这个特定问题执行的工作量。
9、六个杠杆持续相互影响
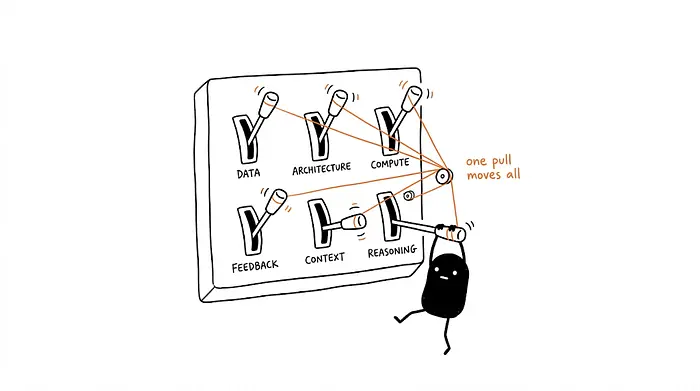
一旦我将这六个想法分开,我最初将它们想象为仪表板上的独立控制。这种图景帮助了一段时间,但最终造成了另一个问题,因为这些控制相互作用太多,无法独立运作。
更大的架构创造了需要足够数据和计算来有效训练的容量。当模型有足够的容量来吸收模式时,更好的数据变得更有价值。当预训练模型已经具有强大的底层能力时,后训练可以更有效地塑造有用行为。当训练教会模型查找和连接信息时,巨大的上下文窗口变得更有用。
推理创造了类似的依赖关系。额外的推理时间计算只有在模型学会了使用该计算的有用方式时才有帮助,而推理训练只能与存在于底层模型中的知识和能力一起工作。训练期间使用的任务质量和答案评估的方式随后影响哪些类型的推理得到改进。
这让我回到玛雅。
她的50本书很重要,因为它们包含了她需要的材料。她理解材料的能力影响她能从那些书中学到什么。她的老师给她有针对性的反馈。她的学习时间决定了她能完成多少轮练习和纠正。她处理大量笔记的能力影响她在考试中能使用多少信息,而她的问题解决习惯影响当答案不立即明显时她会做什么。
改变这些中的任何一个都可能提高她的表现。同时改变几个可能会产生更大的差异。
这就是我现在发现最有用的类比部分。
10、当新模型到来时我寻找什么
几年前,看到一个新的前沿模型会让我几乎立即搜索参数数量。我想要一个数字来告诉我新东西有多大,因为规模在我的心理模型中承担了大部分解释工作。
现在我发现自己在问一套不同的问题。我想知道训练数据混合是否改变了、架构是否变得更高效、多少计算用于训练和实验、使用了哪些类型的后训练信号、模型在长上下文中如何表现以及专注于推理的训练是否改变了它处理困难问题的方式。
这六个杠杆周围还有其他部分。评估影响研究人员发现和选择改进的内容。合成数据可以扩展或定向训练材料。蒸馏可以在模型之间转移有用行为。检索系统和工具可以为部署的模型提供其参数之外的信息和能力。围绕模型的推理基础设施也可以影响最终产品能够做什么。
因此,我将这六个杠杆视为有用的心理地图,而不是现代AI开发的完整分类。它们涵盖了帮助我理解为什么从更多参数到更好模型的简单进程停止解释我所看到的内容的部分。
模型本身也只是我们使用AI产品时体验的一部分。搜索、记忆、检索、工具、系统指令、安全层和产品级编排都可以改变最终系统的感知能力,即使底层模型保持完全相同。
这种区别在比较两个AI产品时很重要,因为有时我们比较的是模型质量,有时我们比较的是围绕这些模型构建的系统。
11、我现在使用的心理模型
我最初的理论有两个主要成分:更多数据和更多参数。两者仍然重要,扩展仍然是现代AI开发的重要组成部分。错误在于期望这两个数字能解释下一代中出现的几乎每一个改进。
我现在使用的图景有几个相互作用的部分。数据决定了模型有机会学习什么材料。架构塑造了这种学习如何高效地发生。计算为可以进行多少训练、实验和推理设定了实际限制。后训练提供了关于有用行为的更针对性信号。上下文决定了多少信息可以参与任务以及模型能多成功地处理这些信息。专注于推理的训练和推理时间计算影响模型如何处理需要几个阶段工作的问题。
一旦这些部分结合在一起,代际之间的进展对我来说更有意义。新模型可以变得显著更好,而不需要单个可见数字的惊人增长,因为改进可以同时来自多个地方。
这也解释了为什么模型比较变得更难简化为规格。两个模型可以具有相似的上下文窗口,但在长文档中表现非常不同。当训练资源更好平衡时,参数较少的模型可以超越更大的模型。两个在大致相似信息上训练的模型在经历不同形式的后训练后可能表现不同。推理模型也可以根据它们被允许在困难问题上花费多少计算而产生不同的结果。
所以当我思考什么将今年的前沿模型与我们几年前的模型区分开来时,我不再想象一个旋钮被进一步向右转动。我想象一个训练系统,其中数据、架构、计算、反馈、上下文和推理正在一起发展,一个领域的进步为其他领域创造了新的机会。
这就是最终取代水桶模型给我的心理模型。更好的模型来自于一系列决策:系统学习什么、如何学习、可以为该学习投入多少资源以及当模型最终必须解决实际问题时会发生什么。一旦我看整个堆栈,最大的能力跳跃就更有意义了。
原文链接:How AI Models Improve Without Simply Getting Bigger
汇智网翻译整理,转载请标明出处