AutoSynthData:把 Agent 的失败变成训练数据,企业级合成数据流水线
合成数据的难点不是"生成得像",而是"可执行、够真实、能被可靠判定、还刚好卡在模型能力边界上"。AutoSynthData 先用诊断任务找出目标模型的失败模式,用更强教师刻画解法,蒸馏出不含原始提示的能力规格卡,再并行生成核心任务(target)并扩增变体(multiply),逐个过正向/负向验证与批评修复,最后做批级覆盖度审查。EnterpriseOps Gym 实测:Hybrid 的 Pass@1 相对提升 35%,ITSM 从 18.77% 升到 27.18%。
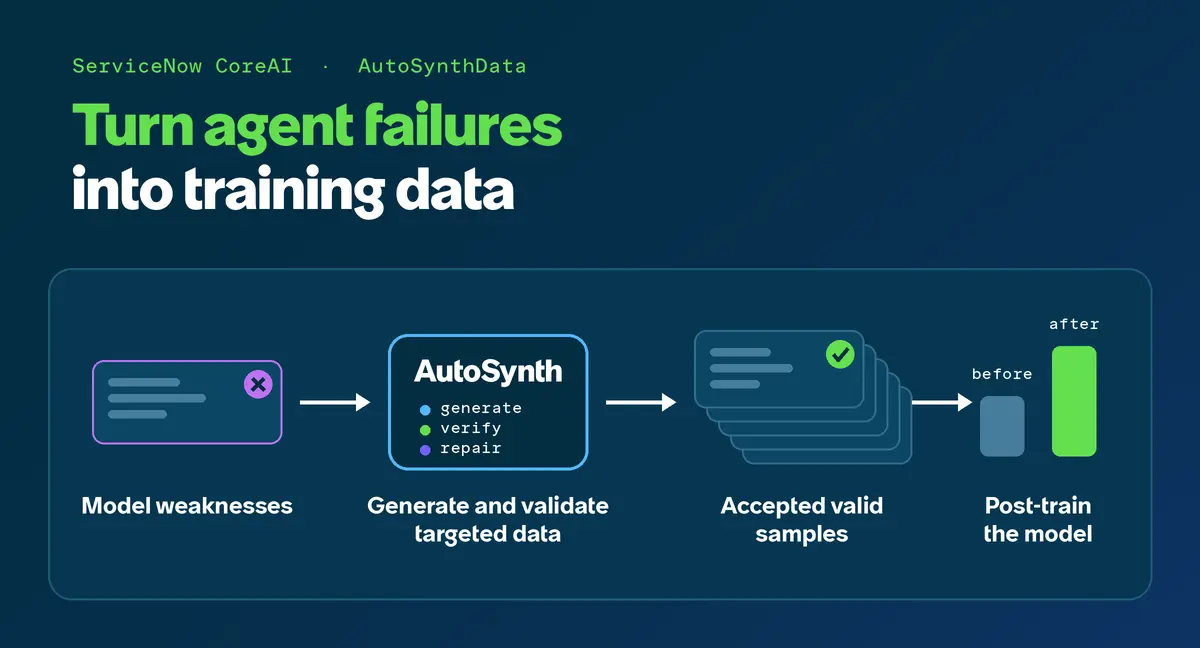
一句话结论:企业要的是在自己环境里干得好的 Agent——而环境是由它用的系统、遵守的规则、数据的状态共同塑造的。一个模型可能泛化能力很强,却在某个具体环境里卡住:某个工作流总是做不好、某组工具总是误用、某条约束总是不遵守。难点在于把这些弱点变成训练数据:单个失败只能说明一件事,而要训练模型,你需要大量在相似能力上、但情境各异的新任务,它们还必须在该环境里可完成、像真人会提的需求、并且有可靠的成功判定。ServiceNow CoreAI 的 AutoSynthData 做的就是这件事:用目标模型的失败 + 更强教师的成功来决定"接下来该学什么",然后生成并验证新的训练任务,并让课程随着模型进步持续向仍感困难的地方迁移。
本文完整编译自 Hugging Face 博客《AutoSynthData: Generating Training Data for Enterprise Agents》(2026-10-02,ServiceNow CoreAI 团队),并做中文整理。
一、什么才算一个"有用的 Agent 任务"
一个 Agent 环境(agentic environment) 定义了 Agent 所处的世界:它能观察和修改的状态、能调用的工具与 API、以及它的动作带来的状态转移。
任务是在这个环境里被实例化的。作者用了这样一个抽象:
task = (system specification, user prompt, verifier)
系统规格(System specification)
系统规格定义 Agent 运作时的约束,包括系统指令、环境策略,以及在适用时的任务级初始化——比如某个给定种子的数据库状态,或一组知识文章。
规格必须与环境的工具、状态与受支持动作兼容;它的指令应当清晰,并避免为了人为制造难度而引入的任意约束。
面向 Agent 的任务(Agent-facing task)
用户提示(user prompt)指定用户希望 Agent 完成什么,以及任何用户级约束。一个生成出来的任务应当满足三个性质:
- 可行性(Feasibility):在当前环境里,至少存在一条轨迹能在遵守系统规格的前提下满足用户提示。这排除了那些依赖不可用工具、不可访问知识、不可能的状态转移、或被策略禁止的动作的任务;
- 真实性(Realism):用户提示应当像用户在目标环境里真的会问的东西。可执行行为的空间通常远大于真实工作流的空间;
- 难度(Difficulty):用于训练时,任务应当暴露当前 Agent 的弱点。已经被稳定解决的任务提供不了多少新的训练信号。因此有用的区域是那些可行、真实,但尚未被稳定解决的任务。
验证器(Verifier)
验证器决定产生的轨迹是否成功完成了任务。它应当满足三个性质:
- 一致性(Consistency):与用户提示、系统规格、以及任务特定的环境状态保持一致;
- 可靠性/健全性(Soundness):应当拒绝那些未满足任务、或违反相关约束的轨迹;
- 完备性(Completeness):应当接受有效的解法,而不是只认某一条参考轨迹。
这些性质在训练中直接影响结果:过于宽松的验证器会奖励错误行为,过于严苛的验证器会惩罚有效解法。
二、总览:从失败到课程
给定一个环境和目标模型,AutoSynthData 生成由系统规格、用户提示、验证器三部分组成的训练任务。生成的任务扎根于环境,并被挑选出来为当前模型提供有用的训练信号。
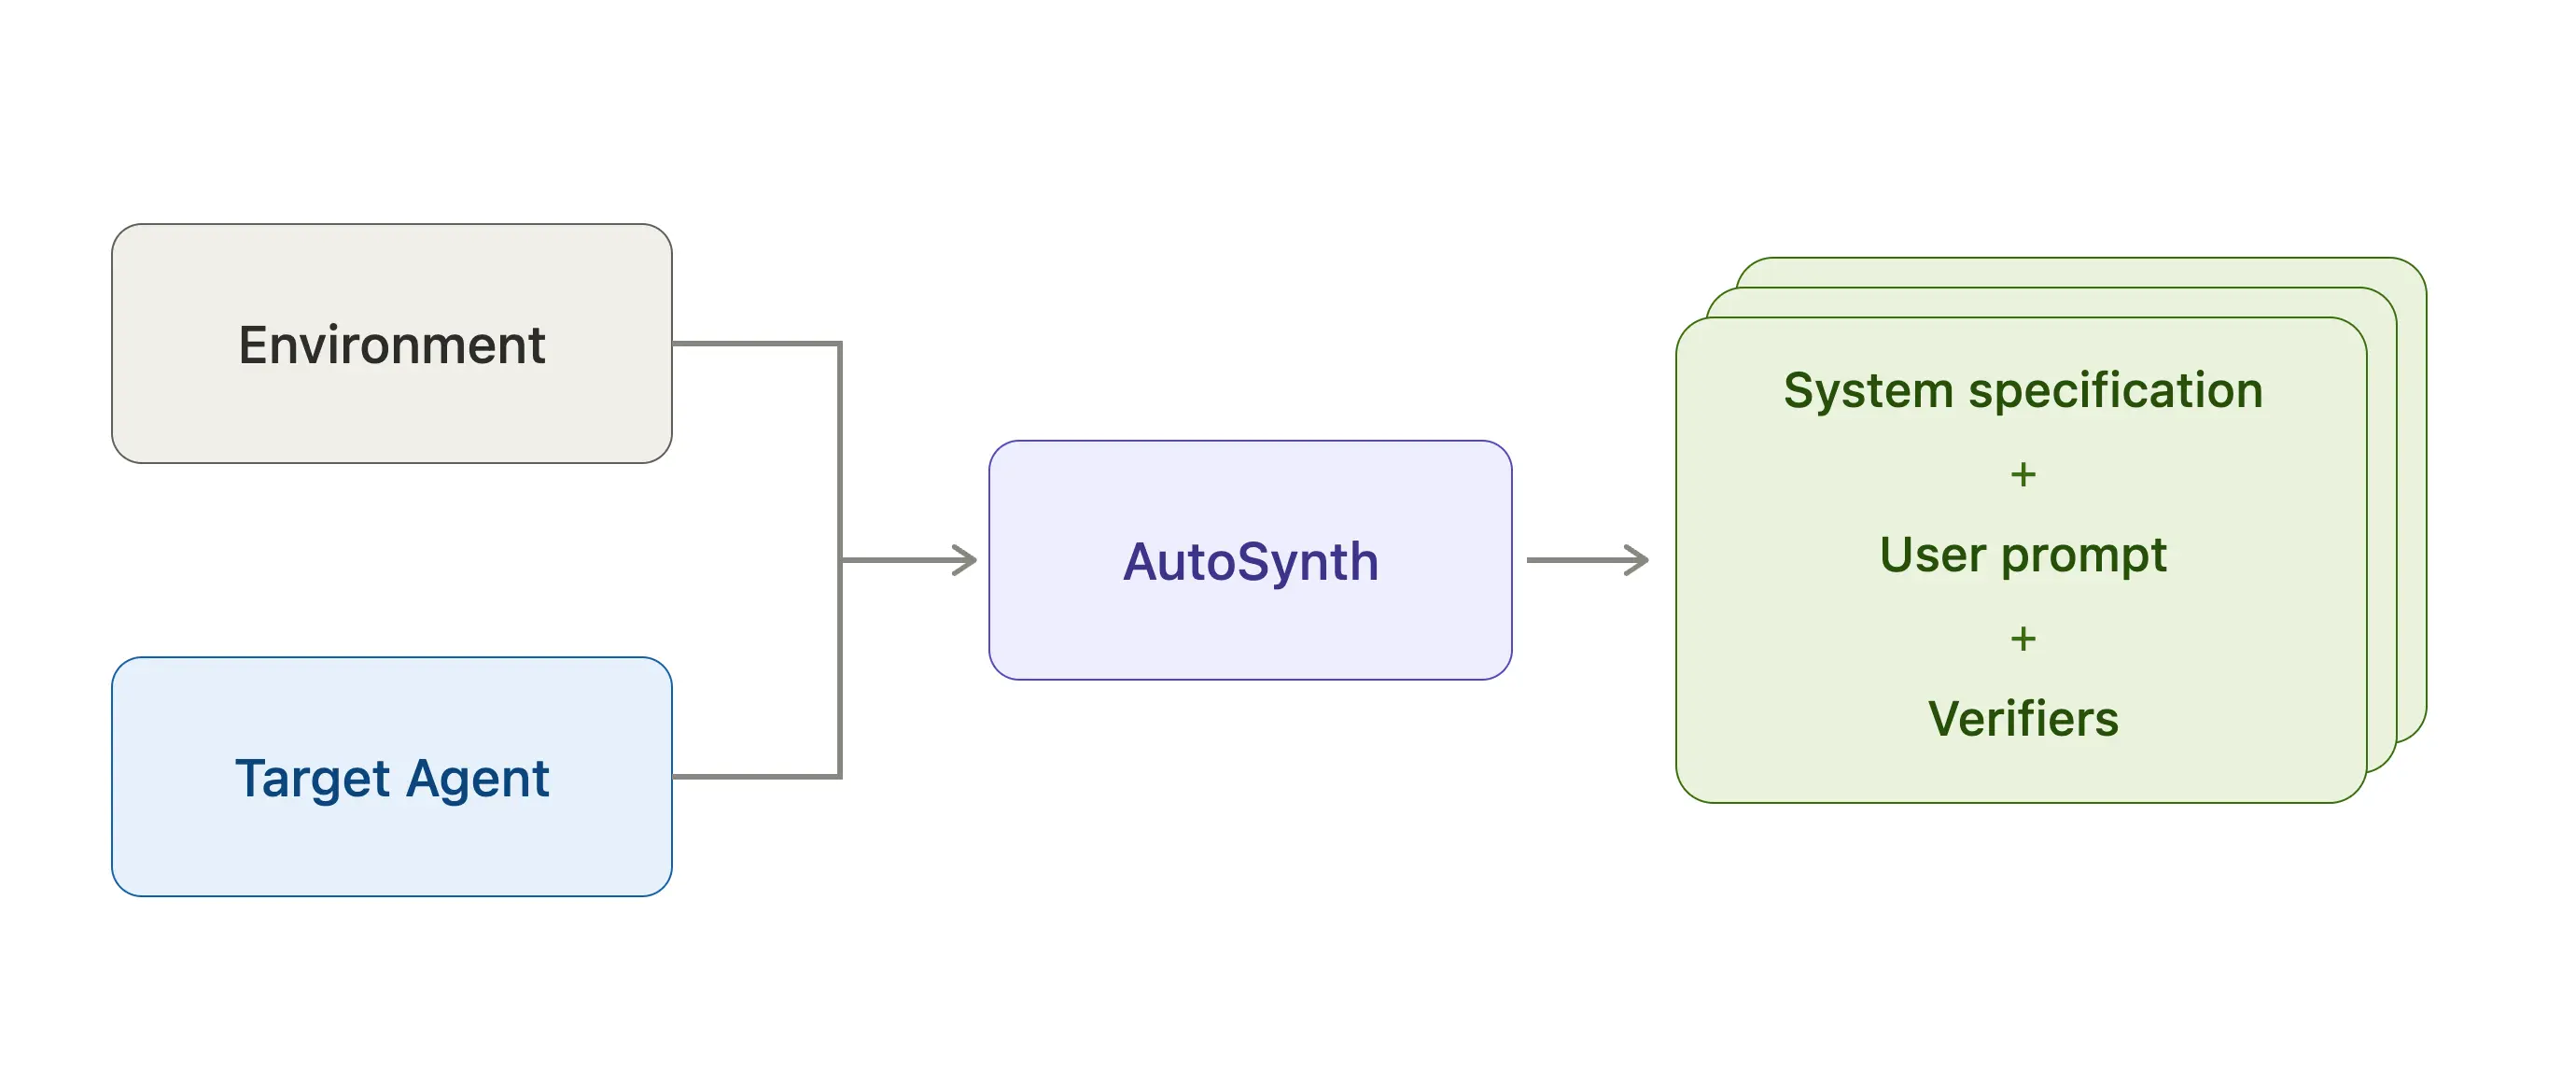
图 1:AutoSynthData 总览。
流程是:先用诊断任务在环境中评估目标模型,找出它难以完成的任务模式;再由更强的教师帮助刻画哪些任务可解、成功行为长什么样;AutoSynthData 把这些能力缺口转成新的可执行任务,在每个任务上于环境中做检查,把被接受的样本用于后训练;评估更新后的模型,就能看出哪些缺口还在,并引导下一轮生成。
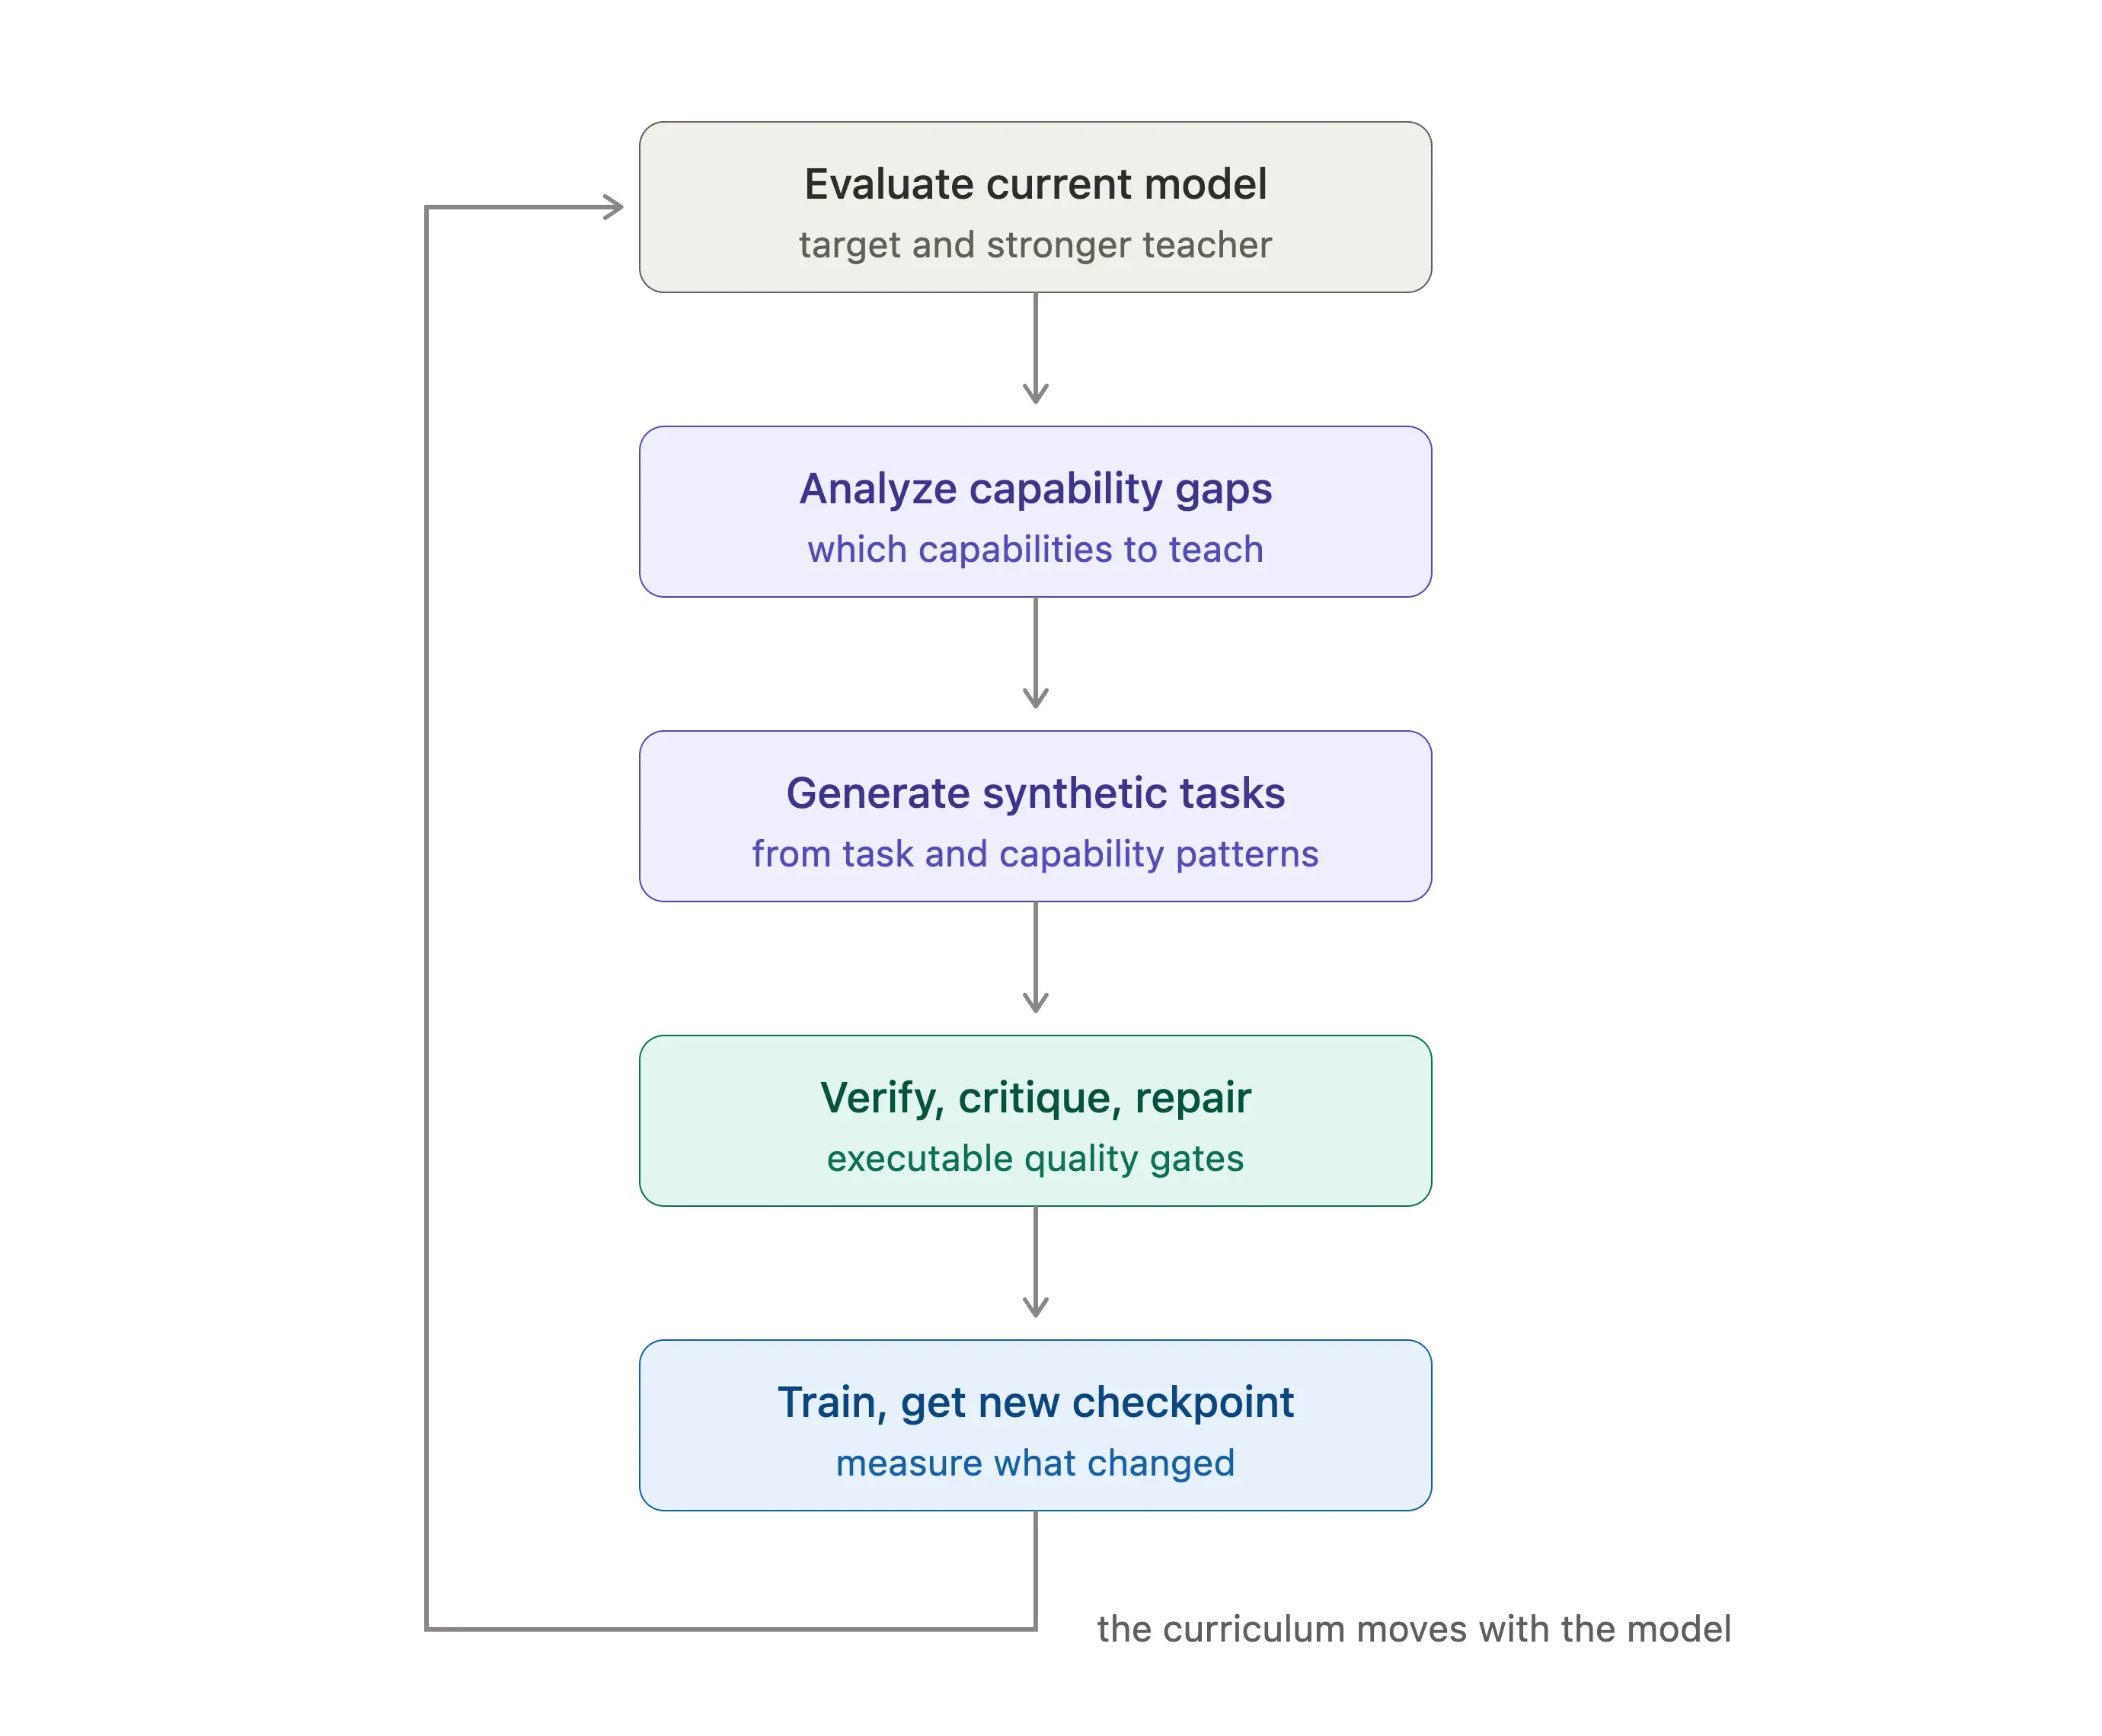
图 2:评估—蒸馏—生成—后训练—再评估的循环。
三、从模型失败到一份课程
AutoSynthData 用目标环境里的评估运行来识别模型接下来需要学什么。在 EnterpriseOps Gym 实验里,作者同时在评估任务上跑目标模型和更强的教师,然后考察:
- 正在被测试的能力是什么;
- 涉及的工具与工作流结构;
- 目标模型在哪里失败、教师如何成功;
- 正确的最终状态必须满足哪些性质;
- 哪些维度可以变化,同时仍保持正在测试的能力不变。
作者把这些发现蒸馏成经过净化的能力规格卡(sanitized capability specification cards)。评估任务决定了模型该学什么,但生成器拿不到它们的原始提示、实体、轨迹或验证器细节——它拿到的是规格卡,并用卡来创建提示、状态与解法路径都不同的新任务。
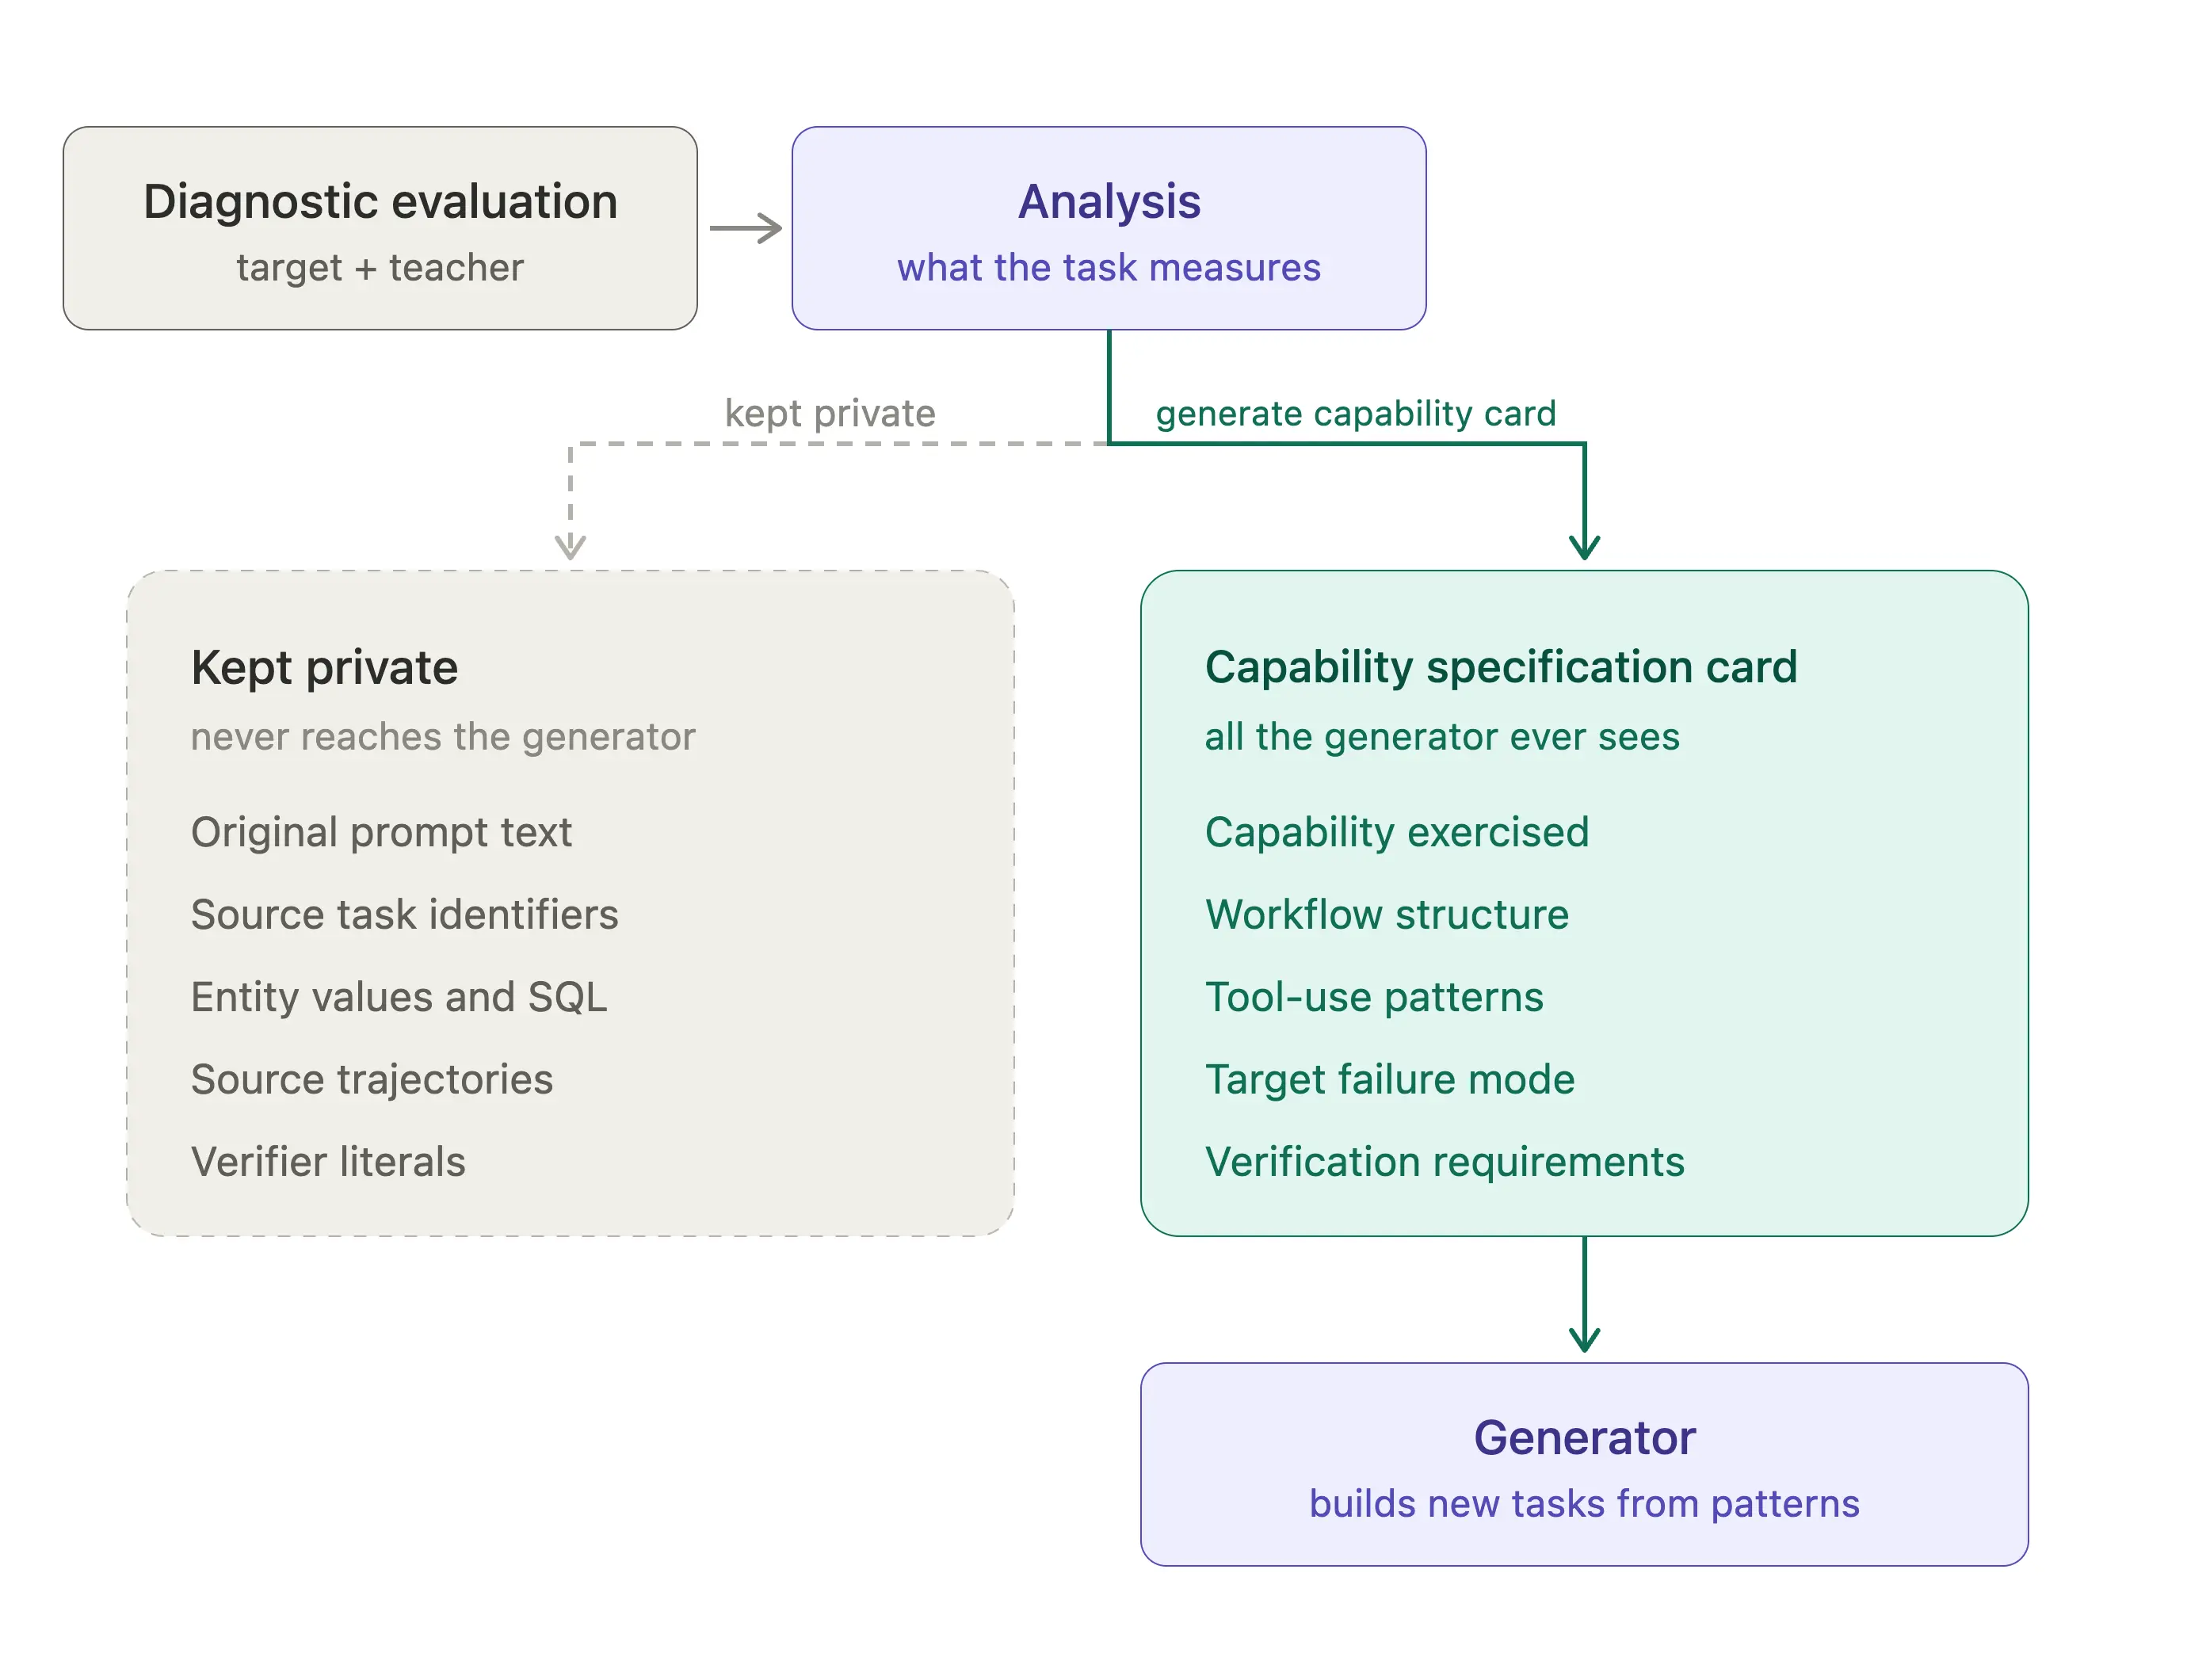
图 3:从评估运行蒸馏出能力规格卡,生成器只看到卡片,看不到原始任务。
四、生成与扩展任务
识别出能力缺口只告诉我们教什么,但训练需要大量不同的任务来演练它。AutoSynthData 用规格卡来生成这些任务。
假设目标模型在需要如下工作流的任务上卡住:
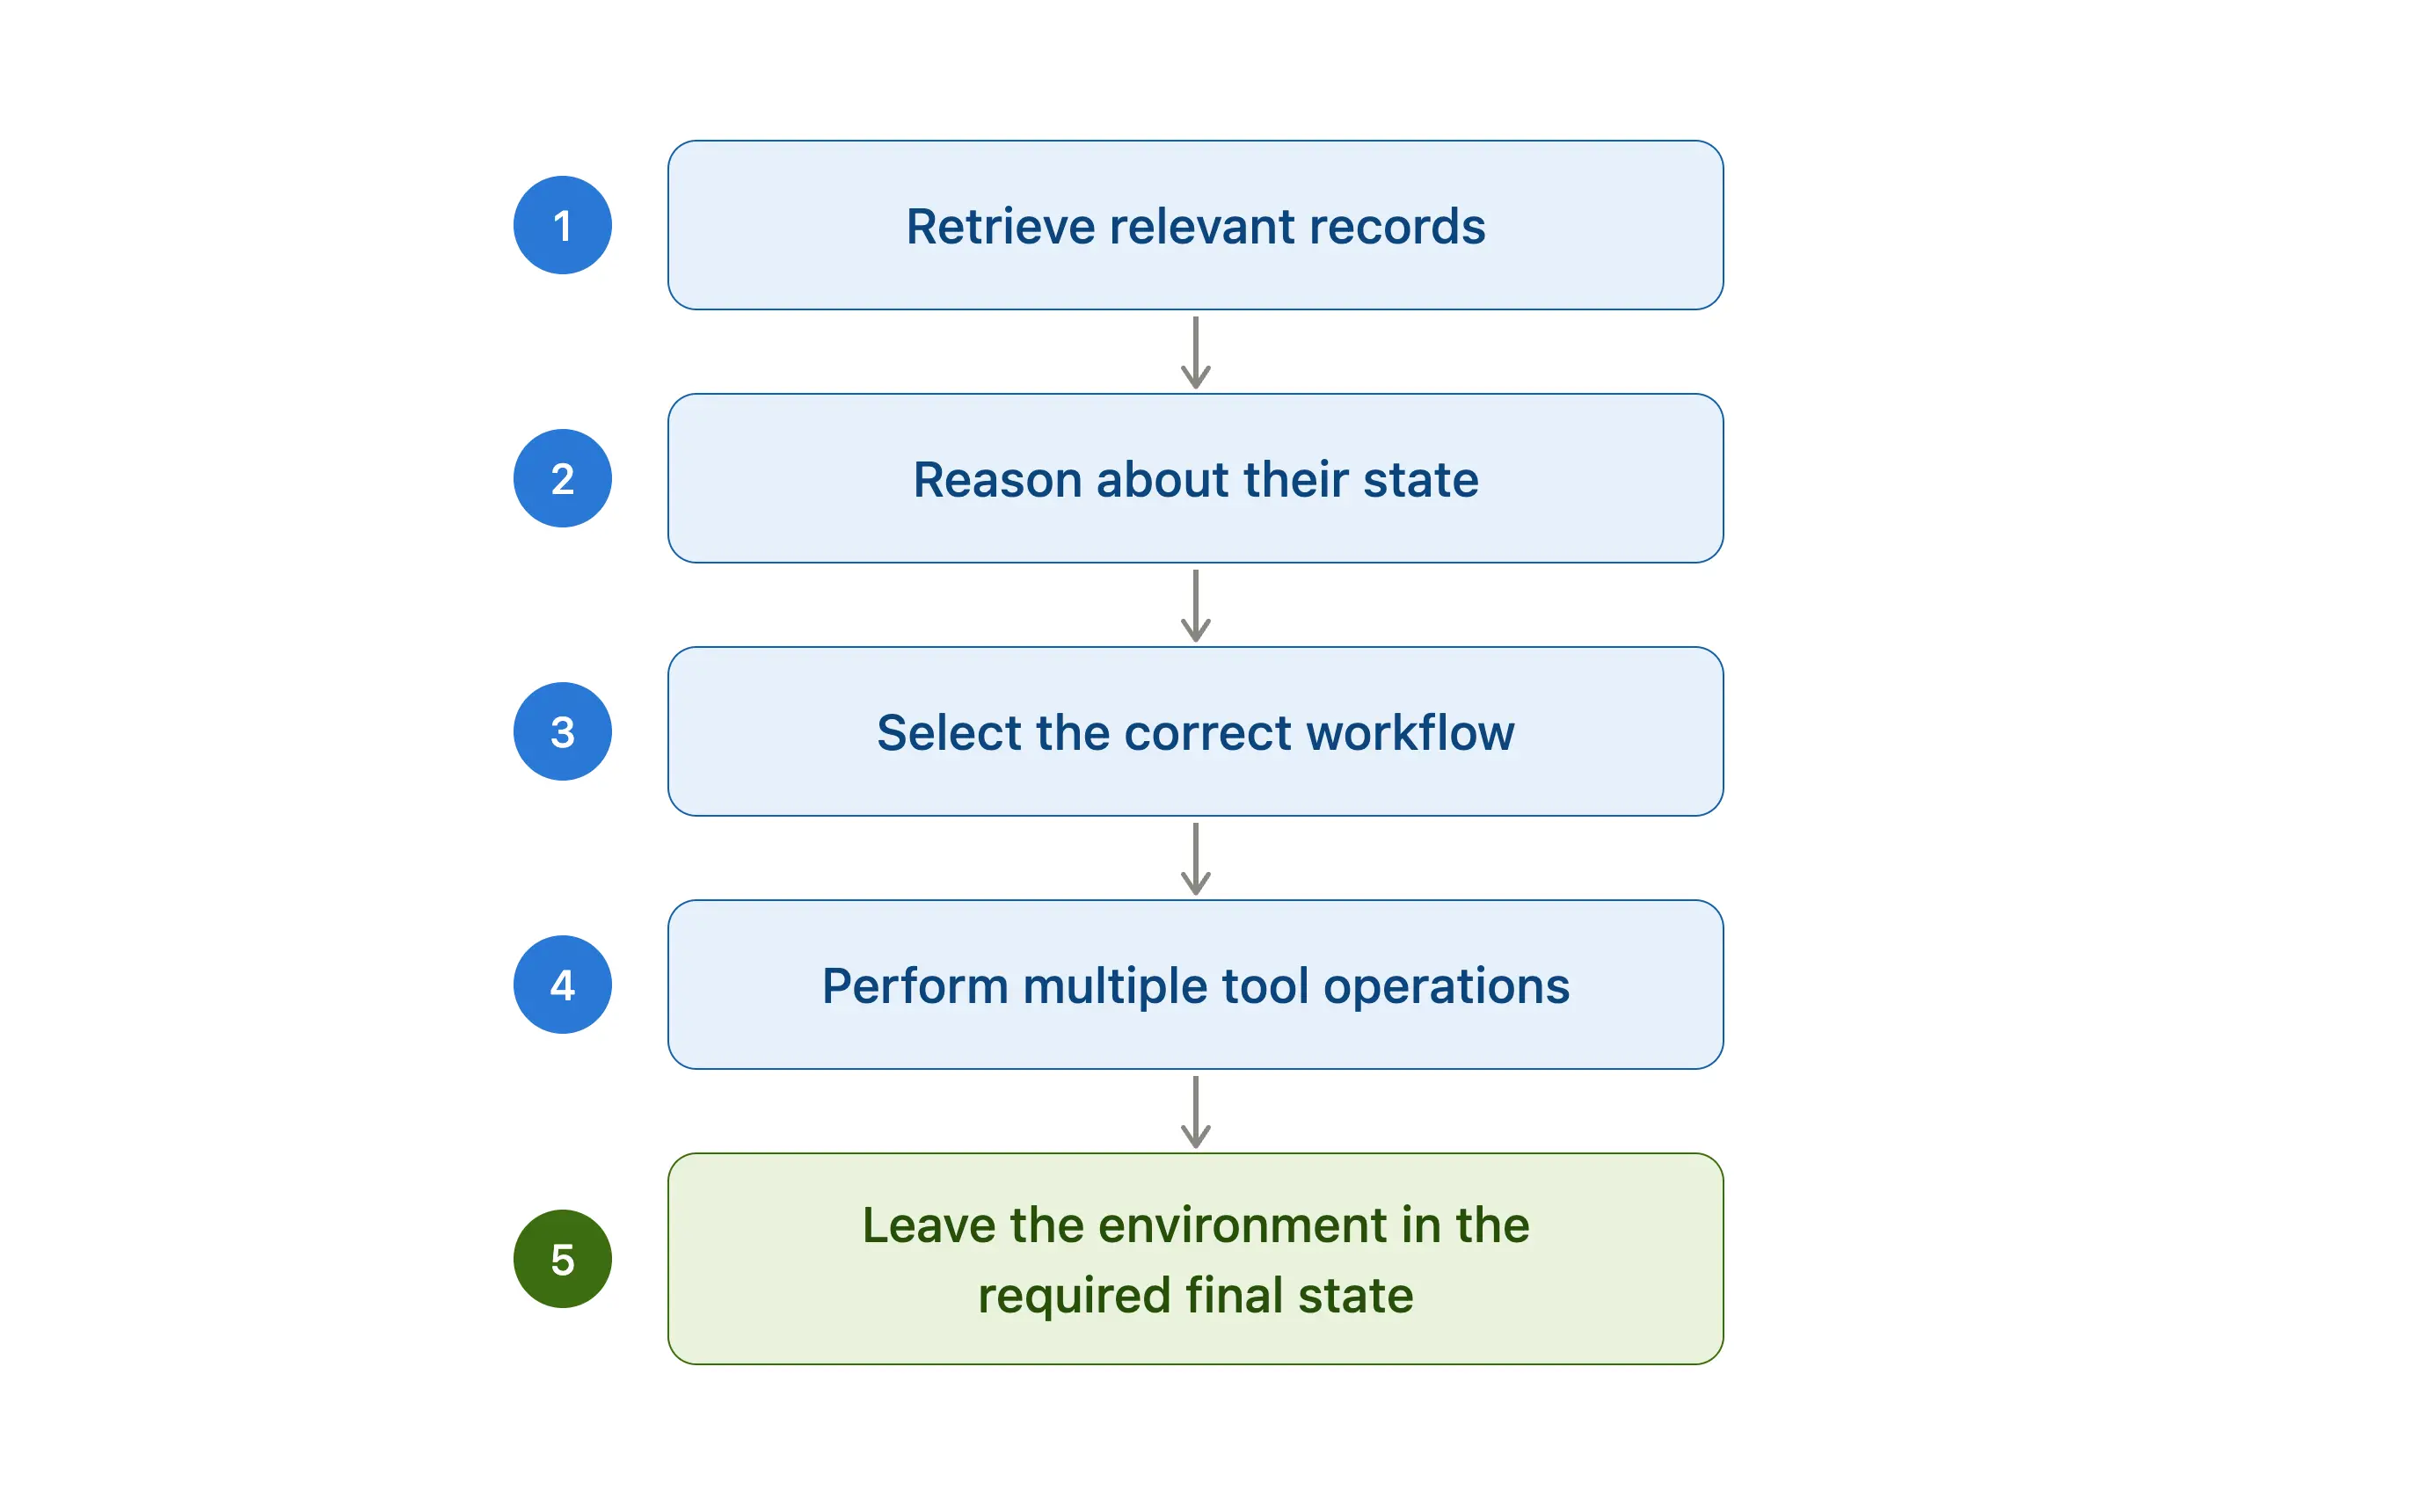
图 4:一个目标模型表现不佳的工作流示例。
生成器会创建演练这一工作流的新任务,并变化实体、初始环境状态、工作流组合、工具组合、措辞与难度。随后更强的教师为每个任务演示一条成功轨迹。对监督微调(SFT)而言,这些演示教会目标模型如何在新情境里运用该能力。
AutoSynthData 分两个阶段构建数据集:先生成并验证核心样本,再把它们扩展为新颖变体。
Target(核心集)
target 阶段从能力规格出发,创建核心训练样本。多个 worker 并行生成独立任务,做完一个就接下一个目标。每个候选都要经过验证、执行、求解器评估与修复才能被接受。产出的是一批经过审查的样本,围绕目标模型需要学的东西构建。
Multiply(扩增)
multiply 阶段通过对已被接受的核心样本创建新颖变体来扩展数据集。每个变体都有自己的用户请求、环境状态、实体配置、参考轨迹与验证器,并且必须通过同样的验证与执行检查。一个关键约束是:扩增样本不能再作为另一个扩增样本的种子。这把扩展锚定在已审查的核心集上,限制跨代漂移。
实现细节
为了同时支持两个阶段,AutoSynthData 把生成控制与环境相关执行分离:一个共享控制器协调生成、质量控制、覆盖度与数据集构建;一个适配器负责环境执行、任务与状态管理、参考回放、确定性验证、求解器执行与任务画像。
并行的核心生成 + 扩增,共同构成了一条通往训练规模数据集的路径。而它们的价值取决于施加在每个候选上的检查:任务必须可执行、解法必须有效、验证器必须能区分成功与失败。
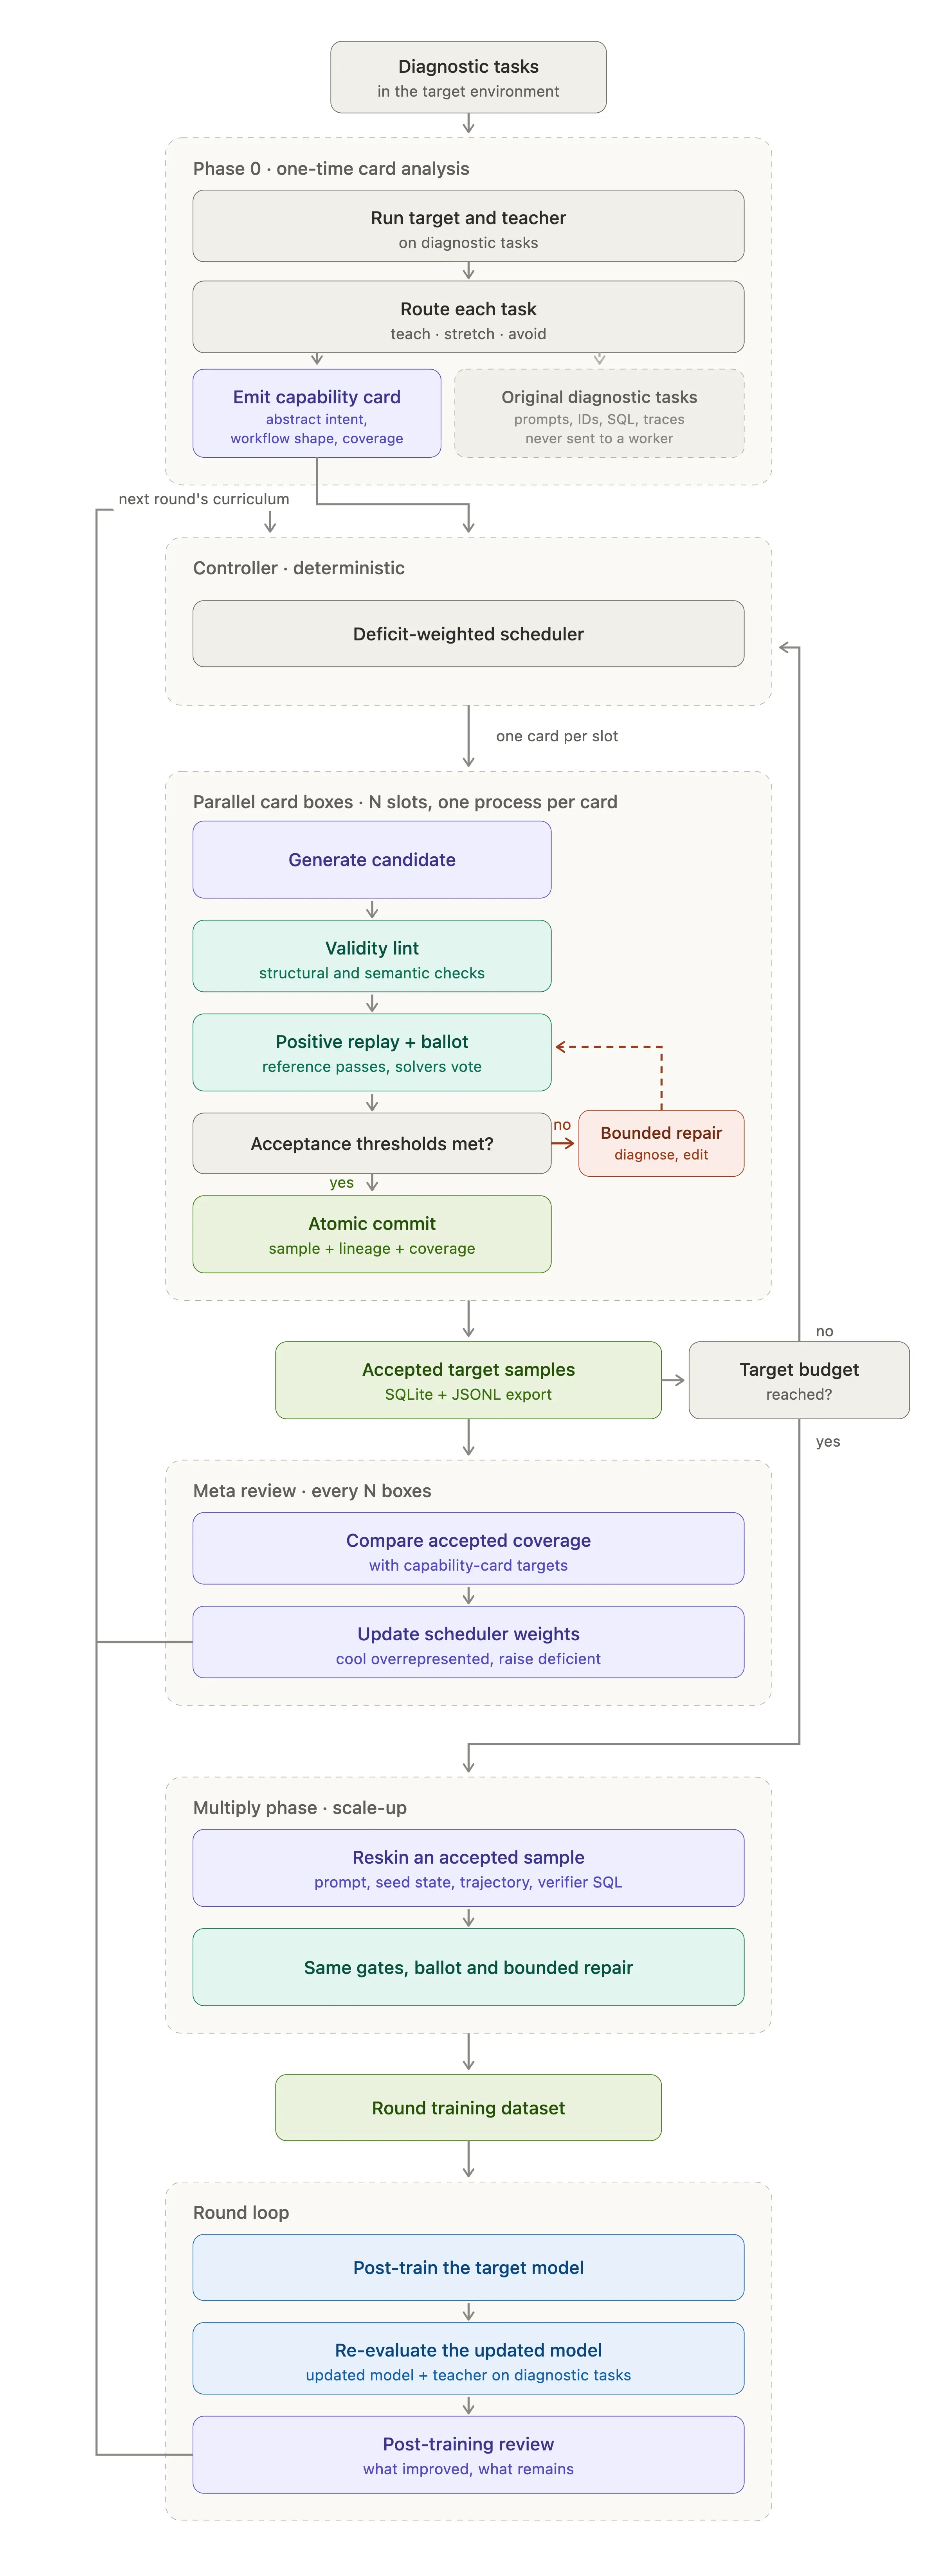
图 5:target → multiply 的双阶段数据集构建。
五、高质量的合成数据,不止于"生成"
生成一个看似合理的请求,并不足以产出有用的训练数据。一个任务可能在目标环境里根本不可行,它的参考解法执行时会失败,或者它的验证器会奖励错误的最终状态。AutoSynthData 在接受任务用于训练之前,会检查这些性质。
它在两个层次上审查质量:单个候选必须通过验证,批次必须提供有用的覆盖度与多样性。
样本级验证与修复
每个候选在进入训练数据集之前,都必须先过一道质量控制回路。首先是求解器评估来衡量难度。在本文所用配置里,作者偏好这样的任务:目标模型在三次尝试中最多解出一次,而更强的求解器在三次中至少解出两次。候选还要经过正向与负向验证,以及一个有界的修复过程。
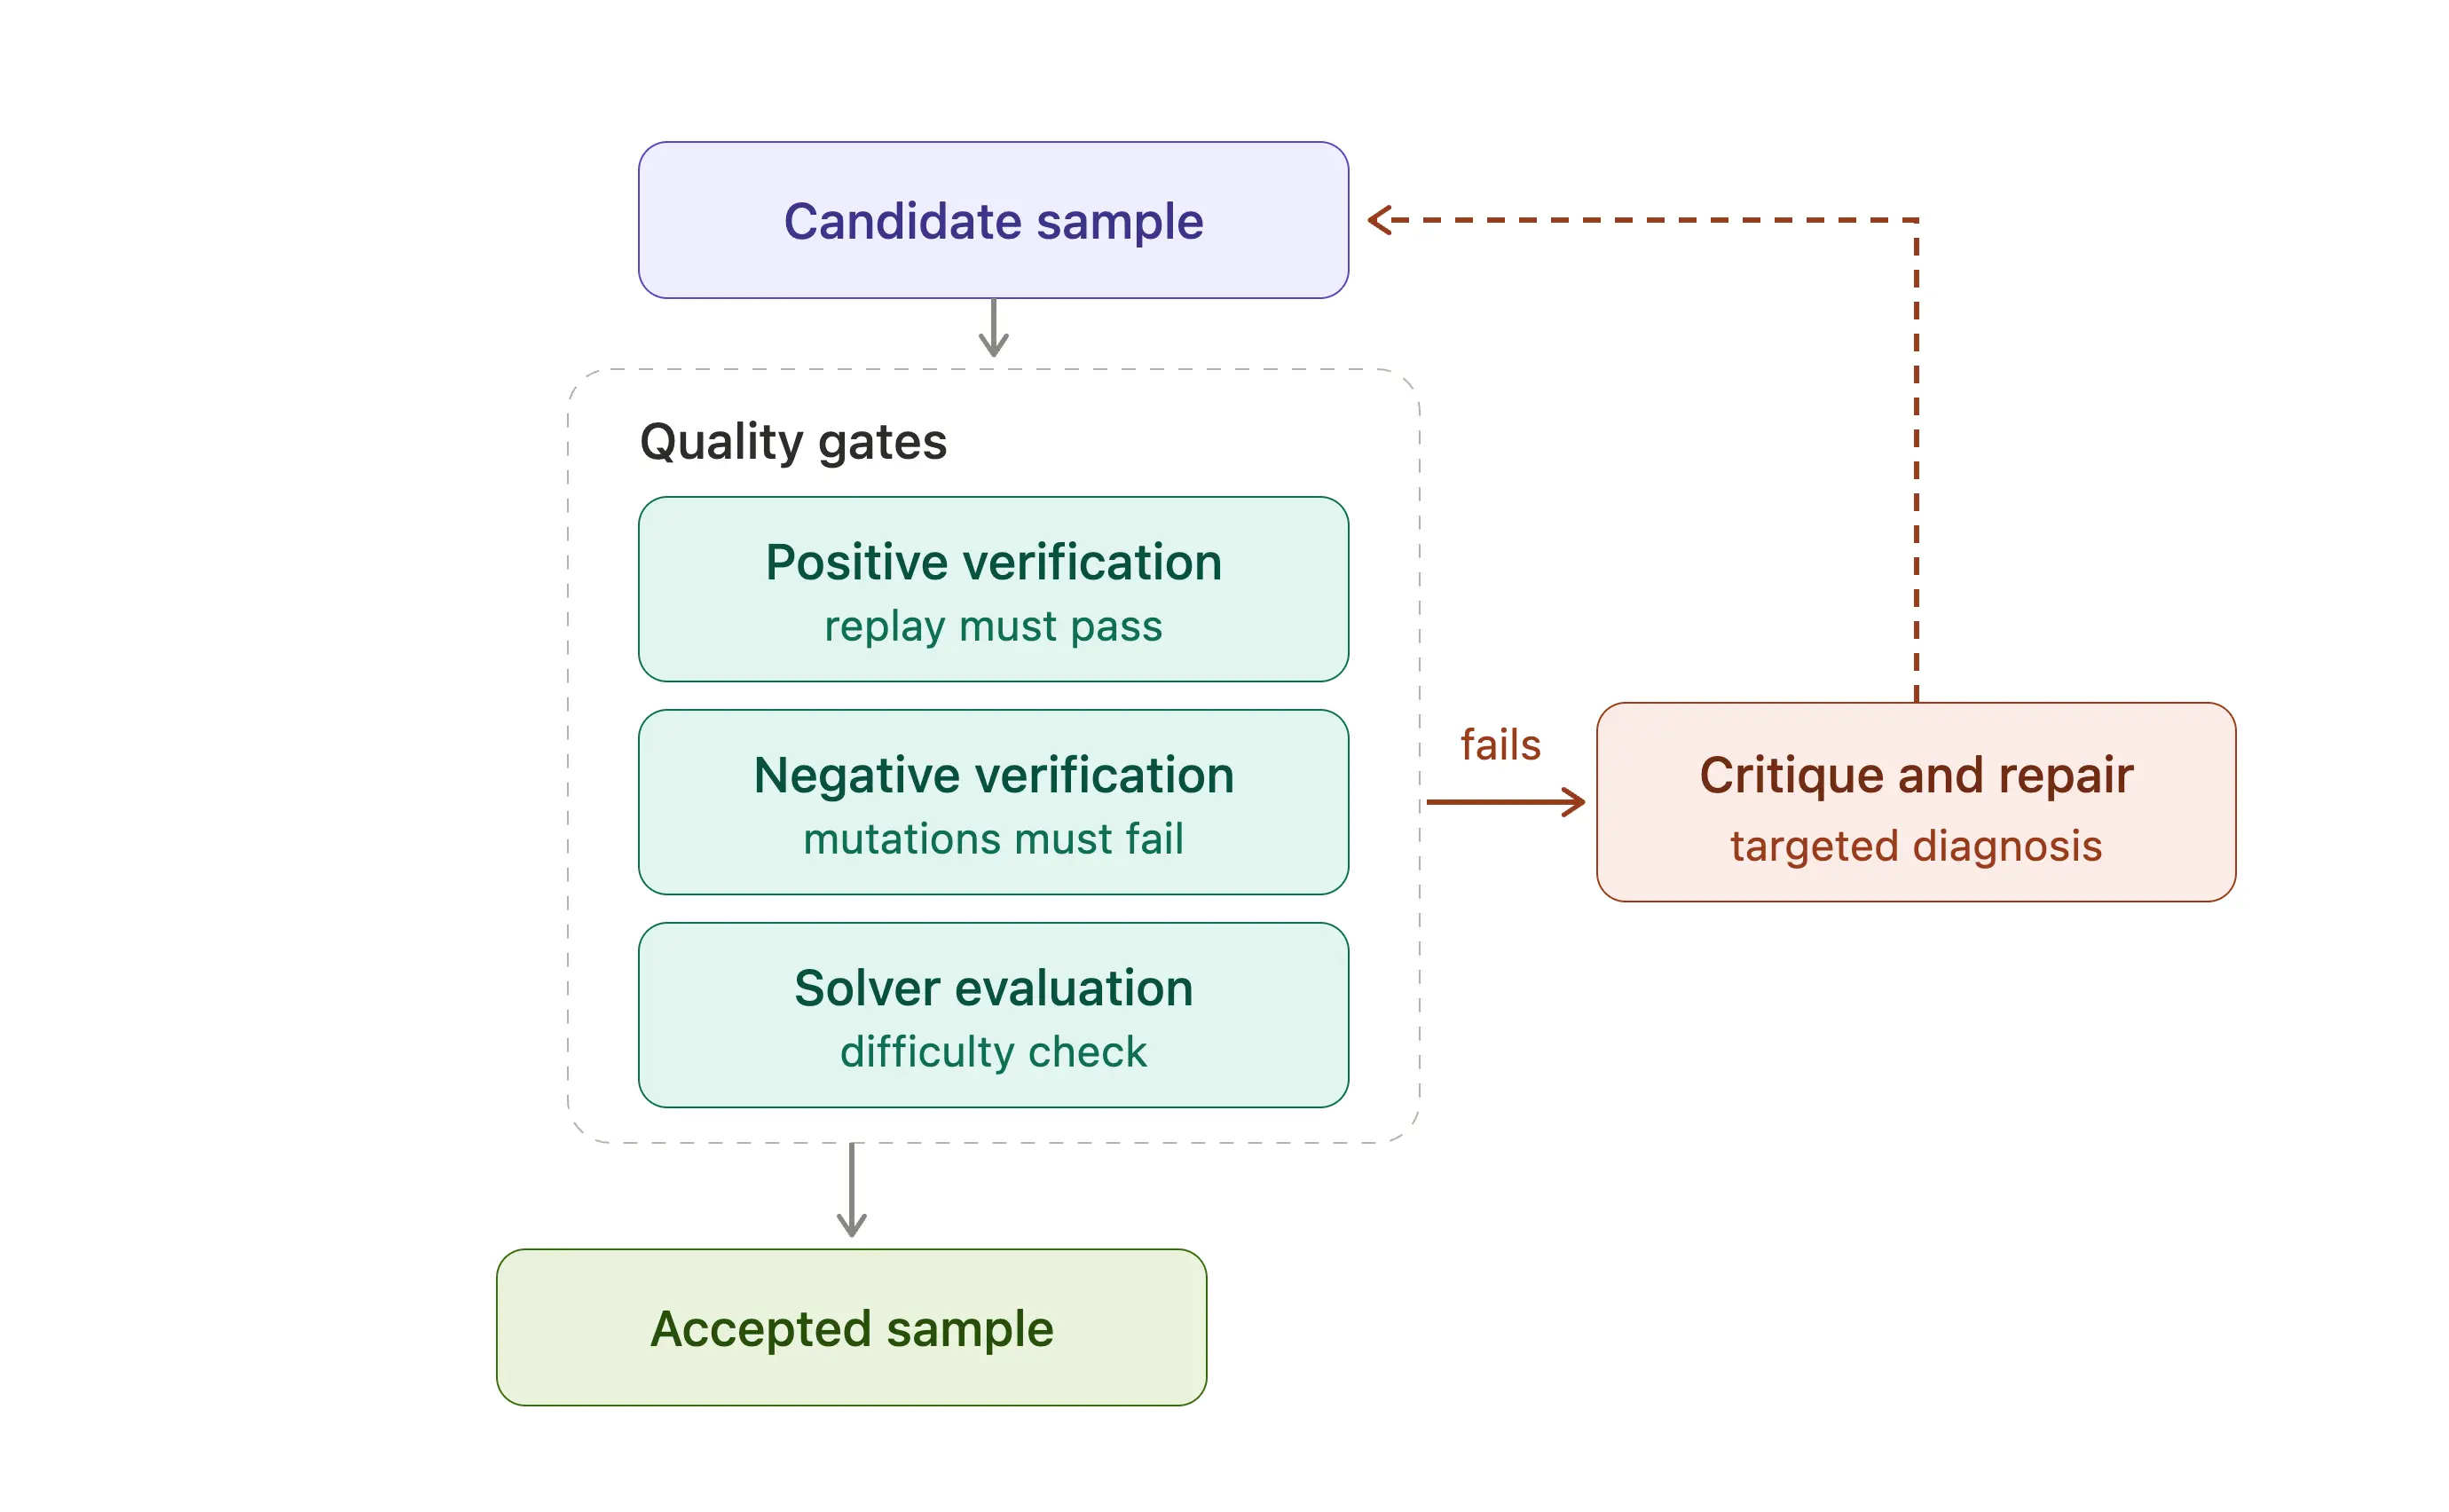
图 6:样本级质检回路。
- 正向验证(Positive verification):问的是"预期的解法能解出这个生成的任务吗?"流水线在目标环境里执行参考轨迹,把得到的状态与候选的验证器对照。这会暴露提示、初始状态、解法与成功判据之间的不一致;
- 负向验证(Negative verification):问的是"相关的错误结果会失败吗?"例如,它可以变异期望结果的一部分,并确认那些状态不再通过验证。这能抓住那些不要求预期行为、却仍然给成功的弱验证器;
- 批评与修复(Critique and repair):失败的候选不会被直接丢掉,而是先送去批评器。批评器考察样本及其失败,寻找不一致的状态、不可能的工作流、错误的任务构造、糟糕的参考轨迹、薄弱的验证器逻辑,或与目标能力不匹配之处。批评结论指导修复,且重试次数有固定上限。
candidate
    ↓
failure
    ↓
critique / diagnosis
    ↓
targeted repair
    ↓
run the gates again
    ↓
accept or retry
修复后的任务必须重新通过相关检查。诊断的作用是指导对现有候选的修复,而不是要求从头重新生成。
通过这些检查让样本有资格用于训练,但单个有效的样本仍可能组成一个重复、失衡的数据集。因此 AutoSynthData 还要在批次层面审查生成。
批级审查
一个批次可能过度代表少数几个简单任务族、漏掉某个能力,或者把过多生成预算花在低产出的模式上。
一个元审查(meta-review)会考察每个批次里的已接受样本、已拒绝样本与生成行为,并追问:
- 哪些任务族被过度代表,哪些能力维度缺失?
- 是否反复出现同类型的样本?
- 是否有特定目标持续生成失败?
- 批评里是否出现系统性问题?
- 下一批次应当改变哪些指导?
控制器会跟踪已接受数据集里的覆盖度、减少过度代表区域的生成、并把更多工作导向缺口。当某个区域反复产出劣质候选时,批评与元审查会引导生成策略的改变。这些调整在可用的生成预算与数据集规模要求内,平衡有用的学习信号、任务质量、覆盖度、多样性,以及低冗余。
这两层反馈回路同时改进任务与数据集:样本级检查指导候选修复,批级审查指导未来生成。
六、推动训练前沿
有用的训练分布会随着模型进步而变化。 AutoSynthData 把合成数据生成视为在目标模型能力边界附近进行的任务搜索:难到足以暴露弱点,又可解到让教师能提供可靠演示。
后训练之后,作者在同一个环境里评估更新后的模型。它现在能稳定解决的任务,对下一轮训练就不那么有用了;而持续失败的地方,则指向仍需关注的能力。 这些结果可以指导下一轮生成。
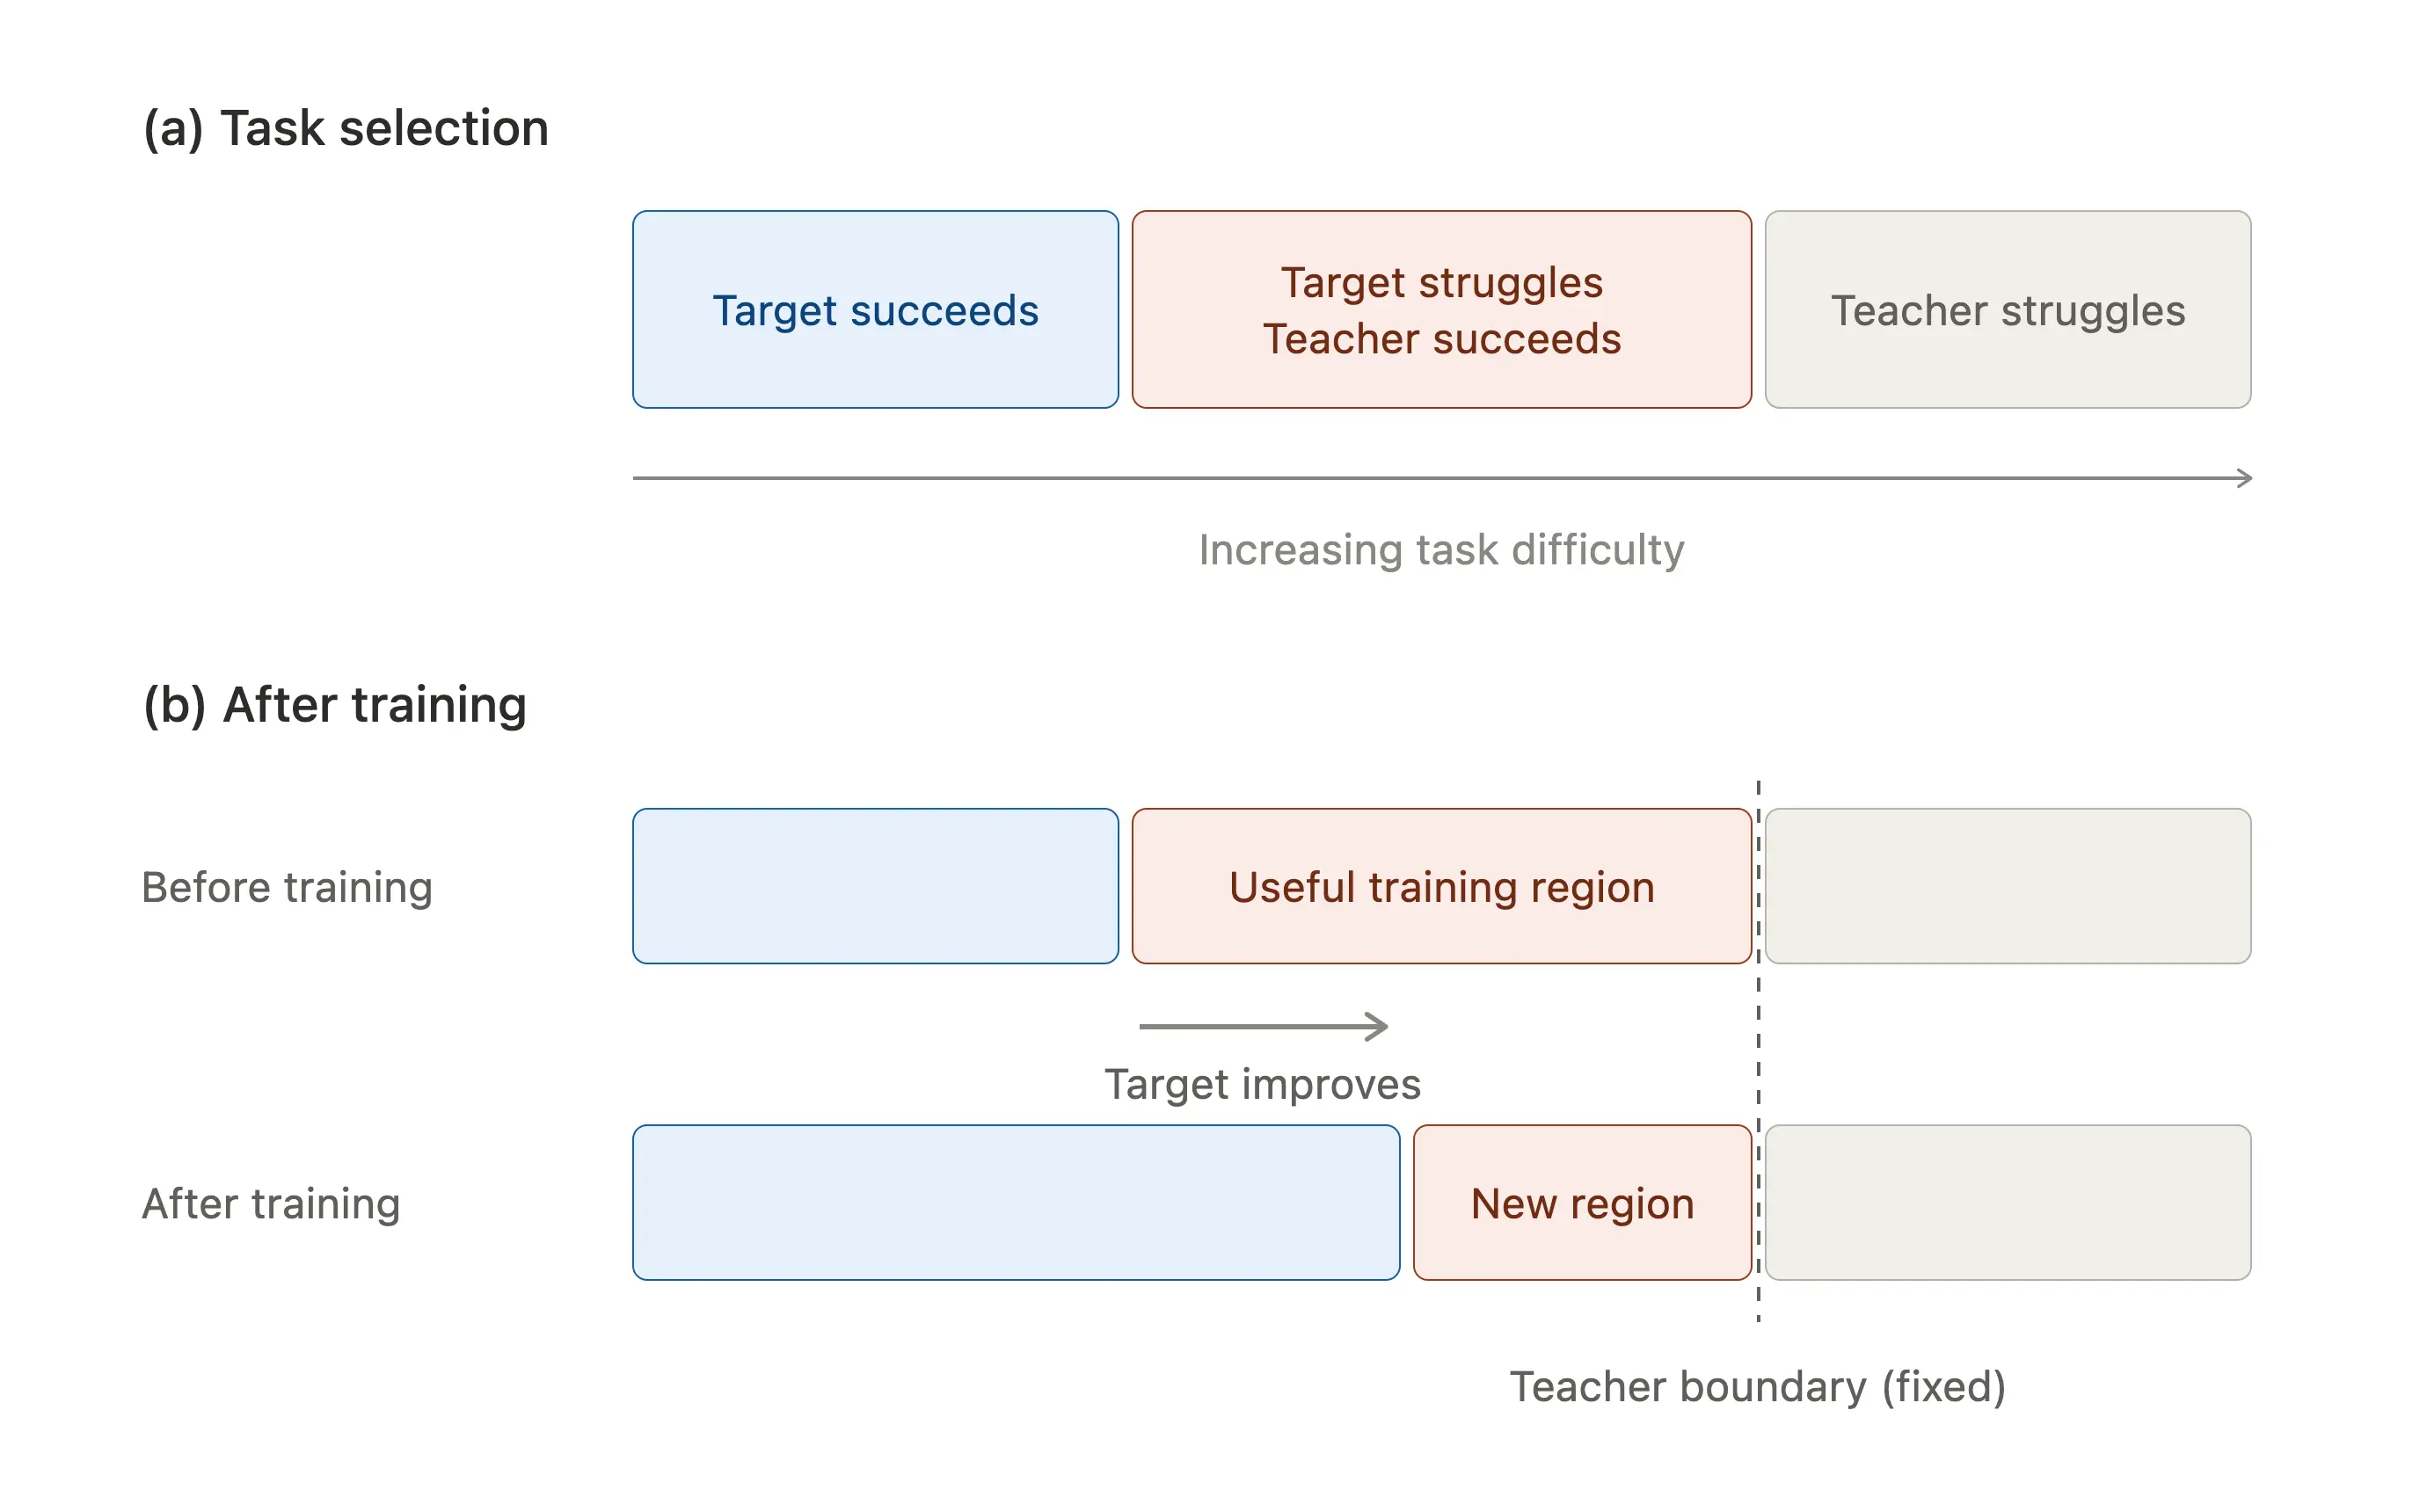
图 7:训练前沿随模型能力提升而移动。
作者的实验聚焦 SFT,但同一机制也可以支持强化学习(RL):生成挑战当前策略、并提供可靠学习信号的任务,训练,然后随更新后的策略移动生成目标。作者计划在 SFT 之外测试这条移动的、难度校准的前沿。
七、EnterpriseOps Gym 实验
作者用 EnterpriseOps Gym 来测试:这套方法能否在有状态的企业环境里改善模型。他们在 Gym 的 Hybrid 与 ITSM 环境中生成训练任务,在被接受的样本上微调目标模型,再评估所得 checkpoint。
Hybrid
在 EnterpriseOps Gym 的 Hybrid 域上,目标模型是 Gemma-4-26B-A4B-it,教师是 Qwen3.8-27B。
AutoSynthData 在约 18 小时内生成了 2,000 个合成训练样本。作者用它微调 Gemma,并在基准上评估得到的 checkpoint,最佳 checkpoint 出现在第 5 个 epoch。
结果:
- 合成 SFT 的 checkpoint 让 mean Pass@1 提升 7.2 个百分点,相对提升 35%;
- 验证器成功率从 63.01% 升到 68.55%;
- 它弥合了 Gemma 与参考模型之间原始 Pass@1 差距的 59%。
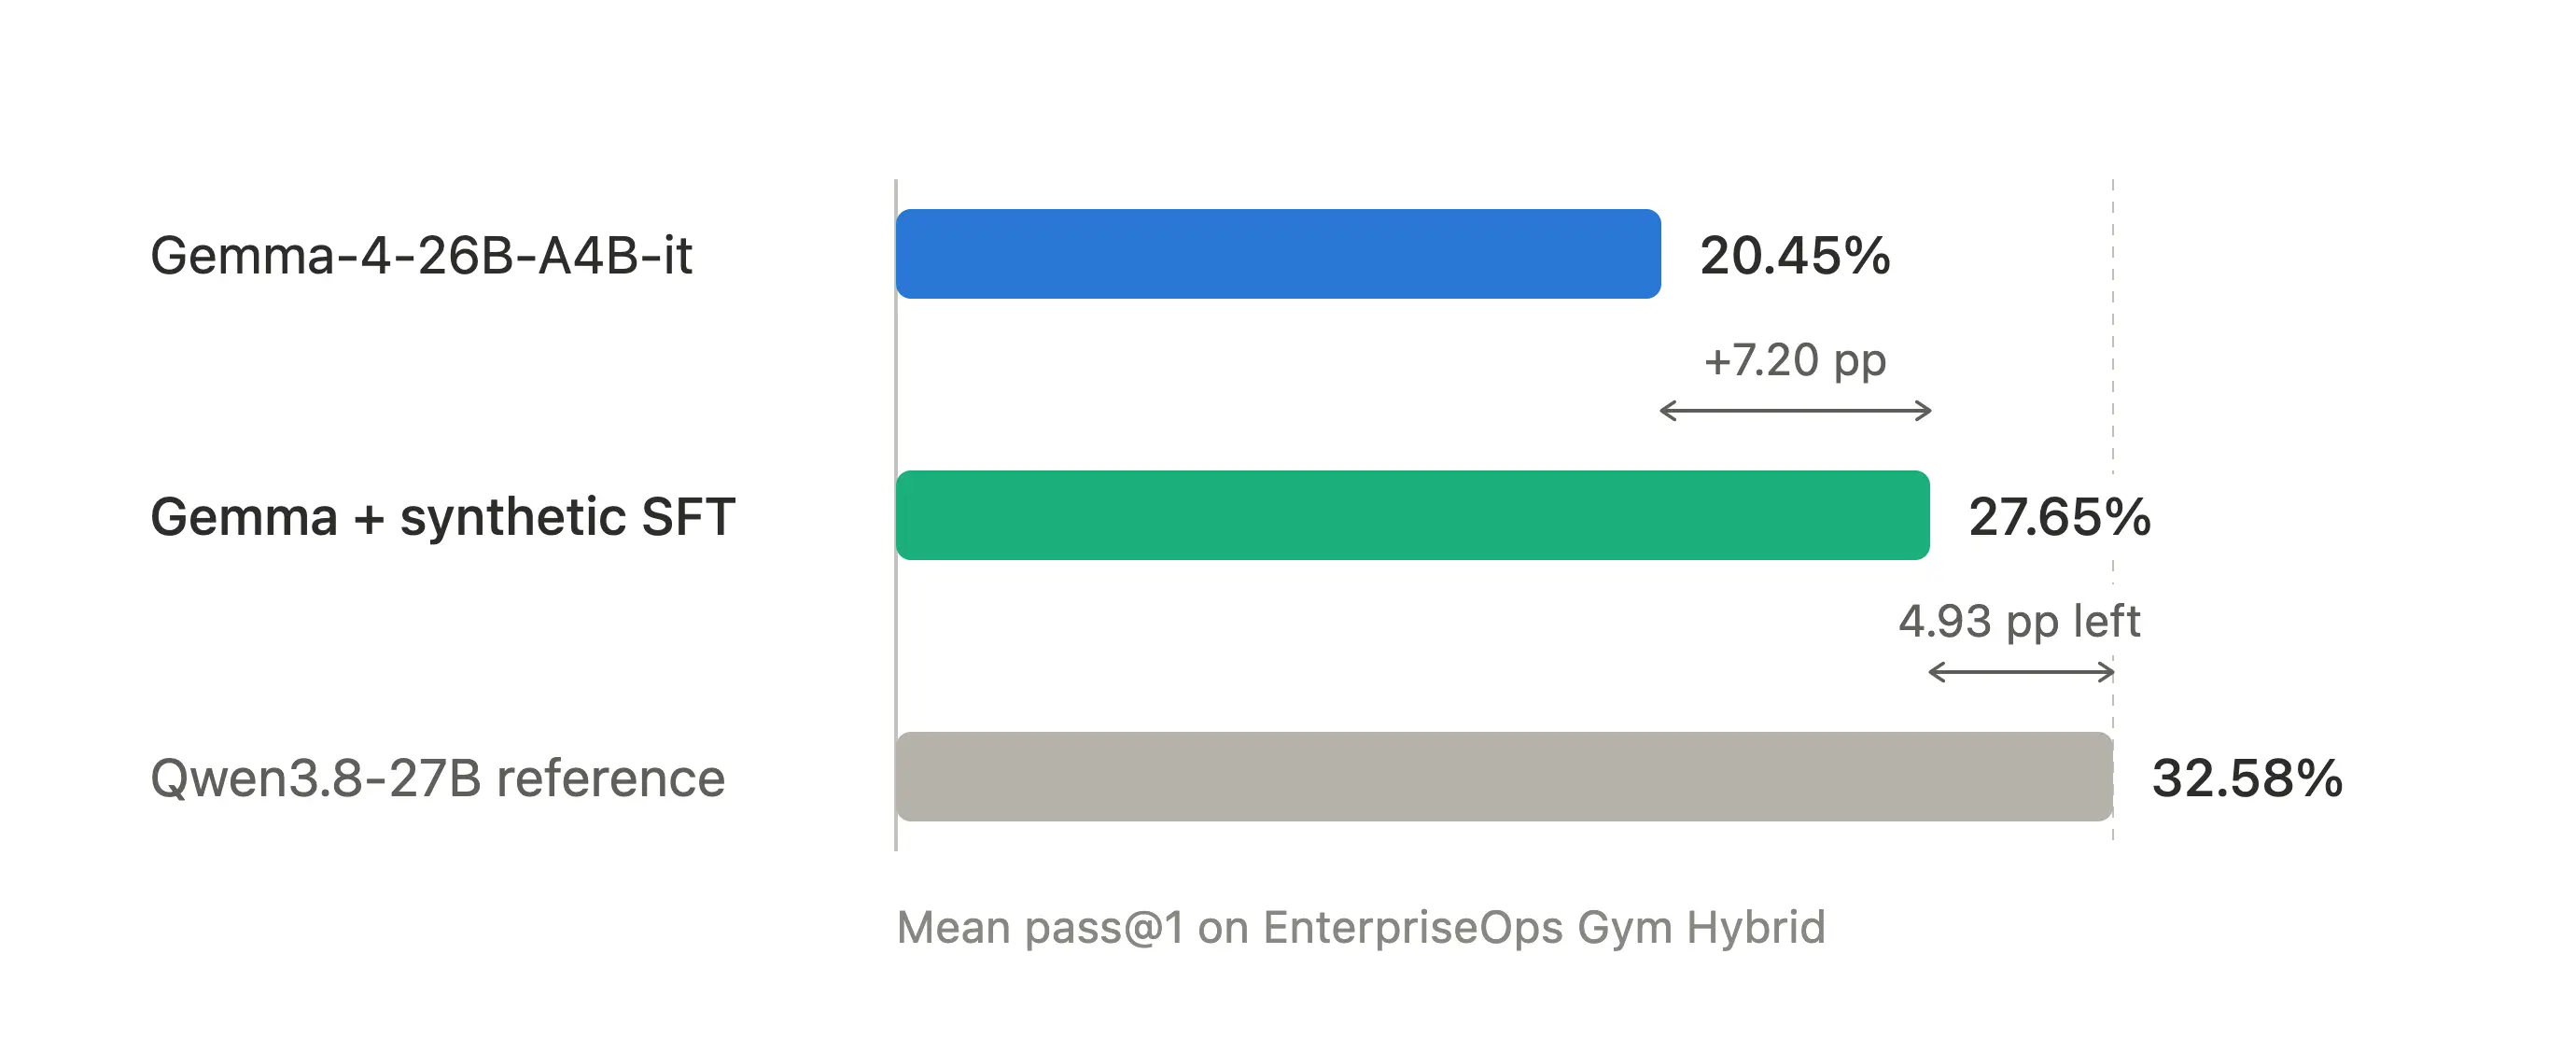
图 8:EnterpriseOps Gym Hybrid 上的结果。
需要强调:训练任务是从能力规格新生成的,生成器没有拿到原始评估任务。这个结果证明了在该实验所用环境中的改善。
ITSM
作者也把 AutoSynthData 应用到 EnterpriseOps Gym 的 ITSM 域,目标模型仍是 Gemma-4-26B-A4B-it,教师换成 DeepSeek-V4.1-Flash。AutoSynthData 在 66 小时内生成了 1,994 个合成训练样本。
生成比后面那次 Hybrid 运行慢得多,主要因为 ITSM 用的教师模型更大,而且这次运行早于后来提升吞吐的流水线优化。
在 ITSM 上,合成 SFT 把 mean Pass@1 从 18.77% 提到 27.18%,说明这套方法在第二个领域同样有效。
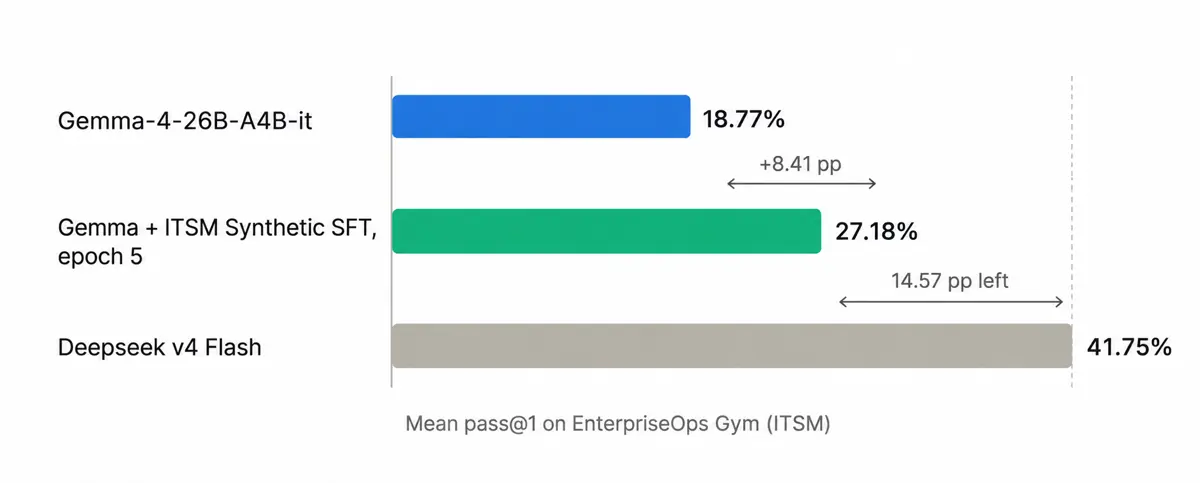
图 9:EnterpriseOps Gym ITSM 上的结果。
八、闭环
最有用的训练任务,取决于环境,也取决于在其中工作的模型。 AutoSynthData 用模型的失败来决定生成什么,用环境来验证新任务,并把这些任务提供给后训练。EnterpriseOps Gym 的结果展示了这套方法在受控环境里的价值。当模型发生变化时,同一个流程可以聚焦到仍然存在的缺口上。
九、给企业 Agent 团队的启示
结合论文,几点判断值得记下:
- "能力缺口"比"数据规模"更值得当起点:从目标模型在该环境里的失败模式出发,而不是先堆一个通用指令集;
- 规格卡是正确的抽象层:它把"该学什么"与"具体题目"解耦,既避免了对评估集的记忆,也让生成可以规模化变化;
- 验证器是这套流水线的真正瓶颈:可行性、真实性、难度三者里,难度靠求解器评估、真实性靠人审与模式约束、可行性靠环境执行——没有可靠的验证器,合成数据只会放大噪声;
- 双层质检不可省:样本级负责正确性,批级负责覆盖度与多样性;只有前者会得到一批正确但重复的样本;
- 课程要跟着模型移动:训练分布不是一次性确定的,模型学会的东西会立刻贬值为训练信号;
- SFT 只是起点:作者明确指出同一机制可扩展到 RL,这很可能是后续企业 Agent 后训练的主战场。
对正在自建 Agent 的企业来说,这篇工作的价值不只是两个 benchmark 数字,而是一套可复用的方法论:用失败定义课程、用规格卡抽象能力、用环境与验证器守住质量、用批级反馈控制覆盖度。
参考来源
- Hugging Face / ServiceNow CoreAI:《AutoSynthData: Generating Training Data for Enterprise Agents》(2026-10-02)https://huggingface.co/blog/ServiceNow-AI/autosynthdata
- EnterpriseOps Gym 论文(Malay et al., 2026):https://arxiv.org/abs/2603.13594
- EnterpriseOps Gym 数据集:https://huggingface.co/datasets/ServiceNow-AI/EnterpriseOps-Gym
- 目标模型 Gemma-4-26B-A4B-it:https://huggingface.co/google/gemma-4-26B-A4B-it
- 教师模型 Qwen3.8-27B:https://huggingface.co/Qwen/Qwen3.8-27B
- 教师模型 DeepSeek-V4.1-Flash:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
延伸阅读(本站)
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。