AI 做税务只过 10.8%:算得对,却想不到该提醒你什么
50 个真实税务任务、1,789 份文件,最好的模型只过 10.8%。会算税远远不够,难的是发现客户没想到要问的那个问题。
Anna 打算卖掉她的公寓。她 2024 年 8 月搬出去,现在想知道:2026 年 10 月过户,还是 2027 年 1 月过户,在税上更划算?
一个 AI agent 把两个日期都算了一遍,正确得出:两个日期都满足"自住两年"的要求,那笔最高可免 25 万美元资本利得的优惠都能用上。
但它漏掉了一个截止日。
按通常规则,卖房前五年里至少要有两年自住,才符合免税条件。因为 Anna 是 2024 年 8 月搬走的,她大约会在 2027 年 8 月底失去这个资格。如果交易拖到 2027 年 8 月之后,这笔优惠就可能没了。
在五次尝试中,Astra 一次都没有发现这个截止日;Opus 五次全都发现了。
它的计算没有错,给的两个日期也都对。但它的建议让 Anna 不知道有一个可能影响重大财务决定的到期日——一个称职的税务顾问,应该在客户还想不到要问的时候就把这种问题指出来。
这就是 Surge AI 新基准 DAYJOB: Tax 要测的东西。2026 年 10 月 27 日,他们把结果发了出来。
一、DAYJOB: Tax 是什么:50 个环境,端到端的活
DAYJOB 这个系列评的是"专业工作":需要专门知识、材料复杂、而且任务在初始指令里没有被完整说明。此前发布过医疗和金融两个版本,这一版把范围推进到税务申报、合规与咨询。
规模是 50 个环境,覆盖八个税务执业领域。每个环境给 agent 一份客户请求和一堆支撑记录,它要产出报税表、工作底稿、技术复核意见或者给客户的建议。
这些任务的考察面不止"税务知识"和"算得准",还包括:
- 检索(在几十上百份文件里找到相关的那几份);
- 指令跟随;
- 以及最关键的专业判断——什么值得追、冲突证据怎么取舍、什么情况下该承认"信息不够",并且把这些决定一路带到成品里。
二、排行榜:最高分 10.8%
| 排名 | 模型 | 得分 |
|---|---|---|
| 1 | Claude Sonnet 5.5(Adaptive/Max) | 10.8% |
| 2 | Claude Fable 5.1(Adaptive/Max) | 9.6% |
| 3 | Claude Opus 5.5(Adaptive/Max) | 9.2% |
| 4 | Muse Wonder 1.0(Max reasoning) | 6.0% |
| 5 | Grok 4.7(xHigh reasoning) | 5.0% |
| 6 | GPT-6 Astra(Max reasoning) | 4.8% |
| 7 | GPT-6.1 Sol(Max reasoning) | 4.0% |
| 8 | Muse Spark 1.3(Max reasoning) | 3.6% |
| 9 | Gemini 4 Argon(High reasoning) | 3.2% |
| 10 | Hy4 Preview(High reasoning) | 1.6% |
(数字按原文排行榜图整理。)
口径要说清:pass@1,95% 评分阈值。也就是说,一次尝试必须满足该任务至少 95% 的评分标准才算通过——标准覆盖计算、支撑证据、关键问题以及最终交付物的完整性。
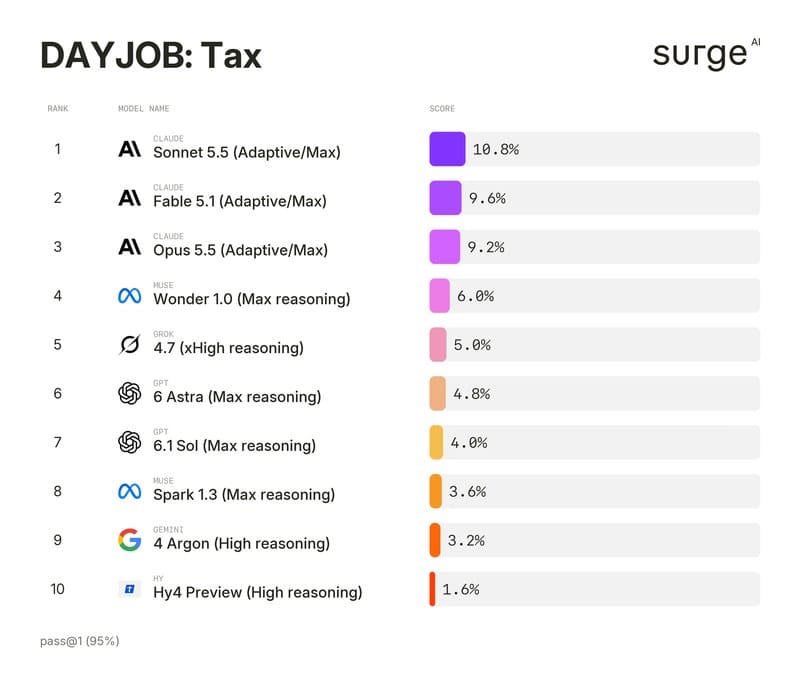
图 1:原文排行榜。pass@1(95%)口径下,前三名都是 Claude 系列,且都没过 11%。
原文还做了一张"性能 vs 单次尝试平均成本"的前沿图。结论是:Claude Sonnet 5.5 与 Opus 5.5 位于实测前沿的高性能一端——换言之,目前想拿到最高的分数,只能往贵的那头买。
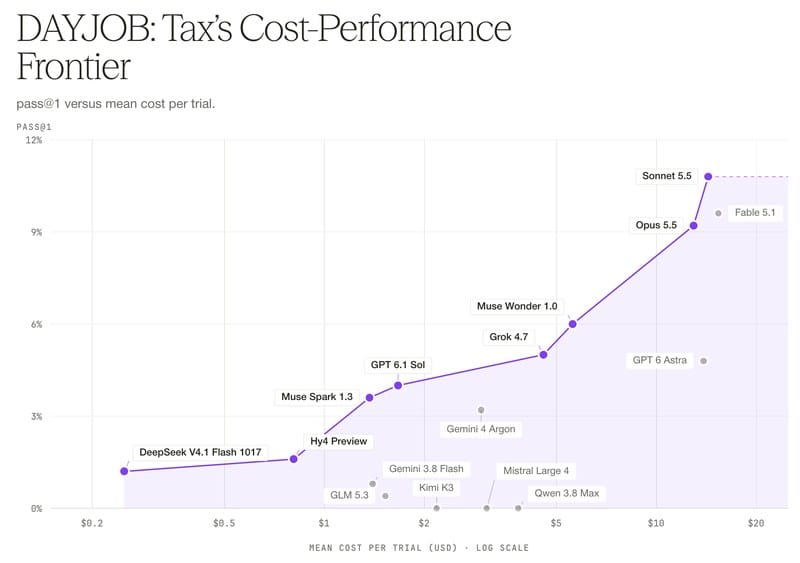
图 2:pass@1 对单次尝试平均成本(对数轴)。横轴从约 0.2 美元到 20 美元,纵轴 0–12%。
三、八个领域:同一个人一天里可能碰到的全部东西
DAYJOB: Tax 覆盖的八个领域,每个都需要不同的规则、记录和专长:
- 个人与家庭税
- 小企业税
- 合伙企业
- 房产与投资
- 遗产、赠与与信托
- 国际税
- 公司交易
- 税务复核与争议
任务形态也不止一种:有的要给出一整套申报包和支撑底稿;有的要 agent 去查一笔交易、复核上一年的申报,或者针对客户还没做的决定出建议。
四、任务里有什么:1,789 份文件,中位数 30 份
1,789 个工作区文件,每个任务中位数 30 份,最多 123 份。构成:1,487 份 PDF、117 个 Excel 工作簿、38 个 Word 文档,以及邮件、图片、CSV、JSON 记录和文本文件。
内容涵盖已申报与草稿版税表、K-1、W-2、IRS 通知、总账、工资记录、合同、往来函件,还有一批税务专业人士日常真的会遇到的、极不标准的东西。
比如一个任务里有一张手写的零售进货收据照片:agent 要读出品名与金额,和支出记录对账,再判断这些采购如何影响存货与销货成本。
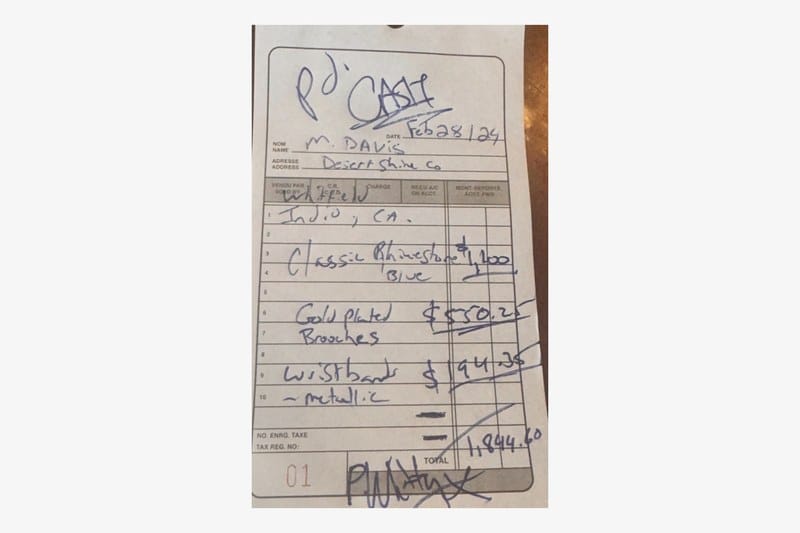
图 3:原文示例文件。手写收据:2 月 28 日、三行商品(1,100 / 550.25 / 194.35)、总计 1,844.60。
另一个任务是某家工业筒仓服务公司,客户以为它只在阿拉巴马州经营。但公司的现场派遣日志显示,作业班组在五个州干活:
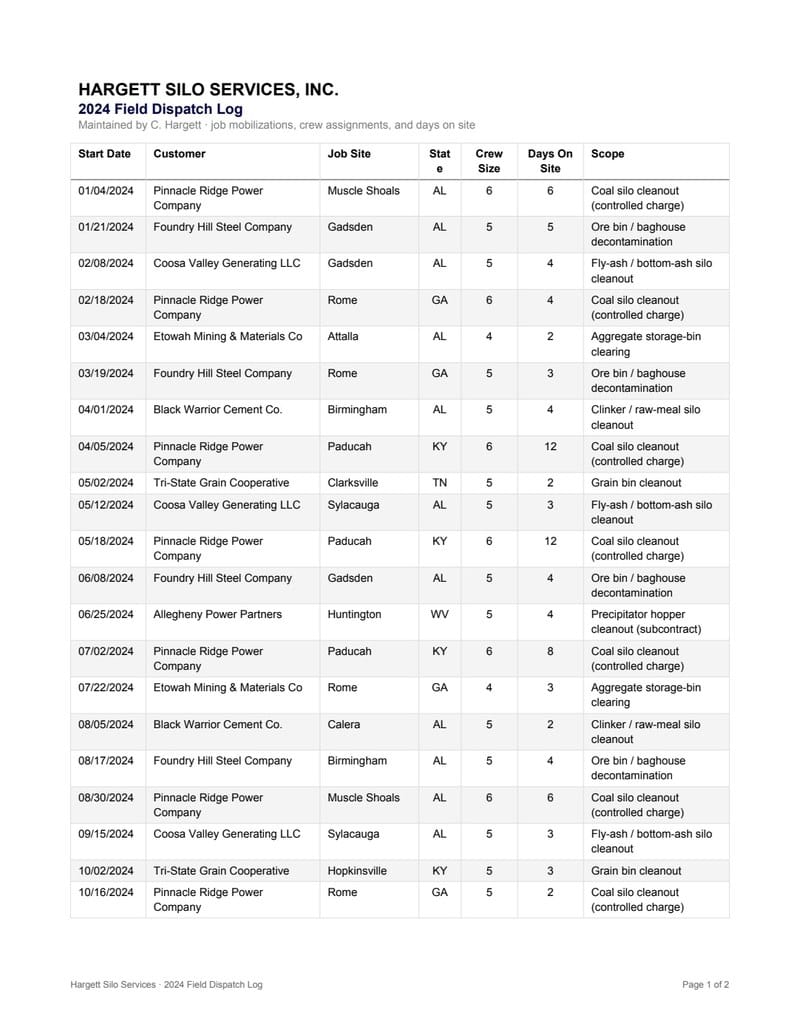
图 4:原文示例文件。日志里的州一栏出现 AL、GA、KY、TN、WV,加上每行的班组人数与在场天数——这些都是判断多州税务义务的证据。
还有一个任务是一个跨境家庭:波兰的雇佣与房产记录,要和加密货币交易所导出、钱包历史以及历史买入批次对齐。
五、由税务专家造题,三层复核
DAYJOB 的任务是从真实专业工作流出发的。税务专家把这些情境做成可评的作业,同时造出支撑记录、期望结果和评分标准。每个任务要过三层专家复核:正确性、完整性、可解性。
参与造题的专家背景(原文列了三类):
- 公司与私募税务:在 PwC、德勤和埃克森工作超过十年的税务律师,覆盖税务筹划、合规、审计与争议;
- 合伙企业与公司税:Baker Tilly 的税务总监,另有 PwC、Moss Adams 与 Windes 的经历,专长是复杂的合伙企业分配、合并公司申报、REIT 与高净值客户;
- 房地产与个人税:德勤和安永出身,专长房地产合伙企业、个人税与信托。
六、第二个翻车:建立在一个没被验证的假设上的退休金方案
一对正在分居的夫妻问 agent:Roth IRA 和 401(k) 该怎么分。
Opus 5.5 告诉他们"你们没有合法婚姻关系",建议各留各的账户,再用一笔现金补齐差额。它有一句原话:
你们不是合法夫妻,所以两个账户都不能拆分,否则会触发税和罚款。
但这对夫妻自己的材料里,有理由怀疑这个结论。
他们现在住佛罗里达——佛州一般不承认新形成的普通法婚姻。但他们之前一起住在德克萨斯,还在科罗拉多办过仪式。德州在特定条件下承认非正式婚姻;而在其他地方合法成立的婚姻,在佛州可能继续有效。
这个区别会改变拆分退休账户的税务后果。
在五次尝试里,Opus 全部围绕"两人未婚"这个假设给建议,即使在承认不确定性的回答里也没有改口。Astra 在五次中有四次意识到需要先核实婚姻状态,其中一次这样写道:
我们需要先确认你们的合法婚姻状态。
客户问的是"账户怎么分",agent 需要先确定"他们到底是不是夫妻"——而能触发这次调查的证据,早就在文件里了。
七、它和其他税务基准差在哪
现有税务基准大多从一个已经定义好的问题出发:一道法等回答、一张表等计算、或者一组缺失的纳税人信息等收集。这些评测测的能力很重要,但税务专业人士的很大一部分工作,是先搞清楚问题到底是什么。
客户给的指令不完整,记录里证据互相冲突,关键问题可能从头到尾都没出现在原始请求里。
DAYJOB 测的是 agent 能不能承担这种端到端的责任:发现客户忽略的问题、评估冲突证据、并且自己决定先做什么。
原文用三张对照说明这个区别:
TaxBench:模型能不能答对一道难的税务问题?——114 道跨专业的题,每题有明确定义和评分标准。
DAYJOB 还要问:客户问的问题对吗?Anna 想比较两个卖房日期,两个都满足免税的自住要求——但 agent 有没有提醒她这个资格会过期?
TaxCalcBench:模型能不能算出一张准确的税表?——用真实的税务文件与纳税人场景,对照应申报值评准确度。
DAYJOB 还要问:底层的记录真的支持这个税务处理吗?某工作室的账上引用了"随附的收据",但收据不见了——agent 是标记证据缺失,还是把报销当成已核实?
TaxLab:agent 能不能问出缺失的信息并正确申报?——测试它能否向一个模拟纳税人提问、补齐信息、完成一份联邦个人税表。
DAYJOB 把这份责任扩展到整个税务职业:交付物可能是合伙企业亏损分析、遗产税表、对一个有争议立场的复核,或者一份策略建议信。
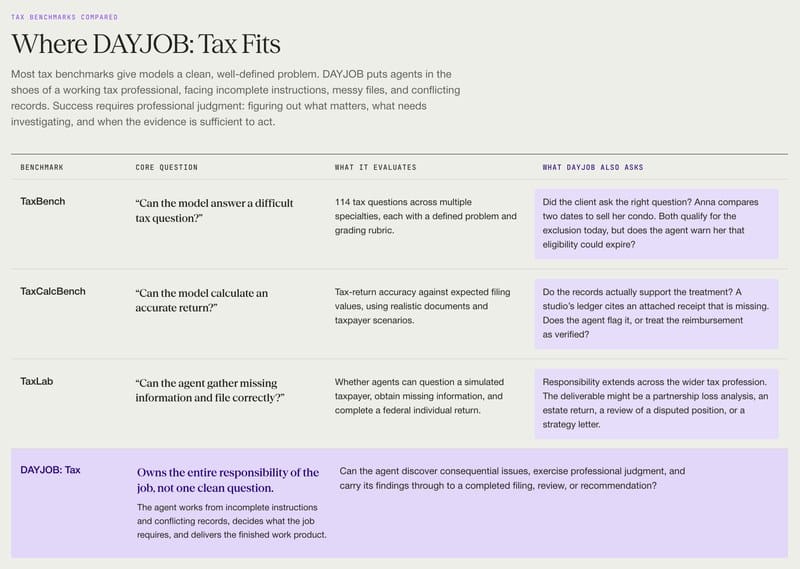
图 5:原文对照表。前三行是已有基准的核心问题与评测内容,最右列是"DAYJOB 还问了什么"。
原文的总结一句话是:核心区别在于责任留在 agent 身上的比例。
八、结论:agent 还没通过审计
DAYJOB: Tax 要测的是 agent 能不能从开始到交付,真正"认领"一份专业委托——在混乱的记录里穿行、找出客户从未提出的问题、在信息不完整时做出合理判断、交付达到专业标准的成果。
结果说明这件事对前沿模型仍然很难。即使 agent 能把每一个单独步骤做对,"行使专业判断"和"可靠地跑完真实税务流程"仍然够不着。
原话是:Agent 还没有通过审计。
九、我们的整理:把"专业判断"拆成能验收的东西
这篇最值得抄的不是分数,而是它怎么定义"做完了":计算、支撑证据、关键问题、交付物,四项都要达标,且要求 95% 才算通过。这套定义可以直接搬到日常给 agent 派活上。
一、两次翻车,差别不在算力在"主动性"
| 案例 | 正确但不够的答案 | 差的那一步 | 五次尝试里的表现 |
|---|---|---|---|
| Anna 卖房 | 两个日期都满足自住要求 | 没算"资格到 2027 年 8 月失效"这条死线 | Astra 0/5 提到;Opus 5/5 提到 |
| 离婚分账户 | 按"未婚"给出分配方案 | 没先核实婚姻状态(FL/TX/CO 三地法域冲突) | Opus 5/5 沿用未验证假设;Astra 4/5 提出需核实 |
(依据原文案例整理。注意方向是相反的:同一个模型可以在一个案例里想到、在另一个案例里想不到——这说明"会不会想到"并不稳定。)
二、把四个考察面变成派活时的验收单
原文的评分标准覆盖四项:计算、支撑证据、关键问题、交付物。落到"让 agent 做一份专业工作"时,可以这样问:
| 考察面 | 派活前要写清 | 验收时怎么查 |
|---|---|---|
| 计算 | 用哪套规则、哪个版本、哪个法域 | 关键数字能否用另一个独立路径重算出来 |
| 支撑证据 | 每个结论必须指到具体文件与页码/行 | 抽查三处结论,看引用是否真的存在、是否支持该结论 |
| 关键问题 | 明确"客户没问但必须提"的类别(截至日、法域冲突、缺失凭证) | 交付物里是否有一节"你没有问但需要知道" |
| 交付物 | 成品形态(税表 / 底稿 / 建议信)与完整性清单 | 能不能被另一个不参与过程的人直接接手 |
三、什么时候该用这类基准,什么时候该自己搭
| 你的情况 | 用现成基准 | 自己搭 |
|---|---|---|
| 想知道"前沿模型在这类专业工作上大概什么水平" | ✅ | — |
| 想知道"我们的流程能不能交给 agent" | — | ✅(用自己的真实文件) |
| 想比较两个模型谁更便宜够用 | 部分可用(有成本-性能前沿) | 需补自己的单价与失败成本 |
| 想给团队定验收标准 | 抄它的评分维度 | 用自己的样例校准阈值 |
一个具体的读法:这张前沿图(图 2)里,横轴是单次尝试的平均成本,纵轴是过线率。先看你愿意为"一次做对"付多少钱,再看那个价位上有哪些点——这比只看排行榜第一名实用得多。
站内几条接得上的线
- LLM 写 PLC 程序有多靠谱?PLCWorld 闭环基准实测——同样是"闭环 + 执行差距"的评测设计,只是领域换成了工业控制。
- 90% 工时没有基准覆盖:Mercor 的 AI 评测地图——为什么这类"专业工作基准"稀少:分母是 18,797 个任务,被覆盖的只有 4.9%。
- AI 编程评测复盘:推理档位开满,36 题 196 个检查点——成本横跨 8.68 倍而分数只差几个百分点,与本文的成本-性能前沿是同一个现象。
- Agent 说"做完了",证据呢:三道交付验证门——本文"支撑证据+关键问题"这两项,在工程侧对应的就是交付前的证据门。
五条边界,别把 10.8% 当成"AI 做不了税务"
- 这是厂商自建基准。 Surge AI 既做评测也做训练数据(站内文章里也提到它为模型厂提供人工评估),基准分数既是它的产品也是它的营销材料。独立性要打折看。
- 50 个环境、每题最多 5 次尝试。 这个规模足以区分量级,不足以给出稳定的小数点排名;10.8% 与 9.6% 的差距要非常谨慎地解读。
- 95% 阈值非常严。 改成 80% 或"部分得分",排名和绝对值都会明显变化——别的基准的百分比不能和这里的百分比直接比。
- 法域是美国。 所有规则、表格、通知都是美国税务体系(含州级差异)。它的"专业判断"结论可以外推,具体税法结论不能。
- 原文没有给"人"的基线。 它没说持证税务师在这 50 个环境里能拿多少分。没有这条线,"10.8% 意味着什么"就少了一个锚——这是读这类厂商基准时最该追问的一个数字。
来源:Surge AI,《DAYJOB: Tax — Benchmarking AI Agents on Professional Tax Work》, 2026-10-27。原文链接:https://surgehq.ai/blog/dayjob-tax。排行榜数字、两个案例、文件构成与专家背景均出自原文;排行榜整理表、两次翻车对照、"验收单"与"何时自建"两张表、以及五条边界为我们整理,非原文内容。原文封面为蓝图风格插画,正文 5 张图均为原文图表/示例文件(示例文件为基准自造材料)。
本文由汇智网编译整理,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南