Google Deep Review 公开发布:AI 试点审阅 16,000 篇论文后,转向通用文档验证
AI 让写文档越来越快,人的验证能力却没有变快。Google 把论文审阅工具 PAT 升级为 Deep Review 并公开发布:四个会议、16,000+ 篇投稿试点,四阶段 Agent 流水线(分段、自适应预算、并行验证、全局综合 + 溯源),现在可用于设计文档、演示稿、法律与财务文档。每周免费 2 次,上传文档不用于训练。
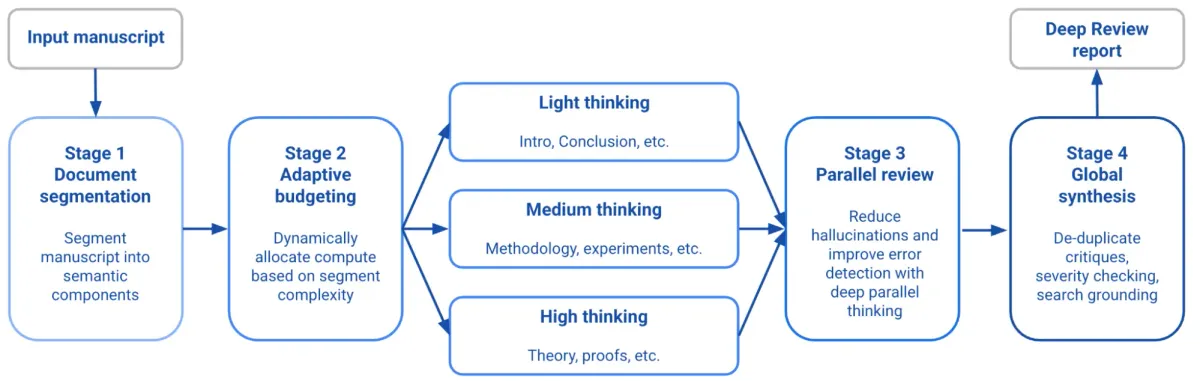
一句话结论:Google 把内部的论文审阅工具 PAT(Paper Assistant Tool) 升级为 Deep Review 并公开发布:过去一年与 STOC 2026、ICML 2026、NeurIPS 2026、ICLR 2027 四个会议合作,为 16,000+ 篇自愿投稿提供了提交前反馈;现在它从"审论文"走向通用文档技术验证——设计文档、演示稿、法律与财务文档都可以用。核心不是"AI 替你判断",而是把逻辑一致性、数学陈述、事实溯源这些最耗认知的检查自动化,高层判断仍然留给人。
本文完整编译自 Google Research 博客《Analyzing technical documents with Deep Review》(2026-10-14),并做中文整理。
一、验证瓶颈:生成在加速,审阅没有
生成式 AI 正在加速各个技术领域:写论文、写技术文档、跑代码、设计实验、起草提案。但内容生产加速之后,验证环节成了新瓶颈——审阅一篇长论文或一份复杂法律协议,需要专业知识和大量时间,而人的验证能力基本是固定的。产出速度超过了审查速度,Gap 越拉越大。
学术审稿是最典型的例子。论文提交量在快速上涨:
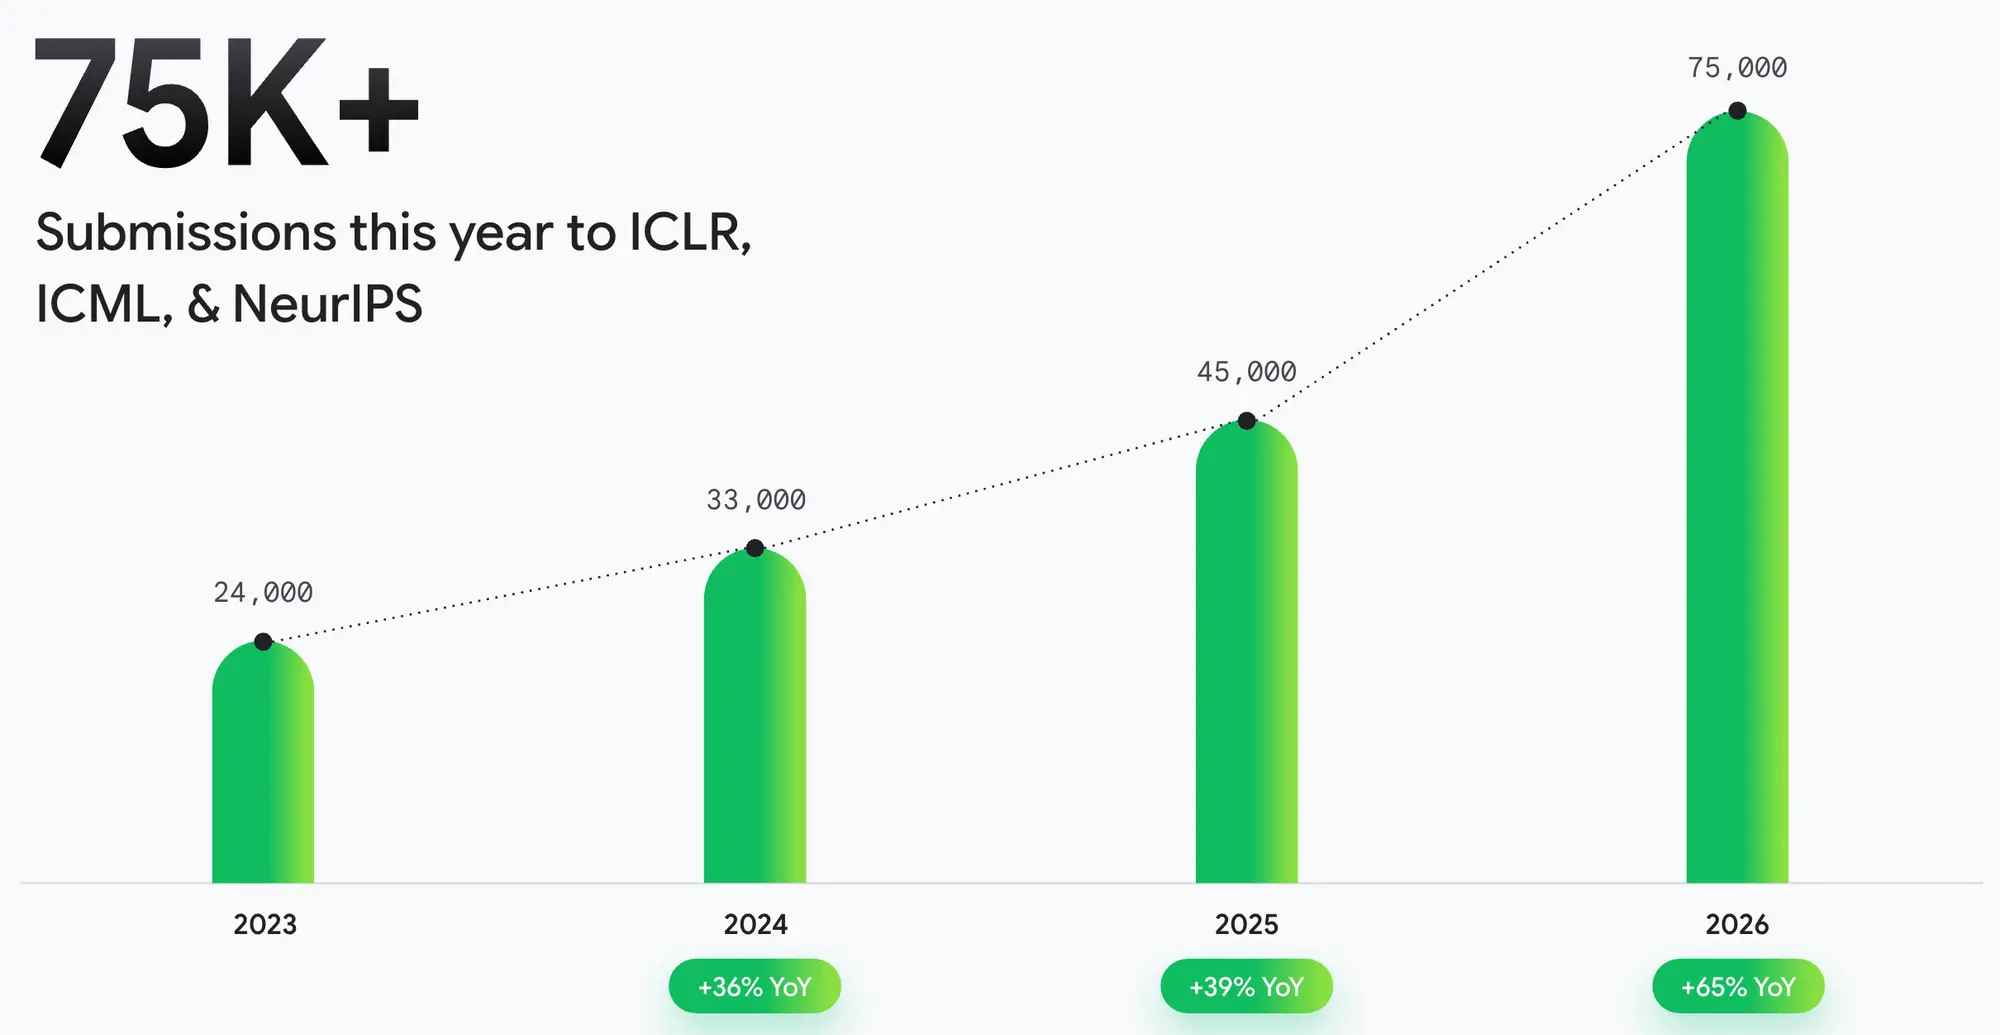
图 1:2023—2026 年 NeurIPS、ICML、ICLR 的提交量变化(来源:Google Research)。
官方给出的数字是:今年三大 AI 会议(ICLR、NeurIPS、ICML)提交量超过 74,000 篇,而 2025 年约 45,000 篇、2024 年约 32,000 篇、2023 年约 23,000 篇。每一篇都需要多份高质量评审,压力全落在人类专家身上。
Deep Review 想缓解的就是这部分负担。它做的是:检查逻辑一致性与数学陈述、提出改进建议、对事实做溯源(grounding)、与已有工作进行对比——处理审阅中最消耗认知的环节,把更高层的判断留给人。
二、从 PAT 到 Deep Review:16,000+ 篇论文的试点
Deep Review 的前身是 PAT(Paper Assistant Tool),一个帮研究者在投稿前"压力测试"手稿的实验项目。过去一年,它与四个旗舰计算机科学会议(STOC 2026、ICML 2026、NeurIPS 2026、ICLR 2027)合作,作者自愿选择参加,在截稿前几周收到对论文的反馈与分析。几个关键设计:
- 反馈与官方评审流程完全解耦——PAT 的意见不进入正式审稿;
- 不收集数据用于训练,每个项目结束后论文会从 Google 系统中及时删除;
- 作者反馈"非常积极",且随着底层模型与 PAT 框架的持续改进而提升;
- 加入 Gemini 4 Argon 支持后,工具的整体能力又上了一个台阶。
试点中的统计数据与作者反馈:
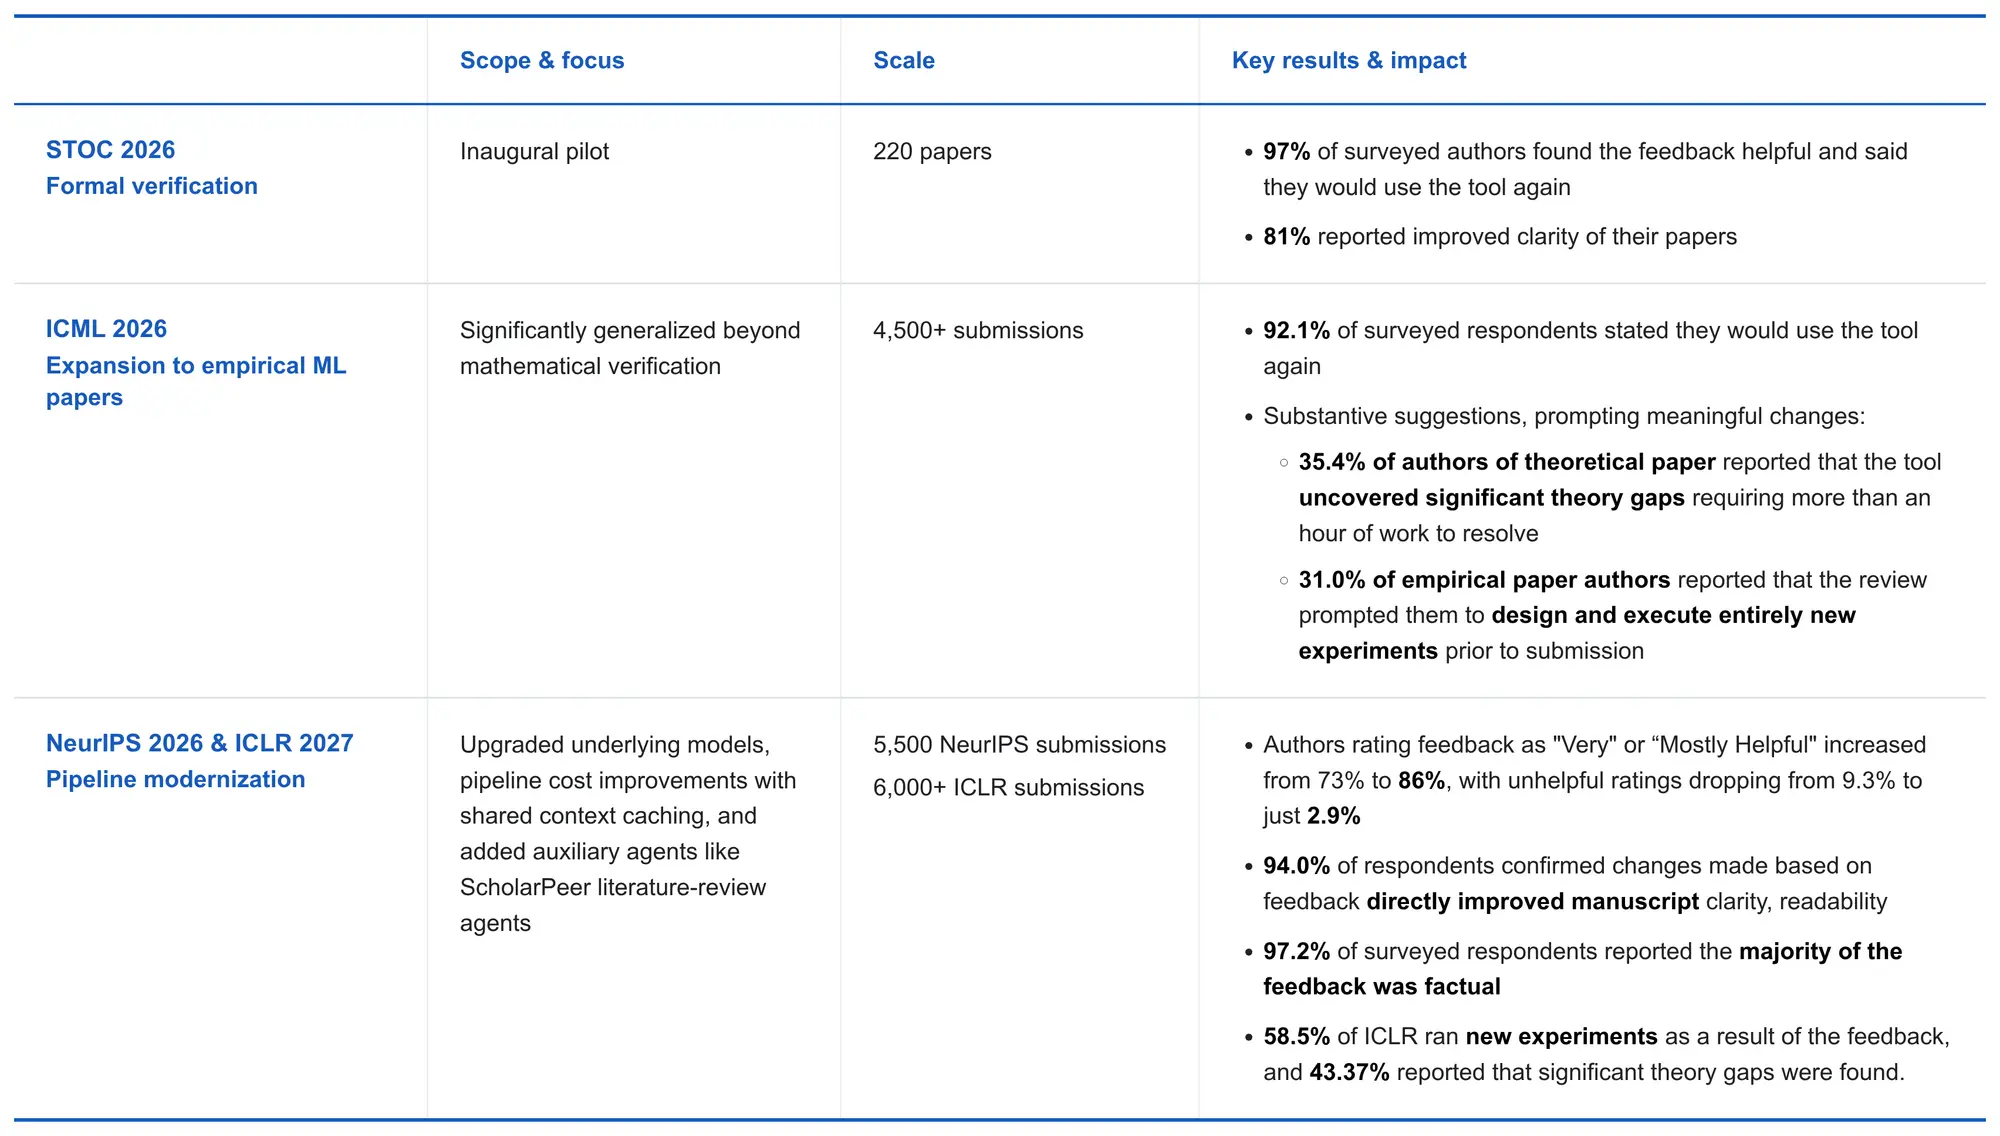
图 2:PAT 在 ML 与理论 CS 会议试点期间的统计数据和作者反馈(来源:Google Research)。
三、四阶段 Agent 流水线
为什么不是"把文档丢给一个长上下文模型询问意见"?官方指出了单次提示(single-prompt)的三个典型失败:
- 推理预算被耗尽——长文档还没分析完,模型的 token 推理预算就用完了;
- 跨章节的长程依赖被忽略——前后文互相矛盾,单次调用看不出来;
- 细微的论断被"放过"——没有逐条严格检查论证链。
Deep Review 用一条四阶段 agent 流水线解决:
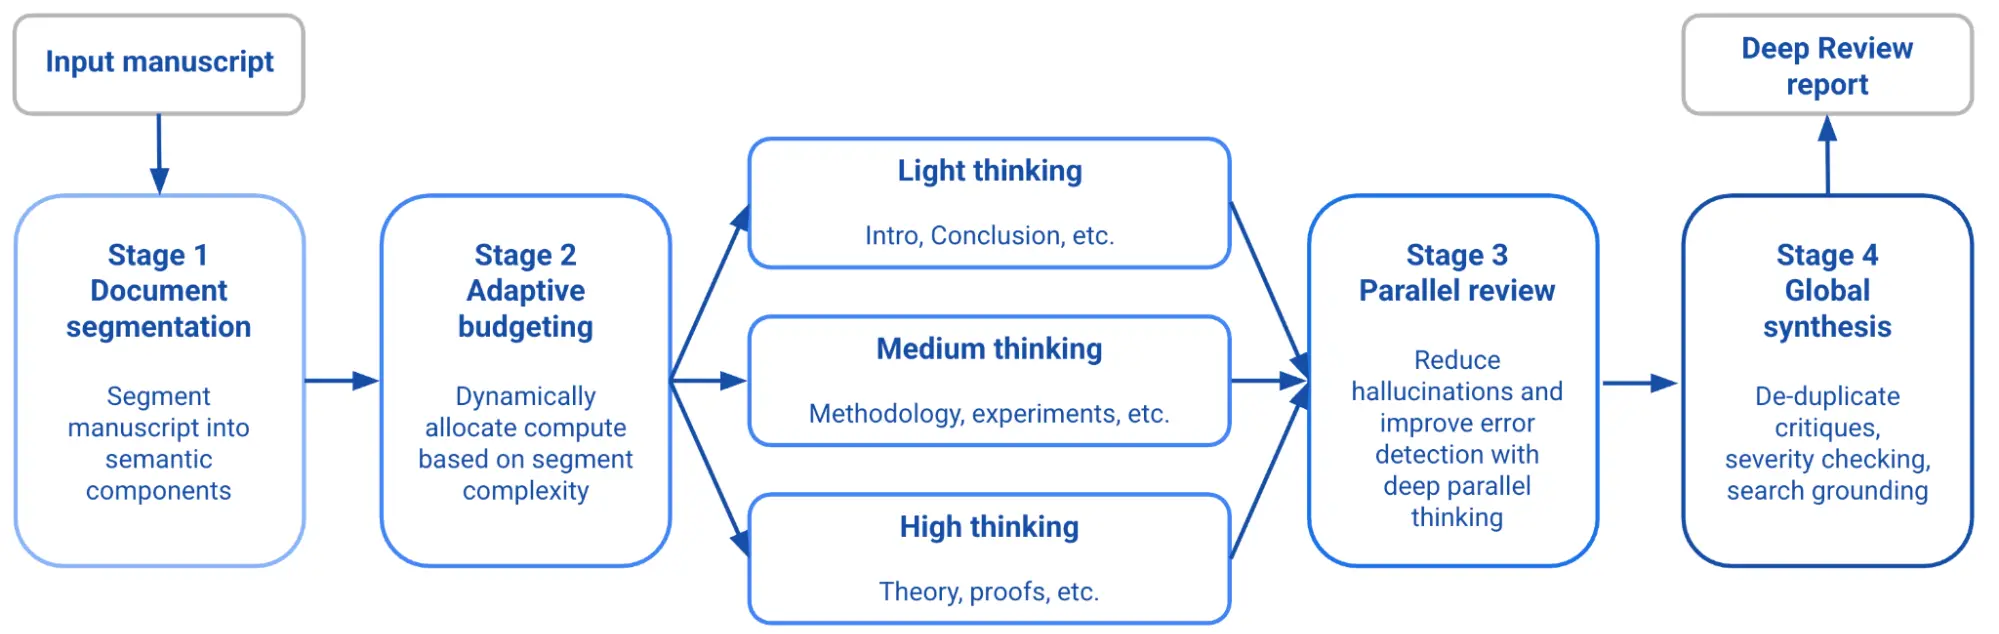
图 3:Deep Review 系统架构——四阶段流水线(来源:Google Research)。
阶段 1:文档分段(Document segmentation)
文档先被分段 agent 自主拆解为逻辑段落(如引言、实验、方法),片段可以重叠,但必须覆盖输入文档的全部内容——这一步确保不丢信息。
阶段 2:自适应预算(Adaptive budgeting)
不是每一节都值得同样的"思考深度"。流水线会检查信息密度,为每个片段动态分配计算预算,并配一套专门的推理扩展(inference scaling)管线。比如论文里密集的数学证明会得到比引言或相关工作更多的算力。
阶段 3:深度并行验证(Deep parallel verification)
专门的推理 agent 并行审查每个片段。每个 agent 都能访问完整文档上下文以跟踪交叉引用,但只专注审查自己负责的片段——这样每个"审查蜂群"的任务可控,并行蜂群之间又能协调一致。
阶段 4:全局综合与 Agent 溯源(Global synthesis and agentic grounding)
最后由综合 agent 汇总各片段报告,做跨章节一致性检查,必要时重跑逻辑检查;再做外部溯源与工具调用,作为防幻觉的最后一道措施。
四、不止论文:四类文档场景
长上下文评审的推理机制是可迁移的:核查数学证明能否成立的机制,同样能用来找出其他文档中的逻辑漏洞与不一致。目前官方列举的用法包括:
| 文档类型 | 它能做什么 |
|---|---|
| 设计文档 | 找出未明说的架构假设、发现边界情况、给出具体改进建议 |
| 演示稿 | 检查幻灯片过渡是否合乎逻辑,要点是否与图表一致 |
| 法律文档 | 检查条款之间的内部一致性,标出歧义术语与下游后果 |
| 财务文档 | 核对数据表的一致性,把论断落到支持证据上 |
注意这句话的分量:"claims must be backed by evidence"——这正是 RAG / 文档智能领域最难的部分:不只是"检索到相关内容",而是把结论与支持它的证据对应起来。
五、访问方式与隐私政策
公开发布后,Deep Review 的使用规则很明确:
- 免费额度:每位用户每周两次文档评审;
- 更高用量:高吞吐工作流可以接入 Gemini API key,通过 Deep Review API 做程序化集成(例如接进 CI 与起草流程);
- 格式:初期支持 PDF 与纯文本输入,多文件输入即将支持;
- 隐私与数据政策:上传到 Deep Review 的文档绝不用于训练、微调或改进 Google 模型;文档会保存一年,唯一目的是在 Deep Review UI 中展示给用户本人。
六、Antigravity 里的 Teamwork 模式
Google 同时推出了 Teamwork Deep Document Review Pattern:一个受 Deep Review 启发的文档评审实现模式,构建在 Antigravity 的 Teamwork 多智能体编排框架之上。它用多智能体层级 + 自我纠错 + 基于片段(segment-based)的评分标准来系统性评估研究论文、手稿草稿与技术提案;Antigravity 用户可以通过 /teamwork-preview 命令调用。
对做 Agent 工程的团队来说,这个模式比工具本身更值得研究:分层评审 + 片段评分 + 自我纠错,正是把"单次 LLM 调用"升级为"可审查流水线"的通用套路。
七、怎么用、怎么看待边界
官方强调的定位值得原文引用:Deep Review 处理"审阅中最耗费认知的部分"(逻辑一致、数学陈述、事实溯源、对比已有工作),而把更高层的判断留给人。这意味着:
- 它适合在起草阶段做迭代改进、在评审阶段做验证辅助——帮你提前发现可避免的缺陷,让有限的评审带宽用在真正需要判断力的地方;
- 它不替代审稿人或技术负责人的最终判断,尤其是贡献大小、创新性、领域取舍这类高层判断;
- 上传前注意数据政策与合规要求,涉密或敏感文档是否适合走外部服务,要按组织规定评估;
- 多文件支持上线后,可以对一整套相关文档、表格与附件做一致性检查,这会进一步扩大适用面。
从更长的视角看,Deep Review 给出的三点对做"文档智能"的团队很有参考价值:先分段再验证(应对长上下文)、按信息密度分配算力(控制成本)、综合阶段做外部溯源(防幻觉)。
参考来源
- Google Research:《Analyzing technical documents with Deep Review》(2026-10-14)https://research.google/blog/analyzing-technical-documents-with-deep-review/
- Deep Review 试用入口:https://research.google/deepreview
- 论文《Towards Automating Scientific Review with Google's Paper Assistant Tool》:https://arxiv.org/abs/2606.28277
- STOC 2026 试点回顾:https://research.google/blog/gemini-provides-automated-feedback-for-theoretical-computer-scientists-at-stoc-2026/
- Antigravity Teamwork 文档:https://antigravity.google/docs/teamwork/
延伸阅读(本站)
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。