Jev 不就是个分类器吗?为什么这么火?
为什么 Jev 会突然引起这么多人的兴趣?
梯形图转SCL | 需求文本转SCL | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI | ElevenLabs | KlingAI | ArtSpace
我第一次看到 Jev 的时候,第一反应其实有点失望。
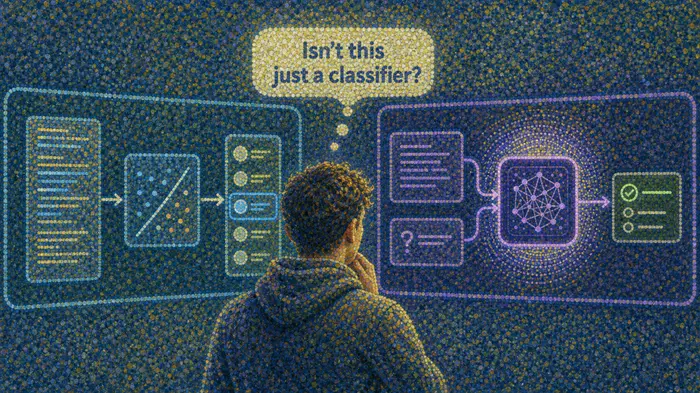
这不就是一个通用文本分类器吗?
给它一段文本,再给它一个问题,让它在几个选项之间做选择。
这件事情听起来并不新。
文本分类早就存在了,BERT 时代就已经是非常成熟的技术。Zero-shot classification 也不是什么新概念。甚至如果只是为了判断:
“这个请求是不是需要调用工具?”
“这封邮件是不是垃圾邮件?”
“这个任务应该交给哪个模型?”
我完全可以想到很多传统机器学习或者小模型的解决方案。
那么问题来了:
为什么 Jev 会突然引起这么多人的兴趣?
我开始觉得,这件事情可能比“一个新的文本分类模型”有意思得多。
于是我花了一些时间去看它到底在做什么,又去看 Reddit 和 X 上大家是怎么讨论它的。
最后我发现,我一开始的问题其实问错了。
1、Jev 到底是什么?
先把最简单的事情说清楚。
Jev 的核心任务可以概括成:
给模型一个状态,再问一个结构化的问题,让模型直接做决定。
比如:
State:
"The user wants to book a flight from Melbourne to Singapore."

Question:
"Which tool should handle this request?"

Choices:
- web_search
- flight_booking
- calculator
- none
它不是让模型写一篇文章,也不是让模型和用户聊天。
它只需要回答:
flight_booking同时,它还可以给出类似 score / probability 这样的信息。
这和传统的分类器有什么区别?
从机器学习任务的角度看,确实没有那么神秘。
本质上仍然可以理解为:
输入
 ↓
语义理解
 ↓
分类 / 判断
 ↓
结构化结果
所以如果有人说:
“这不就是 zero-shot classifier 吗?”
我觉得这个说法并没有错。
问题在于:
如果它只是一个分类器,为什么现在这么多人对它感兴趣?
2. 为什么不用 LLM?
这是我接下来想到的第二个问题。
既然现在已经有这么强大的 LLM,为什么不直接问 GPT、Claude、Gemini 或者其他模型?
例如:
用户请求:
“帮我找一家今晚可以订到的日料店。”

↓

LLM:
“我认为你应该调用 restaurant_search。”
完全可以。
甚至现在的 Agent 本来就是这么做的。
但问题是:
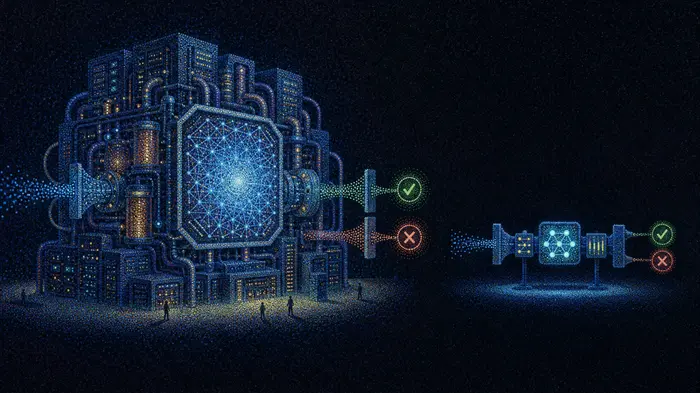
用一个大语言模型解决一个非常小的决定,有时候太重了。
一个 Agent 可能每一步都需要做这种判断:
要不要调用工具?
调用哪个工具?
需要搜索吗?
搜索结果可信吗?
要不要继续?
要不要交给另一个 Agent?
这个结果是否需要验证?
用户的问题属于哪一种?
这个任务是否应该升级给更强的模型?
这些问题本身并不需要写 1000 个 token 的答案。
它们很多其实只有:
Yes / No
A / B / C
0.87
3. Agent 其实充满了“小决定”
这可能是理解 Jev 最关键的一步。
我们通常把 AI Agent 想象成一个会“思考”的东西。
但如果把 Agent 拆开,会发现里面有大量非常小的决策。
例如:
                     Agent
                       │
        ┌──────────────┼──────────────┐
        ↓              ↓              ↓
   是否搜索?       调哪个工具?     是否验证?
        │              │              │
       Yes           Tool A           Yes
这些决策并不需要一个模型写一篇作文。
它们更像软件里的:
if should_search:
    search()

if confidence < threshold:
    verify()

if task_type == "coding":
    coding_agent()
问题在于,传统的 if 需要工程师提前把规则写出来。
而现实世界中的很多条件,并没有办法这么容易地写成规则。
比如:
if user_request_is_complex:什么叫 complex?
你可以写几十条规则。
也可以训练一个分类器。
也可以让 LLM 判断。
而 Jev 提供了另一种可能:
Jev(
    state=user_request,
    question="Is this request complex enough to require a stronger model?"
)
这时候,我开始觉得:
Jev 真正有意思的地方可能不是“分类”,而是把自然语言判断变成了一种可以直接放进程序里的控制结构。
4. 从 Classifier 到 AI-native if
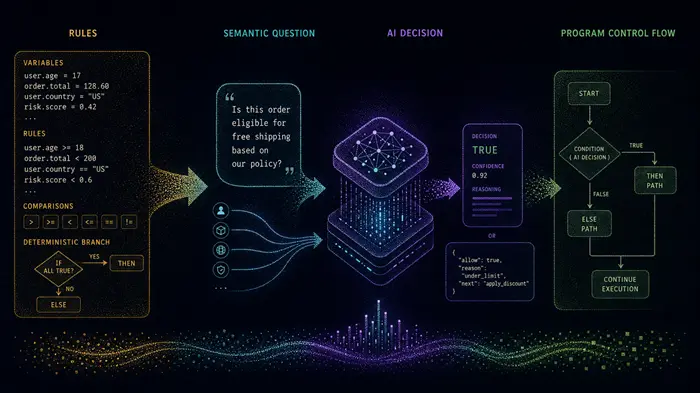
这也是我后来觉得最有意思的地方。
传统软件里的 if 是:
条件
 ↓
Boolean
 ↓
执行
而传统条件通常来自:
变量
比较
规则
阈值
但现实世界里有大量条件是语义性的。
比如:
“这个请求是不是在询问退款?”
“这个用户是不是已经表达了明确购买意愿?”
“这段代码是不是可能存在安全风险?”
“这个回答是否值得再次验证?”
这些东西很难完全用传统规则表达。
LLM 可以理解它们。
但 LLM 又显得太重。
于是 Jev 这样的模型提供了一个很有意思的中间层:
自然语言条件
      ↓
Decision Model
      ↓
Structured Decision
这让我想到一个词:
AI-native if。
不是说 Jev 发明了 if。
而是说:
AI 第一次可以越来越自然地成为程序控制流本身的一部分。
5、真正重要的可能不是答案,而是打分
还有一个细节让我觉得很重要。
如果模型只告诉我:
Yes那么它和普通分类器没有太大的区别。
但如果它同时告诉我:
Yes
Score: 0.94
事情就不一样了。
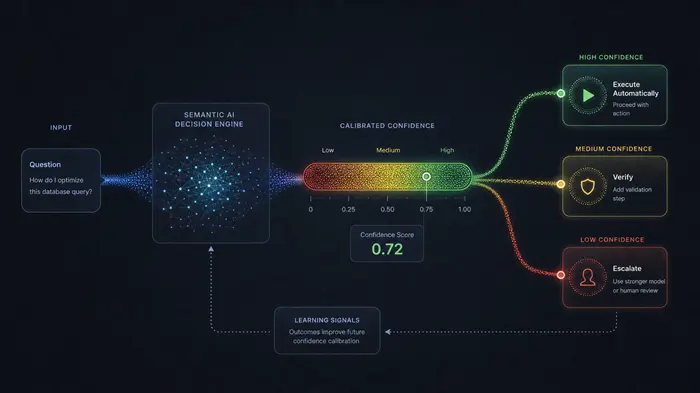
因为程序可以根据这个分数做下一步决定:
Score > 0.95
    ↓
直接执行

0.70 < Score < 0.95
    ↓
执行 + 验证

Score < 0.70
    ↓
升级给更强模型 / 人工
这时候 AI 就不再只是一个:
“回答问题的模型”
而变成:
控制系统中负责判断的一个组件。
这其实是 Agent 非常需要的能力。
因为 Agent 最大的问题之一,就是它经常不知道自己什么时候应该继续,什么时候应该停下来,什么时候应该寻求帮助。
如果一个便宜的模型可以快速告诉它:
应该继续
概率 0.92
或者:
不要继续
概率 0.31
那么这个模型就可以被大量嵌入 Agent 的控制流中。
6、为什么“便宜”突然变得非常重要?
这时候再回头看 Jev 的价格和速度,就更容易理解了。
如果一个决策模型非常贵,那么你不会到处调用它。
但如果一次判断便宜到几乎可以忽略,那么软件的设计方式就会改变。
以前我们可能会想:
“这个地方要不要调用 AI?”
以后可能会变成:
“为什么这里不调用一个 AI 判断?”
这是完全不同的思维方式。
就像数据库查询。
当数据库查询足够便宜以后,我们不会因为每次查询成本太高而尽量少查。
而是会:
需要信息
 ↓
查询数据库
同样,如果 AI decision 足够便宜:
遇到不确定的条件
 ↓
问一下 AI
 ↓
继续执行
AI 就开始从一个昂贵的“功能”变成基础设施。
7、这时候我又想到了一个很经典的经济学现象
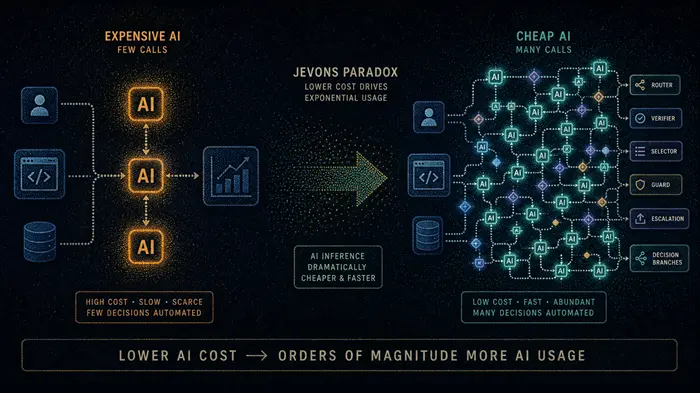
杰文斯悖论。
一个资源变得更便宜以后,人们并不一定只是少花钱。
相反,因为成本下降,使用量可能会大幅增加。
AI 可能也是一样。
如果调用一次大模型需要:
成本高
延迟高
上下文长
那么工程师会非常谨慎。
但如果一个专门做判断的小模型:
成本低
延迟低
输入简单
输出结构化
那么我们就可能开始疯狂增加 AI 决策点。
原来一个 Agent 里面可能只有几个 AI 调用。
以后可能变成:
                Agent
                  │
       ┌──────────┼──────────┐
       ↓          ↓          ↓
    Router     Verifier   Escalator
       │          │          │
       ↓          ↓          ↓
      AI         AI         AI
       │          │          │
       └──────────┼──────────┘
                  ↓
               LLM
AI 的使用方式,可能从“调用一次 AI”变成“到处嵌入 AI”。
8、但 Reddit 上的质疑也很有意思
我特意去看了一些 Reddit 上的讨论。
有一种观点非常直接:
“Isn't this just BERT?”
我觉得这个问题非常重要。
因为它提醒我们:
不要因为一个产品包装得很新,就把一个成熟的技术说成革命性的技术。
传统分类模型在很多固定场景下其实非常强。
如果你的任务是:
输入
 ↓
固定分类
 ↓
输出
而且你拥有大量高质量标注数据,那么训练一个专门的分类器完全可能更加便宜、稳定。
所以 Jev 并不是要替代所有的分类器。
它真正有吸引力的地方,反而可能是:
问题不断变化,但又需要大量进行语义判断的场景。
传统分类器往往需要:
定义任务
 ↓
准备数据
 ↓
标注
 ↓
训练
 ↓
部署
而 zero-shot 的思路是:
定义问题
 ↓
直接判断
如果今天问:
“这是不是垃圾邮件?”明天换成:
“这是不是紧急邮件?”后天再换成:
“这是不是值得人工介入的邮件?”你不一定希望每次都重新训练一个模型。
9、所以它真正解决的可能是“决策成本”
到这里,我对 Jev 的理解开始发生了变化。
一开始我的问题是:
“它是不是一个文本分类器?”
后来变成:
“为什么我要用它,而不是 LLM?”
再后来变成:
“它是不是把语义判断变成了一种基础设施?”
这三个问题其实对应三个不同层次:
模型层
↓
它是什么?

产品层
↓
为什么使用它?

系统层
↓
它可以改变什么?
在模型层,它确实很像 zero-shot classifier。
在产品层,它强调:
低成本
低延迟
结构化输出
概率 / score
无需针对每个问题重新训练
而到了系统层,它开始变得有意思:
它可能让“把 AI 放进控制流”这件事情变得足够便宜。
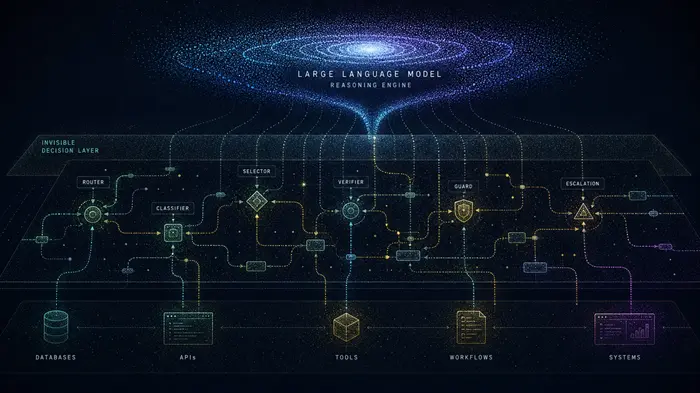
10、LLM 是推理层,Jev 更像决策层
我觉得这是理解两者关系最简单的方式。
LLM 擅长:
理解
推理
生成
规划
解释
而 Jev 这样的模型更适合:
判断
分类
路由
筛选
验证
升级
所以它们并不一定是竞争关系。
反而可以是:
             Agent
               │
       ┌───────┴───────┐
       ↓               ↓
 Decision Layer    Reasoning Layer
       │               │
      Jev              LLM
       │               │
       └───────┬───────┘
               ↓
             Tools
甚至可以想象未来一个 Agent 的工作方式:
用户请求
   ↓
Decision Model
   ↓
是否需要推理?
   ├── No → 直接执行
   │
   └── Yes
       ↓
      LLM
       ↓
   得到结果
       ↓
Decision Model
       ↓
是否可信?
   ├── Yes → 返回
   └── No  → 再推理 / 换模型 / 人工
这时候,Jev 的价值就不是“替代 LLM”。
而是:
让 LLM 不必处理所有事情。
11. 这可能也是为什么它特别适合 Agent
传统软件的控制流是:
代码
 ↓
规则
 ↓
确定性执行
Agent 的控制流则经常变成:
自然语言
 ↓
LLM
 ↓
自然语言
 ↓
代码
中间有大量不确定性。
如果我们能够增加一个廉价的 Decision Layer:
自然语言
 ↓
Decision
 ↓
确定下一步
 ↓
LLM / Tool / Agent
整个系统就会更加模块化。
所以我现在越来越觉得:
Jev 最值得关注的地方,并不是它是不是一个更好的文本分类器,而是它有没有可能成为 Agent 时代的一种新的基础原语。
12、但 Jev 真的有护城河吗?
这里我又开始泼一点冷水。
如果 Jev 的核心只是:
Zero-shot classification
+
结构化输出
+
概率
+
低延迟
+
低价格
那么从长期来看,这些能力本身未必难以被复制。
大型模型公司当然可以做。
开源模型也可以做。
甚至一个足够好的小模型,加上一套不错的校准,也可能做出类似的东西。
所以真正的竞争可能不在:
“有没有一个模型可以做分类?”
而在:
模型能力
+
Calibration
+
数据
+
Benchmark
+
Inference infrastructure
+
API
+
Developer experience
+
生态
也就是说:
模型可能只是入口,真正的产品壁垒可能来自整个 decision infrastructure。
13、我开始理解为什么有人会兴奋,也有人会不屑
现在再回头看 X 和 Reddit 上两种完全不同的声音,我觉得都可以理解。
有人看到的是:
“终于有一个便宜、快速、专门做判断的 AI 了。”
他们想到的是:
Router
Verifier
Guard
Classifier
Escalator
Tool Selector
另一些人看到的是:
“这不就是把文本分类重新包装了一遍吗?”
他们关注的是:
模型架构到底新不新?而我觉得这两种观点其实没有冲突。
技术创新程度和产品价值并不是同一个维度。
一个东西在算法上未必革命性,但仍然可能因为产品形态、成本结构和使用方式发生变化,而产生很大的影响。
14、然后我意识到,还有一个非常现实的原因
大家已经有一点 LLM 疲劳了。
过去几年,我们看到了太多类似的 AI 产品:
输入框
 ↓
Chat
 ↓
LLM
 ↓
一大段回答
ChatGPT 是这样。
各种 Copilot 是这样。
各种 Agent 也经常还是这样。
模型越来越强。
上下文越来越长。
Agent 越来越复杂。
但从产品形态上看,它们却越来越相似。
尤其对开发者来说,已经出现了一种非常明显的“AI 基础设施疲劳”:
Prompt
System Prompt
Context
Tool Calling
Function Calling
RAG
MCP
Agent
Memory
Workflow
...
每一个概念都很重要。
但把这些东西组合起来以后,AI 产品也越来越复杂。
这时候,一个 AI 产品突然告诉你:
“别跟我聊天。”
“直接给我一个问题,我帮你做决定。”
这种反差本身,就很容易让人停下来看看。
15、“容易上手”本身就是一种产品价值
我觉得这是 Jev 被讨论时很容易被忽略的一点。
LLM 非常强,但使用 LLM 往往意味着你需要理解一整套概念。
而一个 决策 API 可以非常简单:
State
+
Question
+
Choices
=
Decision这是一种非常强的认知压缩。
它没有要求开发者理解整个模型。
甚至不需要理解模型是怎么训练出来的。
你只需要理解:
我有什么状态?
我想让 AI 帮我判断什么?
然后就可以把它接进代码。
这其实和 Unix 工具、数据库、HTTP API 的设计哲学有一点相似:
复杂性藏在内部,接口保持简单。
而 AI 过去几年有一个有意思的趋势:
模型能力越来越强,但使用模型的方法也越来越复杂。
Jev 这样的产品则走了另一个方向:
把一个强大的模型压缩成一个简单的原语。
这可能正是它让开发者感觉“不一样”的原因之一。
16、最后,我觉得真正值得关注的,还有一点:差异
到了这里,我反而不太想再纠结:
“Jev 到底是不是通用文本分类器?”
如果从技术定义来说,是的。
但这个答案已经不足以解释它为什么受到关注。
我现在更愿意从另一个角度看它。
我们已经进入了一个非常拥挤的 AI 市场。
大家都有 LLM。
大家都在做 Agent。
大家都在做 RAG。
大家都在做 MCP。
大家都在做 Copilot。
于是产品开发很容易陷入一个循环:
别人有什么?
↓
我也做一个
↓
我做得更快一点
↓
更便宜一点
↓
功能再多一点
这当然可以产生竞争力。
但它很容易让产品越来越相似。
而 Jev 给我的另一个启发是:
差异不一定意味着你必须发明一个全新的技术。
文本分类不是新技术。
概率预测不是新技术。
API 也不是新技术。
但是把它们重新组合起来:
自然语言状态
      ↓
自然语言问题
      ↓
结构化决策
      ↓
Score / Confidence
然后把它做成一个开发者可以随手调用的基础能力,
产品形态就不一样了。
这件事情让我重新想到产品开发中一个非常简单、但经常被忽略的问题:
我们是不是花了太多时间研究“怎么把别人已经做过的东西做得更好”,却没有花足够多的时间思考“有没有另一种做法”?
更快一点。
更便宜一点。
更多几个功能。
这些都是在同一条曲线上优化。
但真正容易让人记住的产品,有时候来自:
换一条曲线。
17、所以,Jev 到底是什么?
现在如果再让我回答最开始的问题:
“Jev,不就是通用文本分类器吗?”
我的答案会变得简单很多:
是。
但这恰恰不是最重要的问题。
它在技术上可以被理解为一种 zero-shot decision / classification model。
它的产品价值,则来自另外几件事情的组合:
强大的语义理解
        +
低延迟
        +
低成本
        +
结构化决策
        +
概率 / Confidence
        +
无需针对每个问题重新训练
        +
极其简单的 API
而它真正值得关注的地方,是这些特性组合起来以后,可能改变 AI 的使用方式。
过去我们想:
“什么时候应该调用 AI?”
以后也许会变成:
“为什么这里不放一个 AI 决策?”
过去 AI 是一个需要主动调用的“大功能”。
未来 AI 可能只是程序里的一个小节点:
if AI_decides("should_retry"):
    retry()

if AI_decides("needs_verification"):
    verify()

if AI_decides("which_model"):
    route()

if AI_decides("is_safe"):
    continue()
这时候,AI 才真正开始进入软件的控制流。
而这也是我觉得 Jev 最有意思的地方。
LLM 把 AI 变成了一个会思考、会表达的“人”。
而 Jev 这样的模型,则在尝试把 AI 变成一种可以嵌入软件的决定。
也许未来 AI 的形态,并不只有:
Chatbot
Agent
Copilot
还会有大量我们甚至感觉不到的:
Decision
Router
Verifier
Judge
Guard
Selector
它们安静地存在于软件的每一个角落。
所以最后,我真正留下的问题反而不是:
“Jev 是不是一个文本分类器?”
而是:
如果 AI 便宜到足以进入每一个 if,软件会变成什么样?以及另一个对产品开发者更现实的问题:
当所有人都在做类似的 AI 产品时,我们有没有勇气停下来,寻找一个真正不同的方向?
也许下一代产品的机会,并不总是来自:
“把 AI 做得更强。”
有时候,它来自:
“把 AI 做成完全不同的东西。”
汇智网原创,转载请标明出处