Jev 在智能体中的10大应用
快速模型反应,慢速模型规划:在速度、成本和可靠性方面,类型化决策层优于完整的 LLM 调用。
梯形图转SCL | 需求文本转SCL | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI | ElevenLabs | KlingAI | ArtSpace
Jev 是一个 System One 模型:你发送应用状态和类型化问题,它返回类型化的概率决策。
它不生成文本,也不需要 JSON 提示词后跟解析和验证。
你的软件首先定义答案空间。
TypeSafe 目前报告响应时间约为 70-500 毫秒,在可比较的 System One 形状查询上实现 40-200 倍加速,定价为 每百万输入 token 0.042 美元,输出实际上免费。
其自身的四工作流评估产生了更激进的数字:比参考 LLM 设置 快 193.6 倍,便宜 444.6 倍。
要点更简单:
将 LLM 保留用于生成、规划和复杂推理。将重复的、封闭集判断转移到更便宜的决策层。
这将智能体从 全 LLM 架构 转变为混合系统:快速模型反应,慢速模型规划。
本文对十个能产生最大理论收益的场景进行排名。
0、首先,Jev 实际返回什么
Jev 有三个原语:
Choice:从固定集合中选择一个选项,返回选中的选项、概率和置信度。Score:将某物放在有序评分标准上,返回分数、概率和置信度。Noul:估计陈述是否为真,返回 0 到 1 的概率。
你可以在一次调用中对同一状态提出多个问题。
TypeSafe 表示每个问题是独立评估的,因此添加更多问题几乎不会改变响应时间。
这是一个最小的 Python 设置。
首先,安装 SDK 并设置 API 密钥:
pip install typesafe-sdk
export TYPESAFE_API_KEY=...
然后在一次请求中对同一状态提出多个类型化问题:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state="部署失败两次,客户看到 500 错误。",
    questions={
        "route": Choice(
            instructions="哪个团队应该处理这个问题?",
            criteria={
                "platform": "基础设施、部署、运行时故障",
                "product": "应用行为和产品缺陷",
                "support": "客户沟通和后续跟进",
            },
        ),
        "severity": Score(
            instructions="事件严重程度如何?",
            criteria=["低", "中", "高"],
        ),
        "urgent": Noul(
            instructions="这需要立即关注",
        ),
    },
)

print(response.answers["route"].choice)
print(response.answers["route"].confidence)
print(response.answers["urgent"].noul)
重要部分是 你的代码拥有分支逻辑。
1、实时循环:游戏、机器人、交互控制
这是最大的理论收益,因为在这里前沿 LLM 太慢而无法参与。
TypeSafe 的 Doom 演示以约 每秒 10 个决策 运行,据报道成本约 每小时 7 美元。
社区示例在 Minecraft 中使用相同的拆分:Jev 处理即时反应,而前沿模型提前规划。
相同的架构可重用于任何世界变化速度快于 LLM 完成响应的地方:
观察状态 -> 快速决策 -> 动作 -> 再次观察
                     |
                     +-> 仅在需要时调用慢速规划器
收益是一个否则会完全错过其时间预算的控制循环。
对于机器人、模拟、多人智能体、本地 UI 控制和其他响应式系统,这是能力的根本性改变。
2、浏览器和计算机使用操作选择
浏览器智能体烧钱是因为每一步都要求模型决定下一步做什么。
Browser Use 的 jev-ultrafast 仓库展示了更好的模式。
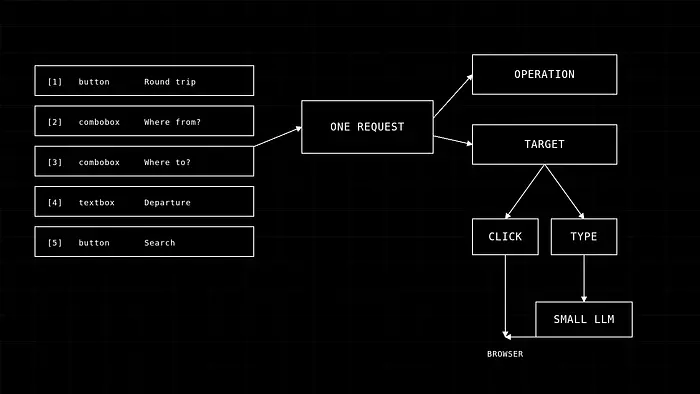
每个页面观察变成一个索引化的操作空间。
Jev 选择一个操作和兼容的目标,只有当选定操作需要生成文本时,小型文本模型才会启动。
据报道,Google Flights 演示在约 7.1 秒 内完成苏黎世到伦敦的搜索,包含真实加载等待。
DOM -> 索引化控件 -> Jev(操作 + 目标) -> 浏览器动作
                                      |
                                      +-> 仅在需要 TYPE_TEXT 时调用小型 LLM
这是要复制的模式:在代码中生成候选,让 Jev 选择,仅在不可约的生成部分使用生成。
从仓库快速开始:
git clone https://github.com/browser-use/jev-ultrafast.git
cd jev-ultrafast
uv sync
cp .env.example .env
# 添加 TYPESAFE_API_KEY 和 TEXT_MODEL_API_KEY
uv run jev
或直接使用库:
from jev_ultrafast import Agent

with Agent(
    "https://www.google.com/travel/flights?hl=en",
    "查找 2026 年 9 月 20 日从苏黎世到伦敦的单程航班,"
    "一名成人经济舱。当匹配的航班选项可见时停止。",
) as agent:
    for state in agent.run():
        print(state["elapsed_ms"], state["status"])
3、工具风险门控
每个严肃的自主智能体最终都需要在工具执行前进行策略检查点:
- 此 shell 命令是否具有破坏性?
- 此请求是否泄露数据?
- 在自动模式下是否允许此工具调用?
- 是否应该让人类确认此操作?
LangChain 已经以 AutoModeMiddleware 的形式暴露了这种模式:
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import AutoModeMiddleware

guardrail = AutoModeMiddleware(tools=["bash"])
agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])
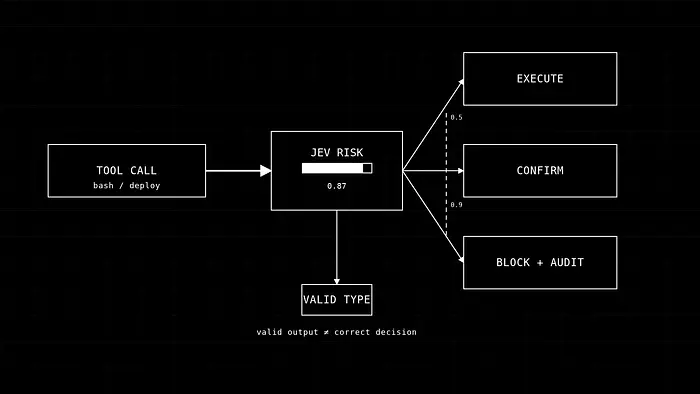
理论优势是可靠性和延迟:风险检查应该足够便宜,可以在每次工具调用前运行。
一个重要的警告:"类型化输出不能幻觉" 并不意味着 "决策不可能错误"。
Jev 可以保证答案是有效选项之一,但不能保证它选择的有效选项是正确的。
因此生产模式是置信度门控执行,而非盲目信任。
4、模型路由
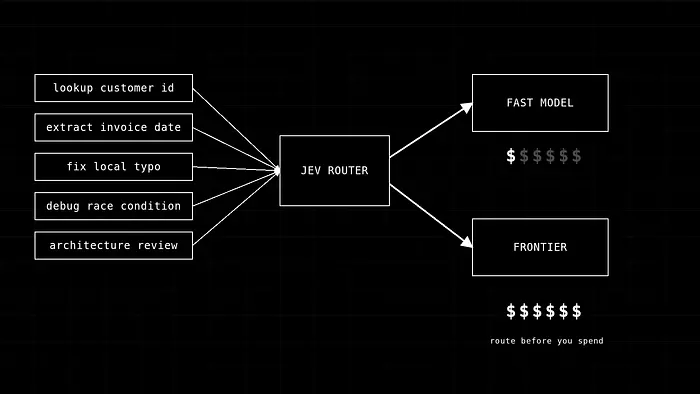
智能体在不需要前沿推理的工作上浪费前沿模型 token。
将 Jev 放在你的模型集群前面,将路由变成显式中间件:
from langchain_typesafe.experimental.middleware import (
    ModelChoice,
    ModelRouterMiddleware,
)

router = ModelRouterMiddleware(
    choices={
        "fast": ModelChoice(
            model="openai:luna",
            criteria="直接查找、提取和本地化更改。",
        ),
        "powerful": ModelChoice(
            model="openai:sol",
            criteria="架构和高风险决策。",
        ),
    },
    instructions="选择能完成任务的最便宜模型。",
)
节省在长时间会话中累积:一个几乎零成本的路由决策可以防止更大、更昂贵的调用。
这也是最容易证明的 Jev 集成之一,因为它位于清晰的架构边界:在模型调用之前。
5、目标和卡住检查
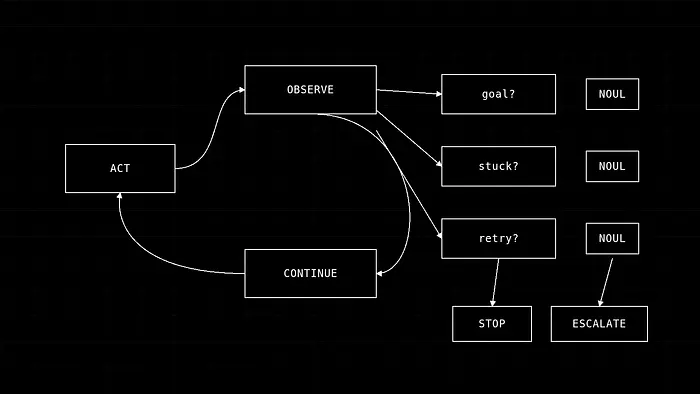
智能体循环不断询问相同控制问题的变体:
- 我们是否完成了目标?
- 我们是否在取得进展?
- 我们应该重试吗?
- 我们卡住了吗?
- 我们应该停下来询问用户吗?
这些是教科书式的 Noul 或小型 Choice 决策。
然而今天许多框架使用完整的 LLM 调用来回答它们,这意味着循环控制机制可能比它监督的工具执行更慢。
亚秒级决策模型使循环控制足够便宜以持续运行。
这提高了可靠性,因为你可以检查每一步的进展,而不仅仅是在失败变得明显之后。
6、上下文压缩
大多数编码智能体通过让 LLM 总结旧轮次来压缩上下文。
这在设计上是有损的。
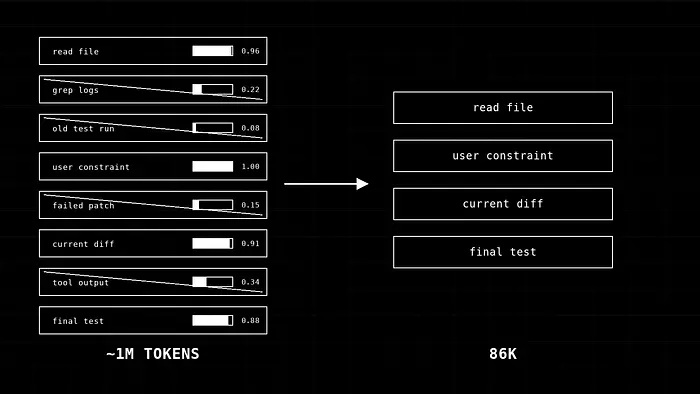
fast-jev-compaction 项目采用了不同的方法:它对旧的工具调用和工具结果进行评分,保留仍然重要的内容,截断一些结果,丢弃过时的材料。
用户和助手文本保持原样。
安装并设置密钥:
npm install fast-jev-compaction
export TYPESAFE_API_KEY=...
然后压缩转录,并在缩减太小不值得时回退:
import {
  compactMessages,
  reductionRatio,
  type Message,
} from 'fast-jev-compaction';

const result = await compactMessages(transcript, {
  preserveRecentMessages: 4,
});

if (reductionRatio(result) < 0.25) {
  // 保留原始转录或回退到摘要。
}
引起大家注意的社区结果:近 100 万 token 在约一秒内减少到 86K。
更深层的想法比一个插件更大:删除可以比重写更好地保留真相。
但压缩也是置信度最重要的地方。
现在无关 与 以后可重现 不同,因此生产系统应在允许基于相关性删除之前固定不可重现的输出、最近的约束和未解决的工具状态。
7、技能和工具选择
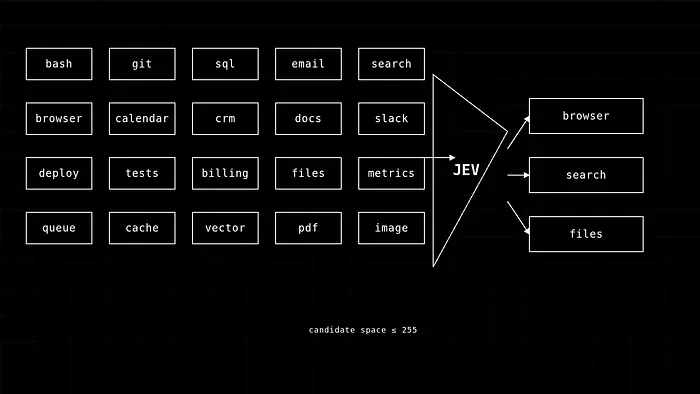
智能体提示词不断增长,因为开发者将每个工具描述和每个技能都塞入模型的上下文。
这是本末倒置。
更好的流程如下:
请求 -> 候选工具/技能 -> Jev Choice -> 仅激活获胜者(s)
部分收益是成本,但更有趣的收益是提示词质量:生成模型看到更小、更相关的操作面,而不是数十个无关的工具规范。
这对平台智能体特别有吸引力,因为工具目录动态变化,可能包含数百种可能的能力。
Jev 支持最多 255 个选项 的 Choice,这足以满足许多真实工具注册表,无需先让 LLM 筛选。
8、输出和跟踪护栏
护栏通常实现为另一个 LLM 提示词,在昂贵的 LLM 已经完成后运行。
这可能太慢而无法到处应用。
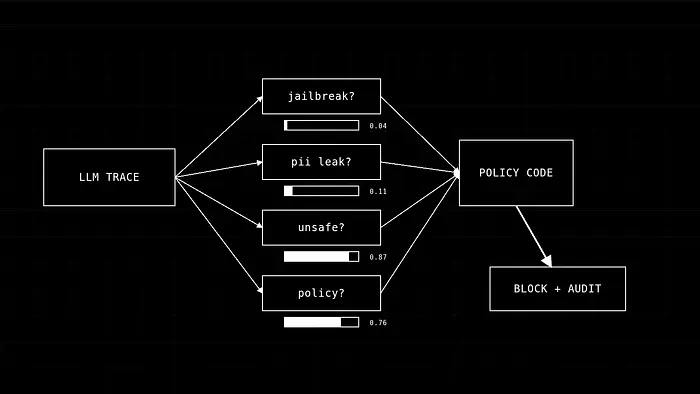
Jev 使"验证一切"在经济上可行:对提示词、跟踪、工具输出或最终答案进行策略风险、越狱签名或领域特定约束评分。
最强的架构是几个窄问题,其输出在代码中组合。
例如:
越狱? 0.04
PII 泄露? 0.11
不安全? 0.87
置信度 0.93

=> 阻止 + 审计
这比巨大的自然语言审核提示词更容易测试,因为每个决策都有定义的输出和阈值。
9、工单和邮件分类
高容量路由是每项成本微小节省转化为真实基础设施节省的地方。
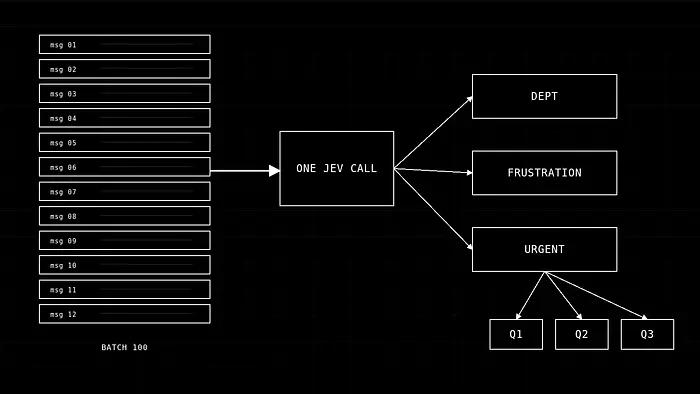
TypeSafe 自身的快速入门本质上是支持工单分类管道:选择部门、评分挫败感、估计紧急程度,所有在一次请求中完成。
社区构建者已将相同模式推送到邮件批处理。
报道的示例引人注目不是因为邮件新颖,而是因为单位经济性。
当工作流每项需要三个或十个判断时,并行类型化问题比原始单次调用速度更重要。
正确的实现是批处理优先:共享一个状态,询问你可能需要的每个独立问题,让下游代码决定哪些输出重要。
10、RAG 重排序
检索给你候选,但不保证这些候选属于答案上下文。
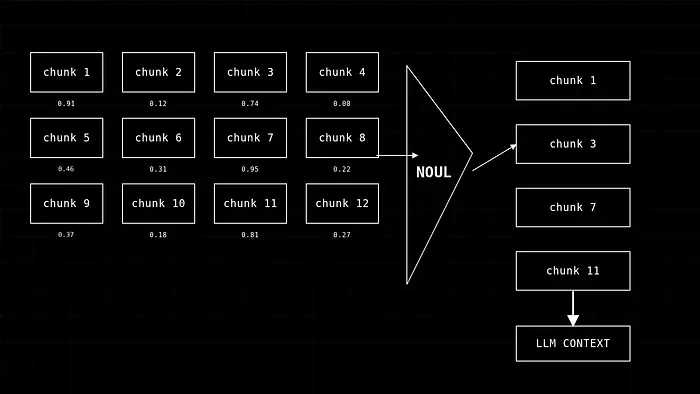
明显的修复是对每个块运行相关性判断,但用前沿 LLM 对每个块这样做太昂贵,许多团队直接接受有噪声的检索。
Jev 改变了这个数学:
from typesafe_sdk import Noul, TypeSafeClient

client = TypeSafeClient()
kept = []

for chunk in retrieved_chunks:
    verdict = client.system_one(
        state={"question": user_question, "chunk": chunk.text},
        questions={
            "relevant": Noul(
                instructions="该块包含回答问题所需的信息"
            )
        },
    )

    if verdict.answers["relevant"].noul > 0.5:
        kept.append(chunk)
这给你一个简单的两阶段 RAG 管道:
广泛检索 -> 廉价判断 -> 从幸存者生成
它排名第十只是因为重排序已经可以用嵌入、交叉编码器或专用重排序器解决。当相关性依赖于比向量相似性更丰富的应用状态时,Jev 的优势最强。
11、我会使用的架构
不要用 Jev 替换你的智能体模型。
按计算形状拆分系统。
当输出空间是开放的时使用 LLM:规划、合成、代码、解释、新工具参数和复杂多步推理。
当输出空间可以在推理前定义时使用 Jev:路由、门控、评分、选择、停止、重试、保留、删除、升级。
然后将置信度放在控制路径中:
if decision.confidence < 0.5:
    询问人类或回退()
elif high_risk_action and decision.confidence < 0.9:
    要求确认()
else:
    执行()
确切的阈值应来自你自己的评估集,而不是来自博客文章。
这是迄今为止几乎所有强大 Jev 示例背后的核心工程模式:
AI 生成。代码约束。Jev 在已知选项间决策。
你的应用变得越智能体化,它累积的微小判断就越多。
如果每个都唤醒一个前沿 LLM,成本和延迟随每次循环迭代复合。
Jev 的真正承诺是你负担得起做出 你之前完全避免做出的数百个决策。
这就是智能体架构开始改变的地方。
原文链接:Top 10 JEV Use Cases in Agentic Apps. Ranked by Theoretical Gain Over LLMs.
汇智网翻译整理,转载请标明出处