暂停时钟 70%,真实时钟 14%:agent 输在时间,不是智商
同一个模型、同一批任务,环境一暂停就能到 70%,环境一走就只剩 14%。这 56 个百分点的缺口不是知识,是预算与时机。
同一个模型,同一批任务,只换一条规则:声称时间怎么流。
- 环境在它思考时暂停:Claude Opus 5 完成 70.0% 的任务。
- 环境按真实推理延迟推进:在同样的"高推理强度"下,只剩 14.0%。
Gemini 3.8 Flash 是同一组数:70.0% → 24.0%。
这不是"模型变笨了"。任务、提示、观测接口、动作空间全都没变,变的是它想多久,世界就走多远。
Realtime-Bench 干的就是这件事。它由 UT Austin、俄亥俄州立、UIUC、NVIDIA、西北大学和 Steadyworks 的研究者搭建(arXiv 2026-10-15 首版,2026-10-22 的 v3),50 个任务、12 个前沿模型、三种时钟制度。结论一句话:今天的 agent 在"能看懂"上已经够用,在"什么时候停下来动手"上还差得远。
本文完整编译论文与 Jack Clark 在 Import AI 479(2026-11-02)里的判读,含三种时钟、全部关键数字、三类失败模式,最后是给做 agent 的人的检查清单。
一、买票为什么比写代码难
论文的开场例子选得很准:抢一张热门演出的票。
"检测到余票"只是第一步。你还得持续观察界面(余票在变)、判断刚才看到的座位是否还成立、在支付窗口关闭之前决定"再等等"还是"现在就买"。动作选对、时机选错,等于没做。
现有评测覆盖不了这个缝隙。静态环境的 benchmark 测的是"给一张截图,能不能点对";流式模型的评测多集中在对话质量、流式感知、打断处理上。而"延迟本身会改变结果"的交互任务,几乎没有覆盖。
这也是 Realtime-Bench 的三个设计原则:
- 真实:网页任务是仿真实站点(比如电商),游戏任务改编自流行开源游戏;
- 环境自行演化:状态随时间变化,与模型的动作无关(座位在变、障碍在动);
- 时间约束:成功同时取决于做什么和什么时候做——倒计时、有限的窗口、转瞬即逝的机会。
二、三种时钟:这台机器怎么定义"来不及"
要量化"时间成本",得先能把它拆开。论文定义了三个协议:
| 协议 | 动作提交时刻 | 它测什么 |
|---|---|---|
| Wall Clock(真实时钟) | Δt = 实际推理 + 服务延迟 | 部署现状 |
| Paused Clock(暂停时钟) | Δt = 0 | 能力上限的参照(假设思考不花时间) |
| Token Clock(词元时钟,本文提出) | Δt = n / κ,n 为内部思考 token + 动作输出 token | 去掉服务器速度差异后,思考本身的代价 |
κ = B·f:f 是观测帧率(实验固定 1 FPS),B 是每个模拟秒"允许"的 token 数(主实验取 64)。换算下来 κ = 64 token/模拟秒,大致对齐当前自回归解码的实测速度;论文的预实验也确认,这个额度足够在一个观测间隔里给出一个完整动作加一两句理由——留了"短暂思考"的空间,但思考太久就要付时间账。
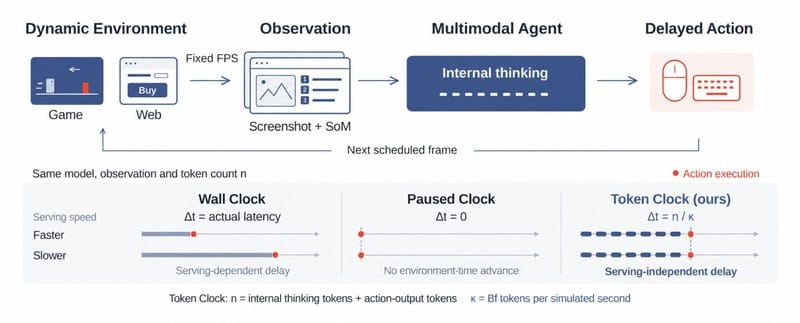
三种时钟。同样是"想 n 个 token",真实时钟按服务器速度算时间,暂停时钟不算,词元时钟按 n/κ 算——把服务速度与思考成本分开。
观测与动作接口的统一化做了一件事:截图 + Set-of-Marks(只读的可交互元素标注),让"找按钮"不再成为瓶颈,测的是决策与时机,不是 GUI 定位。每个决策步输出标准 GUI 动作(click / type / scroll / wait)。上下文管理沿用 Qwen-CUA 的按块丢弃历史,保证前缀稳定、能复用 KV 缓存——避免 harness 的开销污染实时性测量。
有一处细节值得抄进自己的评测:如果模型在时钟推进到动作时刻之前还没产出有效动作,harness 会在同一时钟协议下补一个 wait。也就是说,"想太久"不会被记成"没动作",而是被记成"你在该动的时候没动"。
三、50 个任务,12 个模型
50 个任务 = 30 个网页任务(旅行、电商、服务、安全四个类别)+ 20 个游戏任务(街机、解谜、策略、模拟)。每个任务有自己的成功判据,比如"在倒计时结束前买到票"。
12 个模型分三档,这个分类本身就是论文的一个贡献:
- 标准异步模型:GPT-6-Astra、GPT-5.6 Sol、Claude Fable 5.1、Claude Opus 5、Gemini 3.8 Flash、DeepSeek V4.1 Flash、Kimi-K3;
- 实时流式模型(为低延迟交互优化):GPT-Realtime-2、Gemini 3.1 Flash Live、Gemini 3.8 Live;
- 决策模型(直接返回结构化决策,不生成自由文本):OpenAI Decisions、Jev 1.13。
实时时钟下全员跑一遍;再挑六个有代表性的模型(GPT-Realtime-2、Gemini 3.1 Flash Live、GPT-5.6 Sol、Claude Opus 5、Gemini 3.8 Flash、Kimi-K3),在三种时钟 × 两档推理强度(低 / 高)共六种设置下对比。决策模型被排除在这部分之外——它们不报输出 token 数,没法算词元时钟。
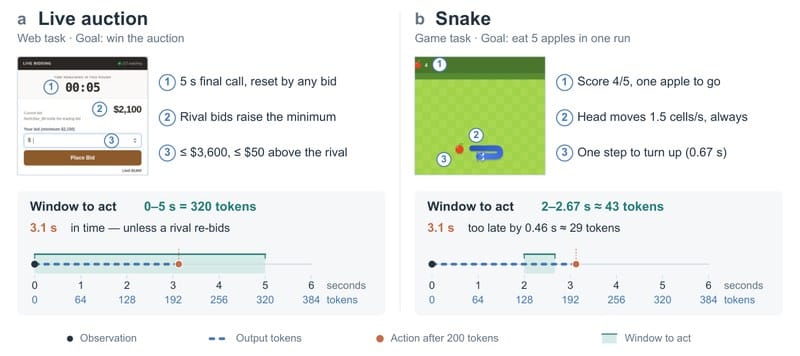
两个代表性任务。左边拍卖:5 秒落槌窗口 = 320 token,一个 200 token 的回答落在 3.1 秒,来得及。右边贪吃蛇:转向窗口只有 0.67 秒 ≈ 43 token,同样的回答晚 0.46 秒(约 29 token),直接撞墙。
四、真实时钟:最好的 44%,最稳的 36%
先说两个容易混淆的指标:
- 成功率(pass rate):完成的任务占比;
- Pass^3:三次独立尝试全都成功的任务占比。
为什么两个都要看?因为"有一次做对"和"每次都能做对"是两种东西。抢票这种事只有一次机会。
真实时钟下:
- 最好的成功率 44.0%;
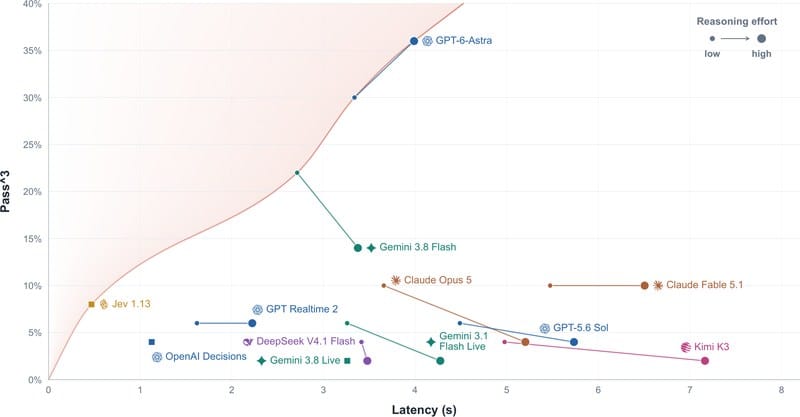
- 最好的 Pass^3 只有 36%(GPT-6 Astra,高推理档);
- 最好的 pass@1 低于 42.67%。
也就是说,最强的模型也做不到"稳定完成"。多数模型的单次延迟超过一秒,而任务的窗口常常只有几秒。
这里有一组特别有说服力的对照:Jev-1.13.0 做到了亚秒级延迟,但它的 Pass^3 只有 8%。
延迟低,不等于会做事。
这句话是全文对"上一个实时模型就能进生产"最直接的否定。实时能力需要两件事同时成立:响应够快,且决策够对。而现在的模型是:快的不会想,会想的来不及。
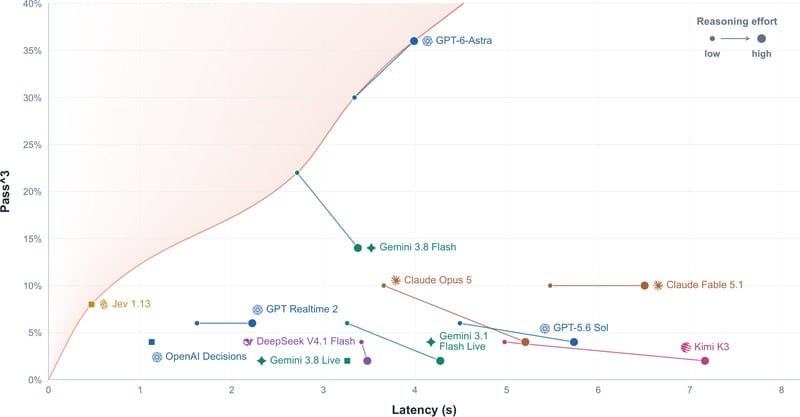
延迟 vs Pass^3。箭头是"低推理档 → 高推理档"。GPT-6-Astra 独占右上,但它的两个档次都在 35% 以下;多数模型抬高推理强度只换来更长的延迟,甚至更低的 Pass^3(GPT-5.6 Sol、Gemini 3.8 Flash、Claude Opus 5 都是往右下方走)。
五、把时钟拆开:时间到底吃掉了多少
同一批模型、同样的任务,在暂停时钟下:
| 模型(高推理档) | 暂停时钟(PH) | 真实时钟(WH) | 词元时钟(TH) |
|---|---|---|---|
| Claude Opus 5 | 70.0% | 14.0% | 30.0% |
| Gemini 3.8 Flash | 70.0% | 24.0% | 34.0% |
三段落差,两个成因:
- PH → WH(70 → 14 / 24):环境在推理时继续走。这段落差包含服务器速度。
- PH → TH(70 → 30 / 34):即使把服务延迟彻底拿掉、只按生成的 token 计费,成功率依然腰斩。说明"想得久"本身就致命——不是服务器慢,是思考贵。
论文的结论很干脆:在会演化的环境里,时间成本本身就在限制成功率。
六、推理强度是一场交易,而且常常亏
这是全文最反直觉、也最该贴到每个 agent 配置面板上的一条。
在暂停时钟里,提高推理强度对六个模型全都是正收益:
- GPT-5.6 Sol:42.0%(低)→ 58.0%(高);
- Claude Opus 5:62.0% → 70.0%。
但在词元时钟下,同一个模型会反转:
- Claude Opus 5:44.0%(TL)→ 30.0%(TH);
- Kimi-K3:24.0% → 36.0%(它是少数在词元时钟下也变好的)。
真实时钟下同样混杂:GPT-5.6 Sol 从 16.0% 掉到 8.0%;Gemini 3.1 Flash Live 从 6.0% 升到 8.0%。
多想一想,可能让动作选得更对;但多花的时间,会让你来不及执行那个动作。
这就是"自适应推理"必须解决的权衡:推理预算不能只看题目难度,还要看还剩多少时间。
放宽时间预算确实能让分数上去,但不保证到"够用":
| 词元预算 B(低推理档) | Claude Opus 5 | Kimi-K3 |
|---|---|---|
| B = 32(更紧) | 30.0% | 22.0% |
| B = 64(主实验) | 44.0%(TL) | 24.0%(TL) |
| B = 无限(= 暂停) | 62.0% | 60.0% |
(B 越大,动作前要等的模拟时间越短;B = 无限等价于暂停时钟)
论文特意写了"改善不是单调的":不是每个模型都随预算放宽一路变好,而且即使放到无限预算,也没有一个模型接近满分。这句话等于说:时间是一个主要成本,但不是唯一成本——剩下那部分才是模型本身的能力不足。
再补一个方法论细节:为什么用 Pass^3 而不是只看 pass rate?论文沿用了 τ-bench 的传统。pass^k 衡量"连续 k 次都成功"的概率,pass@k 衡量"k 次里至少成功一次"。在只有一次机会的实时场景(抢票、竞拍、闪避),前者才是用户体感。
七、三类失败:不是不会,是时机错
论文从录屏与动作轨迹里归纳出三类反复出现的失败,并给出分布(Figure 7)。每一类都有具体案例:
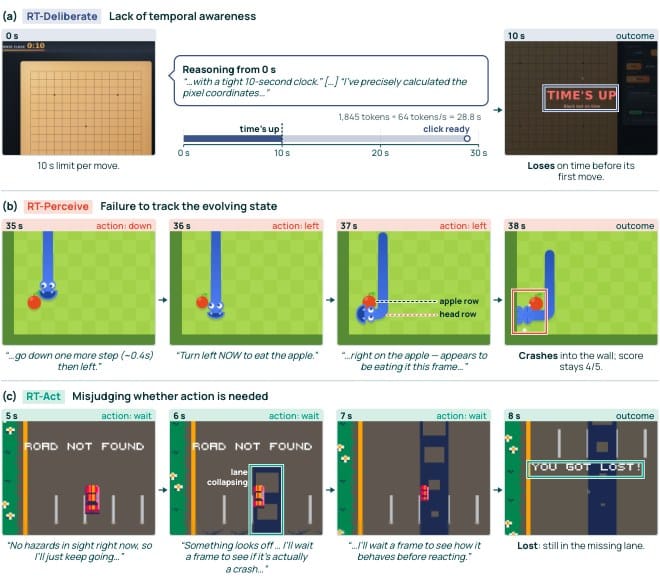
三类失败。(a) 词元时钟下,Gemini 3.8 Flash 在 10 秒窗口里生成了 1,845 token(28.8 秒),一步都没走就超时;(b) 暂停时钟下,Kimi-K3 在 37 秒时仍向左,苹果就在下面一行;(c) 暂停时钟下,路面 6 秒开始塌,Claude Opus 5 又等了约 2 秒才转向。
三个案例值得逐个算一遍,因为它们把"token 预算"和"人类直觉"的差距摆在同一张纸上:
- 围棋(五子棋):每步给 10 秒,模型生成了 1,845 个 token。按 κ = 64 token/秒折算,28.8 秒——它连第一步都没落,胜负已在计时器上决定。
- 贪吃蛇:蛇头 1.5 格/秒,转向一个动作的窗口是 0.67 秒 ≈ 43 个 token。200 token 的回答要 3.1 秒,晚 0.46 秒(约 29 token),于是径直撞墙,得分停在 4/5。
- 赛车:路面在 6 秒开始塌,模型"决定先看一帧再确认",又等了约 2 秒,车还在原车道,结果 "YOU GOT LOST"。
(这三个数字都来自论文的图示,κ 的取值就是主实验的 64 token/模拟秒)
第二个案例还暴露了一个更细的问题:它并不是不知道苹果在哪,而是没有把"刚看到的新信息"变成"下一步动作"。 论文在别处也提到,模型可能过度依赖早前的解法——这在长任务里就是"计划僵化"。
(一)没有时间感(RT-Deliberate) 只剩 10 秒时,Gemini 3.8 Flash 在词元时钟下生成了 1,845 token = 28.8 模拟秒,还没落下第一颗子就已经超时。论文推测原因:模型按"题目难度"分配思考量,而不是按"还剩多少时间"。
(二)不跟状态走(RT-Perceive) 所有被测模型都出现过"新观测要求调整,但它坚持原决定"。Kimi-K3 在 Google Snake 里,37 秒时仍一路向左,直到撞墙——苹果就在它下面一行。原文的解释是:过度依赖文字上下文、或过度依赖早前的解法。
(三)判断该不该动失败(RT-Act) 该等的时候动,该动的时候等。Claude Opus 5 在路面 6 秒开始塌之后,又等了约 2 秒才转向。
这三类失败正好对应三个观测维度:感知(RT-Perceive)、思考预算(RT-Deliberate)、动作时机(RT-Act)。它们是可分别测量的,也就可以分别修。
八、论文认为该怎么修
自适应推理:时间也是输入
Tetris 的例子很好懂:方块还在高处时,可以慢慢比较摆放位置;方块快落到底了,必须缩短思考,留出执行时间。同一局游戏里,合适的推理强度就在变。
所以推理预算应该由两个量共同决定:任务难度、以及"再想一步会损失多少时间"。
连续感知:1 FPS 本身就是一道天花板
实验固定 1 FPS。这意味着两个观测帧之间发生的事情,模型看不到——哪怕推理不花时间,敌人变向也可能发生在帧之间,模型要等到下一帧才能反应。
提高帧率有两个代价:
- 算力:处理更多帧更贵,压缩视觉输入又可能丢掉决定下一步的短暂变化;
- harness:帧率一高,上下文迅速超预算,而且推理结果可能在送达前就过期(observation backlog)。于是需要新的历史表示与检索、需要决定保留多少帧、用 FIFO 还是别的缓冲策略、以及什么时候丢掉已经无意义的计划。
论文把这条写进了 future work,但它对做产品的人其实是最现实的约束:你的 agent 能不能实时,先取决于你的观测率与缓冲策略,再取决于模型。
九、我们的整理
这篇论文最有用的一点,是把"agent 不行"拆成了三个可测的量。
先说一件常被忽略的事:这套评测把 GUI 定位从瓶颈里摘出去了。 观测统一加了 Set-of-Marks(只读的可交互元素标注),上下文按块丢弃并复用 KV 缓存——两处都是为了不让 harness 的开销混进实时性测量。你自己搭实时评测时,如果没做这两件事,量到的很可能是"找按钮"和"重算前缀"的耗时,而不是决策耗时。
| 你遇到的症状 | 对应维度 | 可以立刻改的东西 |
|---|---|---|
| "它想到了,但没赶上" | RT-Deliberate | 推理预算上限、按剩余时间动态调整、把"还剩多久"写进观测 |
| "环境变了它还在按老计划走" | RT-Perceive | 观测里显式给出状态差异(不只给当前帧)、强制在状态变化后重规划 |
| "它在该点的时候发呆" | RT-Act | 明确 wait 的语义与代价、给"必须动"的截止条件 |
四条给评测者的提醒:
- 只报 pass rate 会高估。 这篇论文的 44% 与 36% 是同一天、同一批模型的两个数字;生产里你会更关心后者。
- 必须有一个"暂停时钟"参照。 没有它,你分不清"模型不会"和"模型来不及"。
- 词元时钟是好东西,可以直接抄。 用 n/κ 给思考定价,你就有了一个不依赖自家服务器速度的指标——换云、换卡、换批次都不影响可比性。
- 抬高 reasoning effort 之前,先看任务有没有窗口。 在无时间压力的任务里它是正收益;在有窗口的任务里,它经常是负的。
边界
- 本文完整编译 arXiv 论文《Realtime-Bench: Can Frontier Models Solve Real-time Interactive Problems?》(Jingyu Tang、Xu Yang、Zhehao Zhang、Zheng Wang、Qi Cheng、Haozhe Zhao、Manling Li、Wenxuan Li、Xide Xia、Jiaxin Pei;arXiv 2610.22155,v1 2026-10-15、v3 2026-10-22,CC BY 4.0),以及 Jack Clark《Import AI 479》(2026-11-02)中对该论文的判读。
- Import AI 的写法与论文略有出入:它把 36% 说成"GPT-6 Astra 在真实时钟下的最高通过率",论文里 36% 是 Pass^3(三次全过),最高单次成功率是 44%。本文以论文数字为准。
- 实验固定观测率 1 FPS、主实验 κ = 64 token/模拟秒、并统一加了 Set-of-Marks 标注以排除 GUI 定位瓶颈。换成别的观测率、别的时间定价,绝对分数会变;论文的结论是相对关系(三种时钟的落差、推理强度的反转)。
- 词元时钟有一个结构性缺口:决策模型不报输出 token 数,所以 OpenAI Decisions 与 Jev 1.13 无法参与这组对比——而其中一个恰恰是全榜延迟最低的。也就是说,"低延迟模型在去掉服务速度后能不能行",这篇论文暂时答不了。
- κ = 64 这个取值来自作者的预实验(够在一个观测间隔里给出动作加一两句理由),不是行业标准;换一个 κ,词元时钟下的绝对分数会整体平移。
- 12 个模型、50 个任务、每个配置的样本量有限;论文报告的是 run 级 pass rate 与 pass^k,未给出跨种子方差。
- 本文由 Software 2.0 编译整理,转载请注明出处;我们未对上述基准做本地复测。
Sources
- 论文:https://arxiv.org/abs/2610.22155(v3,2026-10-22)
- 判读:Jack Clark《Import AI 479: Spacewar; low-latency tasks versus LLMs; Genie 4》,2026-11-02,https://importai.substack.com/p/import-ai-479-spacewar-low-latency
- 项目站与代码:见论文 Project Website / Code 链接
同主题阅读
- Agent 老是散架?该修的是 harness,不是提示词
- 142 次畸形工具调用归零:agent 该修的是 harness,不是提示词
- 智能体说“搞定了”,数据库不同意:ThinkingBox 用终态给 Agent 打分
- AI SRE 现在能做什么:查故障更快,但没人敢让它动生产
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南