
DATASET
基于CrewAI的合成数据生成
本文介绍了一个使用 CrewAI 代理生成合成数据的综合框架。通过模拟基于代理的交互,CrewAI 使我们能够生成针对特定任务量身定制的真实数据集,从而显著提高机器学习模型的性能。
DATASET
本文介绍了一个使用 CrewAI 代理生成合成数据的综合框架。通过模拟基于代理的交互,CrewAI 使我们能够生成针对特定任务量身定制的真实数据集,从而显著提高机器学习模型的性能。

TOOL
FragenAntwortLLMCPU是一个低成本的库,它不需要 GPU 来通过生成 JSON 格式的问答 (QA) 集来促进微调 LLM 过程的初始步骤。 FragenAntwortLLMCPU仅使用 CPU。

DATASET
本文介绍了如何使用 NVIDIA NIM 微服务 和NVIDIA Omniverse Replicator为 USD 构建自定义合成数据生成 (SDG) 管道。
LIBRARY
Firecrawl 是一个以 REST API 形式公开的网络抓取引擎。你可以通过 cURL 从命令行使用它,也可以使用 Python、Node、Go 或 Rust 语言 SDK 之一使用它。

DATASET
本文介绍如何使用 Grounding DINO、SAM 和 AutoDistill 等模型/工具自动生成图像数据集的标注数据。
DATASET
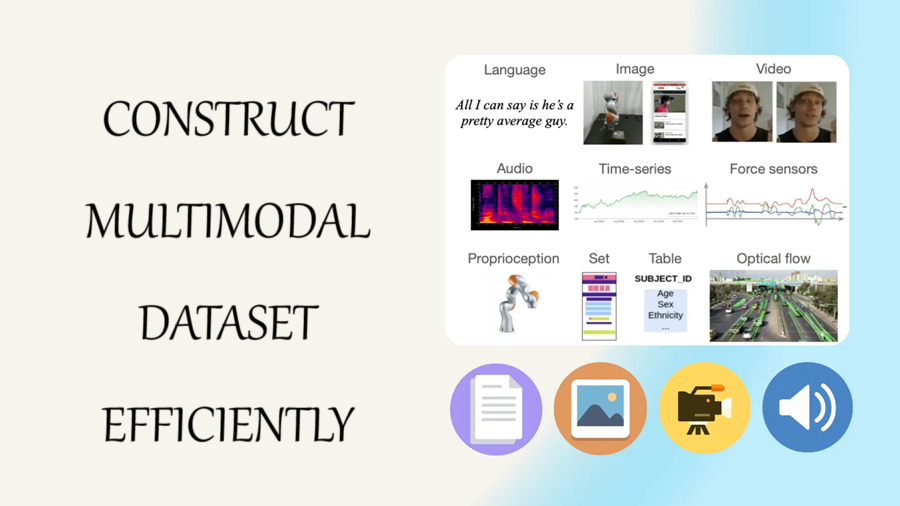
本文介绍一个生成多模态数据集的管道。该管道的主要目标是无需人工标注即可工作。

DATASET
本文介绍有关如何使用 LLM 生成合成数据集(例如,可用于评估 RAG 管道)的所有知识。

DATASET
本文收集了10个最好的多模态数据集以及这些数据源的链接。这些数据集对于多模态深度学习至关重要。

LIBRARY
Crawl4AI 是一个创新的开源 Python 库,旨在简化网络爬虫和数据提取,使其成为开发人员和人工智能爱好者的必备工具。
MODEL-ZOO
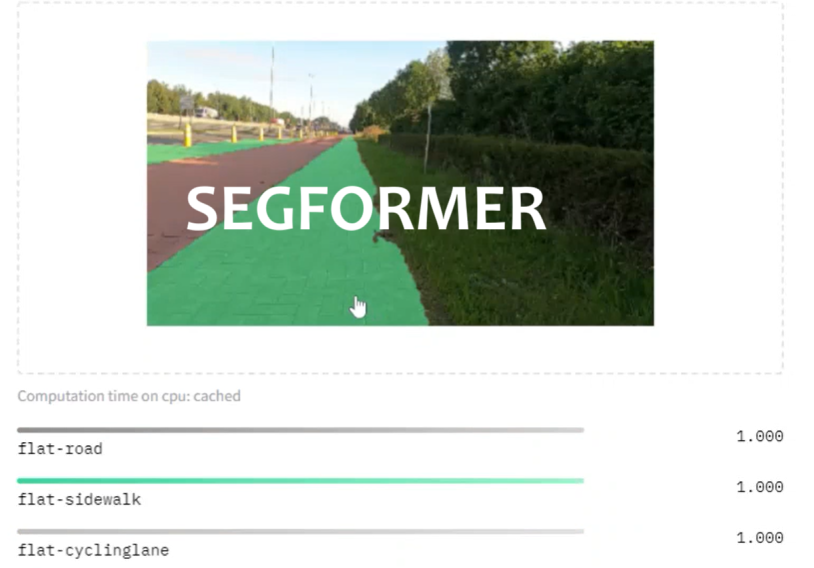
本指南展示了如何微调 Segformer,这是一种最先进的语义分割模型。我们的目标是为披萨送货机器人建立一个模型,这样它就可以看到要行驶的方向并识别障碍物 🍕🤖。 我们将首先在 Segments.ai 上标记一组人行道图像。然后,我们将使用 🤗 transformers 微调预先训练的 SegFormer 模型,transformers 是一个开源库,提供最先进模型的易于使用的实现。在此过程中,我们将学习如何使用 Hugging Face Hub,这是最大的开源模型和数据集目录。 语义分割是对图像中的每个像素进行分类的任务。你可以将其视为对图像进行更精确分类的方法。它在医学成像和自动驾驶等领域有广泛的用例。例如,对于我们的披萨送货机器人来说,重要的是要确切地知道人行道在图像中的位置,而不仅仅是是否有人行道。 因为语义分割是一种分类,所以用于图像分类和语义分割的网络架构非常相似。 2014 年,Long 等人发表了一篇开创性的论文,使用卷积神经网络进行语义分割。 最近,Transformers 已用于图像分类(例如 ViT),现在它们也用于语义分割,进一步推动了最先进的技术。

TOOL
本文是我对一些最有用、最有趣或最独特的合成数据生成式AI工具的总结,这些工具旨在创建合成数据,包括免费和付费工具。

DATASET
数据可视化不仅是一种强大的工具,可让数据科学家和分析师以易于理解的格式传达复杂的见解和发现,而且它也是希望进入该领域并展示新学到的技能的有抱负的数据科学家/分析师的第一步。 但还有另一件重要的事情需要考虑——数据集的选择。为数据可视化选择正确的数据集对于任何数据可视化项目的成功都至关重要——它可能意味着提供引人入胜的叙述或失败之间的区别。 但这就是我们来到 ODSC 的原因!让我们来看看各个领域的最佳数据可视化数据集列表,它们非常适合增强你的数据可视化项目并让你的数据故事栩栩如生,甚至只是帮助你丰富你的投资组合。 政府和开放数据源 1、美国政府开放数据 作为最全面的政府数据存储库之一,data.gov 提供多个领域的数据集,包括农业、气候、教育和健康。该平台对于政策分析、经济可视化和公共部门项目特别有用,使用户能够探索美国政府格局中的趋势和见解。这些数据可视化数据集非常多样化,为新手和高级数据科学家提供了大量主题选择。 2、世界银行开放数据 对于那些对全球发展感兴趣的人,世界银行开放数据平台提供了有关健康、教育和经济指标等主题的大量数据集。它是可视化全球趋势和金融数据