MCP
MCP 工具该给几个?1,932 次实测:准确率不降,成本看客户端
MCP 工具该给几个?1,932 次实测:5→100 个准确率一次没掉,唯一 89% 出在 Gemini 的分组工具;成本上,装载方式比数量更关键。
MCP
MCP 工具该给几个?1,932 次实测:5→100 个准确率一次没掉,唯一 89% 出在 Gemini 的分组工具;成本上,装载方式比数量更关键。
AI 编程
把重构交给 Agent 跑六天,代码确实是 Agent 写的;但人的时间并没有消失——它变成了两周设计、88 个必须回答的问题和 185 次"先例裁决",周一还有 63 个决策挤在同一小时里做完。本文完整编译 GoodBarber CTO 的自主循环复盘:569 个工作单元、五道互相印证的检查、从 1 到 20 的爬坡条件、单集成者的瓶颈曲线,以及五个真实翻车点(测试台说谎、Agent 绕过阻力、没人检查的规则被破坏)。
AI 编程
给 coding agent 派活时,最难的从来不是派出去,而是"派什么过去"。子代理拿到任务却没有背景,得重新发现 Node 版本、被 pin 的依赖和你说过的约束;而留在主上下文里的构建日志,又让窗口被 43K 的报错挤满。本文编译 Arthur 的 fork/fold 设计:已完成的工作折成一条 ~160 token 的 note,归档可回查;需要委派时让子代理继承父代理的当前视图。附三张成本账、缓存断点位置,以及作者自己承认"还没验证"的部分。
AI 编程
买席位省事,但代码、模型和预算都不在自己手里。OpenHands 的自托管把模型生成的每一步关进 Docker 沙箱,代价是 Docker socket、动态端口、镜像固定与清理都得自己扛;Munder Difflin 走另一条路——复用已付费的 CLI 与小时额度,用 git 文件当消息总线,用审批队列和熔断器控制自治。两条路线的架构、成本与决策清单,外加自己实现时的五个最小层。
AI 编程
一个开发者同时养 3–5 个 coding agent,难点从来不是模型,而是隔离、状态和协调。本文编译一套终端原生并行栈(worktree 隔离 + 状态感知的 tmux + 远程/手机审批),并给出三个硬数据:任务形状决定多 Agent 成败、编排可以把错误放大从 17.2 倍降到 4.4 倍、以及为什么"状态要比 Agent 活得久"。
AI Agent
"多 Agent 更强"这句话,在这项 50 个全栈应用的基准上只对一种组合成立。Vals AI 把 8 种设置各跑 50 个应用:团队成本 1.8–5.1 倍,唯一统计显著的涨分是 Sol 中等强度团队的 +7.3 分;Opus 得分最高的组合 $122/应用,领先不显著。两个 lead 的编排风格也完全不同。
合成数据
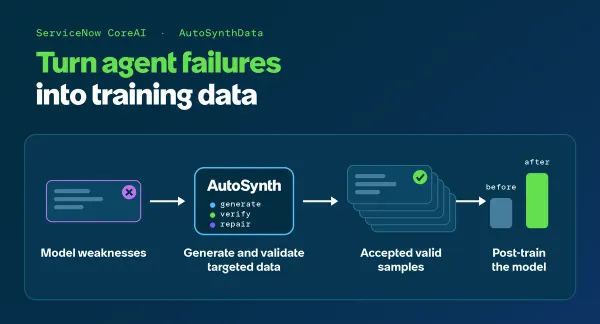
合成数据的难点不是"生成得像",而是"可执行、够真实、能被可靠判定、还刚好卡在模型能力边界上"。AutoSynthData 先用诊断任务找出目标模型的失败模式,用更强教师刻画解法,蒸馏出不含原始提示的能力规格卡,再并行生成核心任务(target)并扩增变体(multiply),逐个过正向/负向验证与批评修复,最后做批级覆盖度审查。EnterpriseOps Gym 实测:Hybrid 的 Pass@1 相对提升 35%,ITSM 从 18.77% 升到 27.18%。
MCP
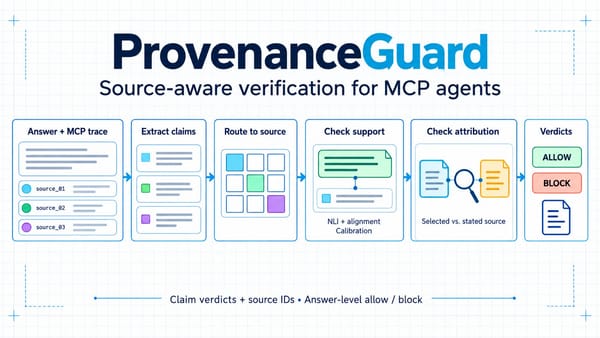
传统的忠实度检查(RAGAS / MiniCheck / AlignScore / SummaC)只问"证据池里有没有支撑";但 MCP Agent 会把搜索、病历、数据库、元数据的输出混在一起,于是"事实没错、来源错配"的 cross-source conflation 能轻松过关。ProvenanceGuard 保留来源身份贯穿整条流水线:专家判定应拦截的 139 条断言它拦下 138 条,来源选择准确率约 86%,在一项"来源调包"测试里 50 次全部检出。
编程助手
每个编程 Agent 见到你的项目都像陌生人:会话结束,推理就没了。funes 把 Agent 本机已有的会话轨迹建成记忆——单二进制、本地嵌入与重排、写入 Lance 数据集,一条 funes add 命令即可让 Claude Code / Codex / pi / Hermes 互相"记得"彼此的决策,并能发布成你私有的 Hugging Face 数据集跨机器跟随。实测中,recall 比手写交接便宜 4~8 倍,且是三种长会话出口里唯一两个任务都成功的。
梯形图
LAD 迁 SCL 的难点不是"翻译语法",而是扫描式的图形语义与顺序式的文本语义之间的差异:边沿检测、置位/复位、跳转、MCR、多重线圈直接照搬都会留下隐患。本文给出可执行路径:哪些结构能直接映射、8 类必须重构的语义坑、六步迁移流程与上线前验证清单。
AI 编程
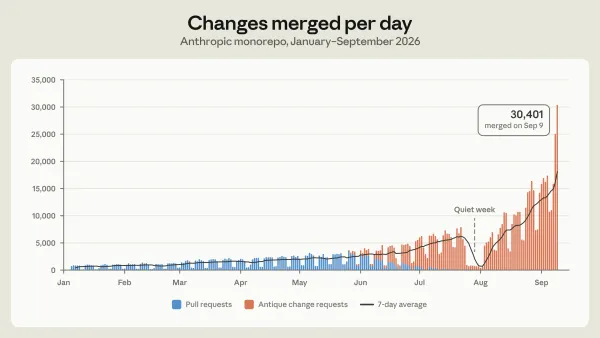
当 Claude 把写代码变成"不稀缺",稀缺的就成了源代码控制、CI 这些为人规模设计的基础设施。Anthropic 日均合并量 4 个月涨了 12 倍,git 镜像上百个也顶不住,于是自研 Scion 并在 5 个月完成迁移:CPU/内存占用降到 1/200,checkout 从分钟级变秒级。本文完整编译其架构与经验,包括"工程师最常做的是对 Claude 说不"。
LLM 评测
同一个模型、同一个基准,换一套评测协议或推理预算,分数就可能不一样——这就是评测报告的"不可复现"问题。UK AISI 加入了 EvalEval 的共享基建:用 Every Eval Ever 规范和 Evaluation Cards 公开 5 个基准、6 个前沿模型的验证结果与方法细节。本文完整编译:HLE 随 token 预算变化的曲线、Terminal-Bench 2.0 的跨设置对比,以及参与方式。