AI 评测
便宜模型先筛,贵模型兜底:同样准,成本只有 1/4
决策模型便宜 90 倍,但难样本上掉 6 个百分点。分水岭不在模型,在置信度校准:让 Jev 先筛、只把 30–90% 的模糊样本丢给 Opus,精度追上 Opus,钱花一半。
AI 评测
决策模型便宜 90 倍,但难样本上掉 6 个百分点。分水岭不在模型,在置信度校准:让 Jev 先筛、只把 30–90% 的模糊样本丢给 Opus,精度追上 Opus,钱花一半。
AI 编程
一周 12 亿次提交,你没快 400%——增长卡在评审那 441%。四个阶段,四张清单,说清哪些活交给 agent、哪些判断必须留给人。
PLC
我劝你先别写那份说明。三页纸讲不清一套老程序,五张表可以,还能被抽查。
EmbeddingGemma
174MB 的模型在 CPU 上就能给出带概率的选择。能替的是"哪个最像",替不了"算一步"——这是复现之后最清楚的一条线。
AI 视频生成
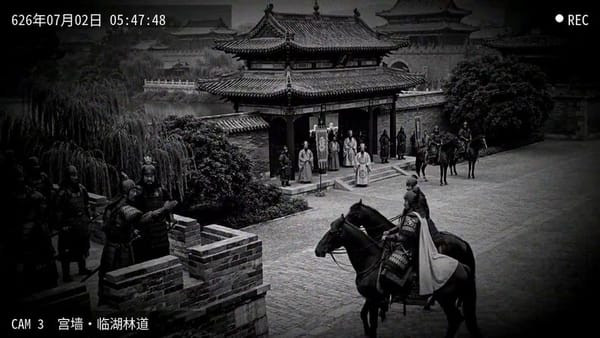
玄武门监控片里最像监控的三样东西——时间戳、REC、机位标签——都不是模型画的。同一条命令我们把清明上河图也变成了一段监控。
AI 安全
AI 把"繁琐但能做的推理"变成了流水线,于是 40 年攒下的旧代码集中暴露;修补那一侧还是人的活,而且要保证"攻击面全关、功能不坏"。
工业 AI
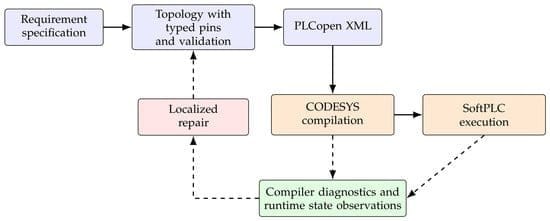
最狠的一条不是"修了多少",而是"编译通过"这个信号本身没有意义:12 个案例只在带接口检索时编得过,运行期还有 7/8 的缺陷编译时根本看不见。
工业 AI
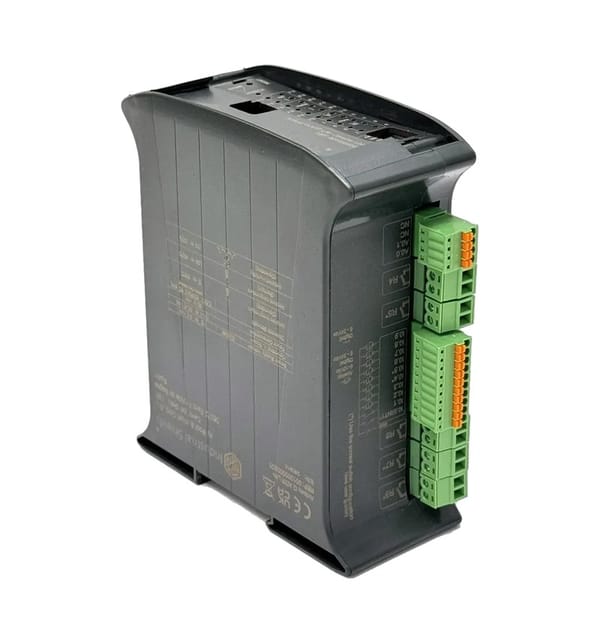
控制归 STM32,数据与模型归 Linux——两个处理器各干各的,一个挂了另一个还在跑。
工业 AI
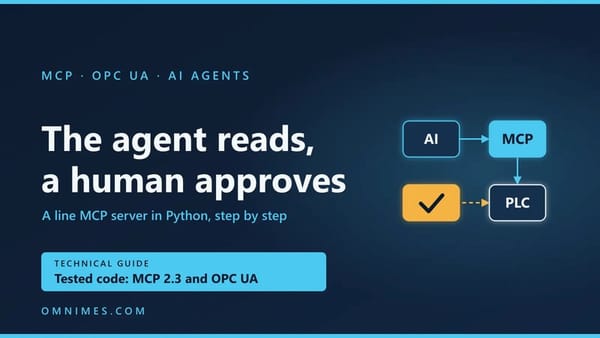
agent 能读产线数据这件事已经发生了;能不能写,取决于服务器代码里那几行限额,以及有没有人替它按下按钮。
AI Agent
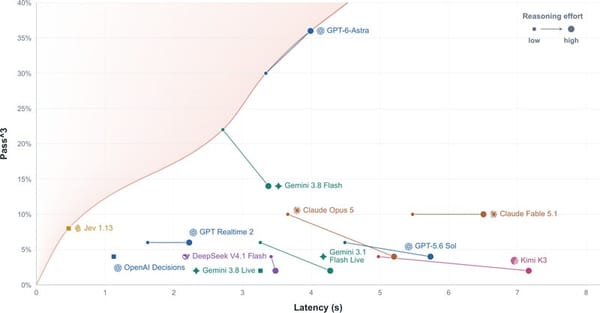
同一个模型、同一批任务,环境一暂停就能到 70%,环境一走就只剩 14%。这 56 个百分点的缺口不是知识,是预算与时机。
LLM
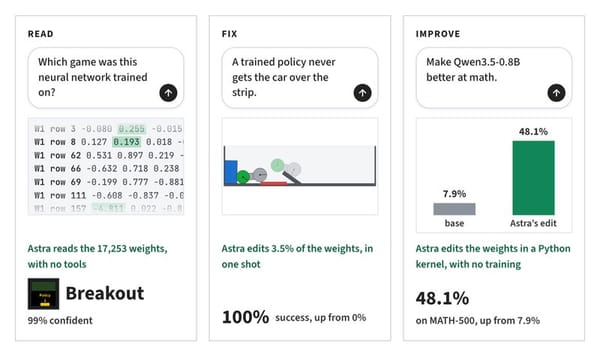
没有梯度,没有训练循环,只改 0.016% 的权重。它修好的是一个"会绕圈"的小模型,对不绕圈的模型则无能为力——这正好划出了能力边界。
AI Agent
一个助手把草稿发出去了。提示词里看不出问题,trace 里第一条就是。NVIDIA 的循环是:先找、再测、只改一处,然后在保留集上验收。